¿Funciona Replicate en China? Prompts, resultados, el registro de IA generativa y los datos transfronterizos
Replicate ejecuta y aloja modelos de ML abiertos a través de una API en el extranjero sin región en China continental, así que cada prompt, imagen, clip de audio, documento y resultado que envía es una transferencia transfronteriza según la PIPL — y una función pública de IA generativa en el continente necesita un registro ante la CAC. Un análisis, con el cumplimiento por delante, de la residencia, la puerta del registro y la vía legal en China.
¿Funciona Replicate en China?
Sea accesible o no, la pregunta decisiva es legal: cada prompt, imagen, clip de audio, documento y resultado generado que envía a Replicate sale del continente hacia infraestructura en el extranjero, y una función pública de IA generativa orientada a China construida sobre él necesita un registro ante la CAC.
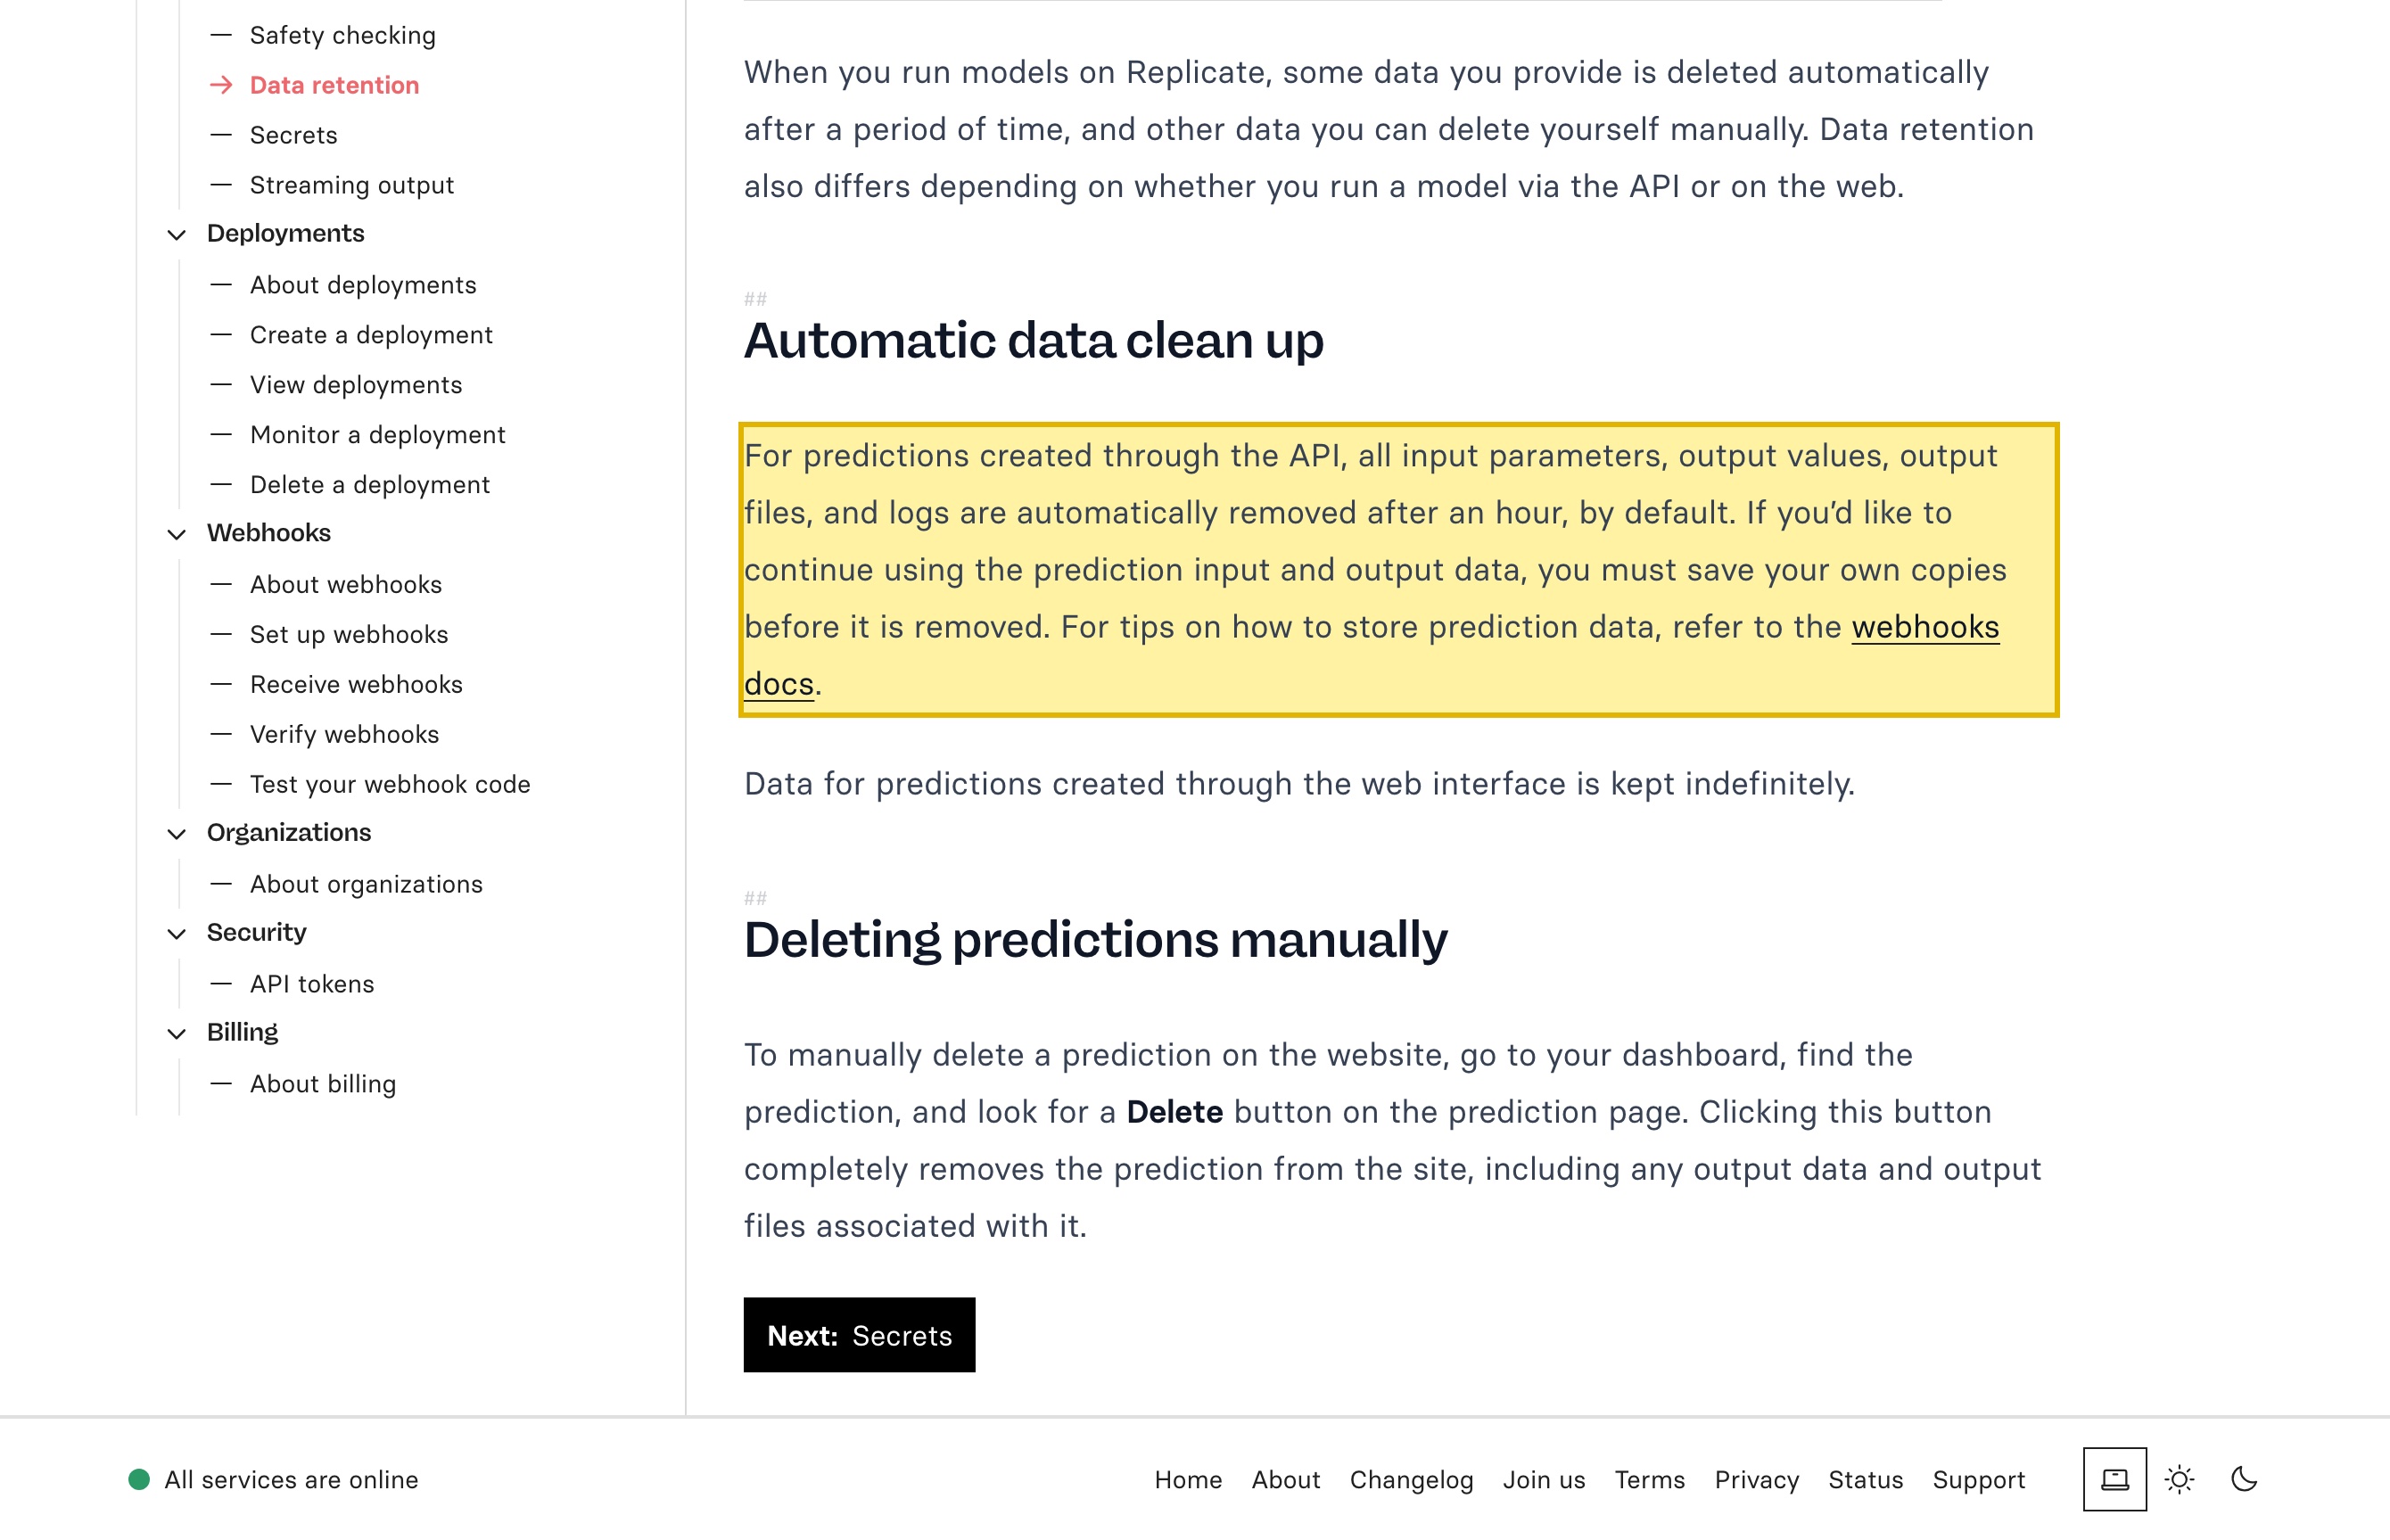
Replicate no opera ninguna región en China continental — su propia documentación dice que las entradas, los resultados y los registros de la API se eliminan “automatically removed after an hour, by default” (automáticamente al cabo de una hora, por defecto), mientras que las ejecuciones de la interfaz web se “kept indefinitely” (conservan indefinidamente), todo ello en infraestructura en el extranjero (ahora la de Cloudflare, tras la adquisición de 2025). Enviar allí prompts, imágenes de referencia, datos de ajuste fino o código fuente es una transferencia transfronteriza según la PIPL (artículos 38–40), y esas entradas llevan habitualmente datos personales, secretos comerciales y, a veces, datos sensibles (artículo 28). Por otra parte, ofrecer una función pública de IA generativa a usuarios del continente depende del registro conforme a las Medidas Provisionales para la Gestión de los Servicios de IA Generativa y del etiquetado de contenido generado por IA — un deber que recae sobre usted, no sobre Replicate.
Esto es un mapa de riesgo, no un dictamen: concrete los detalles con asesoría legal cualificada. Nuestro equipo de China puede cartografiar su exposición →
Instantánea de cumplimiento
- ✕ No existe ninguna región ni endpoint en China continental que seleccionar — la inferencia de Replicate se ejecuta en el extranjero.
- ! Prompts, imágenes, audio, documentos, datos de ajuste fino y los resultados cruzan la frontera hacia Replicate — una transferencia según la PIPL (artículos 38–40).
- ! Las entradas, los resultados y los registros de la API quedan en infraestructura en el extranjero ~1 hora por defecto; las ejecuciones de la consola web se conservan indefinidamente (documentación de Replicate).
- ! Una función pública de IA generativa en el continente necesita un registro ante la CAC + etiquetado de contenido generado por IA — un deber suyo, no de Replicate.
- ! Los rostros, documentos de identidad, datos financieros, de salud o de menores en un prompt son información personal sensible (PIPL artículo 28).
- ✓ 21YunBox localiza en un modelo nacional o soberano registrado ante la CAC (o en un modelo abierto autoalojado) y lo entrega sobre infraestructura dentro del país con registro ICP.
Lo que la documentación oficial de Replicate dice sobre China
| Hecho | Fuente primaria |
|---|---|
| Replicate guarda los datos de sus ejecuciones en infraestructura en el extranjero — brevemente en la API, indefinidamente en la web. Su documentación de conservación de datos indica que, para las predicciones por API, “all input parameters, output values, output files, and logs are automatically removed after an hour, by default,” (todos los parámetros de entrada, valores de salida, archivos de salida y registros se eliminan automáticamente al cabo de una hora, por defecto), mientras que “Data for predictions created through the web interface is kept indefinitely.” (los datos de las predicciones creadas a través de la interfaz web se conservan indefinidamente). En ambos casos, sus entradas y los resultados generados se tratan y almacenan fuera de China continental. | Replicate Docs — Data retention (consultado el 2026-10-10) |
| Replicate es un servicio regido por la ley de EE. UU. sin región ni entidad en China continental. Sus Condiciones de Servicio se rigen por las leyes del Estado de California (“governed by the Laws of the State of California”), con los litigios sometidos a San Francisco, y su política de privacidad presenta a Replicate como “processor” (encargado del tratamiento) según la legislación estatal de privacidad de EE. UU. A finales de 2025, Cloudflare anunció la adquisición de Replicate; el servicio continúa con la marca Replicate sobre infraestructura en el extranjero, sin ninguna región en China continental que seleccionar. | Condiciones de Servicio y Política de Privacidad de Replicate (consultado el 2026-10-10) |
| Enviar prompts, datos de ajuste fino o código fuente a un modelo en el extranjero es una transferencia transfronteriza de datos personales. Según los artículos 38 a 40 de la PIPL, el responsable del tratamiento debe notificar, obtener un consentimiento separado y utilizar un mecanismo de transferencia — una evaluación de seguridad de la CAC, el contrato estándar de la CAC o una certificación. Cuando un prompt lleva rostros, documentos de identidad, datos financieros, de salud o de menores, las reglas de información personal sensible del artículo 28 de la PIPL añaden más deberes. | Ley de Protección de Información Personal (PIPL), artículos 28 y 38–40 |
| Una función pública de IA generativa en el continente necesita un registro ante la CAC — y lo presenta usted, no Replicate. Las Medidas Provisionales para la Gestión de los Servicios de IA Generativa de China (生成式人工智能服务管理暂行办法, CAC, en vigor desde el 15 de agosto de 2023) regulan la oferta al público en China de texto, imágenes, audio o vídeo generados — registro de algoritmos y deberes de seguridad de contenidos —, y las normas chinas de 2025 sobre el etiquetado de contenido generado por IA añaden etiquetas visibles. La obligación recae sobre el operador que sirve la función. | Medidas Provisionales para la Gestión de los Servicios de IA Generativa (CAC, en vigor desde el 2023-08-15) |
Fuentes verificadas por el Equipo de Cumplimiento de 21YunBox el 10 de octubre de 2026.
Para un producto dirigido a China continental, la primera pregunta sobre Replicate no es si la API responde — casi siempre lo hará. Es si los datos que le entrega pueden salir legalmente del país, y si la función que construye encima necesita el visto bueno de un regulador chino. Replicate ejecuta y aloja modelos abiertos de aprendizaje automático — de imagen, vídeo, audio y lenguaje — detrás de una API en el extranjero, sin ninguna región en China continental que seleccionar. Todo lo que le envía es contenido: prompts, imágenes de referencia, clips de audio, documentos y contexto recuperado para RAG, datos de ajuste fino y el código fuente empaquetado en el contenedor Cog de un modelo — más las imágenes, el vídeo, el audio y el texto que genera de vuelta. Esa carga lleva habitualmente datos personales, y a menudo secretos comerciales y credenciales. A finales de 2025, Cloudflare anunció la adquisición de Replicate; el servicio continúa con el nombre de Replicate, todavía sobre infraestructura en el extranjero. Así que la decisión es de cumplimiento, y tiene dos puertas.
Replicate en China de un vistazo
| Qué lo decide | En los propios términos de Replicate — y la ley china |
|---|---|
| Dónde se ejecuta la inferencia | En el extranjero, sin ninguna región en China continental que seleccionar. Las Condiciones de Servicio de Replicate se rigen por las leyes del Estado de California (“governed by the Laws of the State of California”); desde la adquisición por Cloudflare en 2025, el servicio alojado funciona sobre la red global de Cloudflare — un borde mundial, no una región de inferencia china registrada ante la CAC. |
| Qué le envía | Prompts, imágenes de referencia, audio, documentos y contexto para RAG, conjuntos de datos de ajuste fino y el código fuente del contenedor Cog de un modelo — más los resultados generados. Son datos personales, y a menudo secretos comerciales y credenciales; los rostros, documentos de identidad, datos financieros, de salud o de menores los convierten en información personal sensible según el artículo 28 de la PIPL. |
| Los prompts de sus usuarios y su código | Cada llamada saca esa carga del continente hacia un modelo en el extranjero, así que es una transferencia transfronteriza de datos personales según la PIPL (artículos 38–40): notificación, un consentimiento separado y un mecanismo de transferencia. La documentación de Replicate muestra que las entradas, los resultados y los registros de la API se conservan alrededor de una hora por defecto; las ejecuciones de la consola web, indefinidamente. |
| Una función pública de IA generativa en el continente | Ofrecer al público en China texto, imágenes, audio o vídeo generados depende de las Medidas Provisionales para la Gestión de los Servicios de IA Generativa (生成式人工智能服务管理暂行办法, CAC, en vigor desde el 15 de agosto de 2023) — registro de algoritmos y deberes de seguridad de contenidos, más el etiquetado de contenido generado por IA conforme a las normas de 2025. El deber es del operador — usted —, no de Replicate. |
| El eje decisivo | No si el endpoint responde, sino si los datos pueden salir legalmente de China y si su función pública está registrada. La superficie orientada a China que la lleva — la aplicación, la interfaz de chat, el borde de la API que usan sus usuarios — conlleva además un deber de registro ICP (备案). |
Sin región en el continente, sus prompts, imágenes y datos salen del país
Replicate no ofrece ninguna región en China continental, y nada en su documentación permite fijar la inferencia en suelo chino. Sus Condiciones de Servicio se rigen por las leyes del Estado de California (“governed by the Laws of the State of California”), con los litigios sometidos a San Francisco; su política de privacidad describe a Replicate como “processor” (encargado del tratamiento) según la legislación estatal de privacidad de EE. UU. Desde la adquisición por Cloudflare en 2025, está previsto que el servicio alojado funcione sobre la red global de Cloudflare — un borde mundial, no una región de inferencia china registrada ante la CAC. Llegue como llegue a él, el modelo se ejecuta fuera del continente.
Eso importa porque los datos no se limitan a pasar. La propia documentación de conservación de datos de Replicate indica que, para las predicciones creadas a través de la API, “all input parameters, output values, output files, and logs are automatically removed after an hour, by default,” (todos los parámetros de entrada, valores de salida, archivos de salida y registros se eliminan automáticamente al cabo de una hora, por defecto), y que “Data for predictions created through the web interface is kept indefinitely.” (los datos de las predicciones creadas a través de la interfaz web se conservan indefinidamente). Dicho de otro modo, sus entradas y los resultados generados se tratan y almacenan en infraestructura en el extranjero — brevemente en la API, indefinidamente en la consola web — antes de que se aplique cualquier decisión de conservación propia. Llegar al endpoint nunca fue lo difícil; lo difícil es mantener los datos sobre una base legal.
Lo que le envía son datos personales
Es fácil imaginar una llamada a un modelo como texto anónimo, pero fíjese en lo que realmente cruza la frontera. Los prompts y los turnos de chat contienen nombres, datos de contacto, números de pedido y de cuenta, y cualquier cosa que un usuario pegue. Las imágenes y los vídeos de referencia llevan rostros; el audio lleva huellas de voz; los documentos subidos y los corpus de RAG llevan registros de clientes y material interno. Los conjuntos de datos de ajuste fino son, por construcción, una exportación concentrada justo de los datos que usted más quiere conservar. Y, para los equipos que integran Replicate en una cadena de compilación, el código fuente y la configuración empaquetados en un contenedor Cog pueden llevar secretos, credenciales y lógica propietaria. Todo ello son datos personales — y a menudo secretos comerciales — en el momento en que salen de China hacia un modelo en el extranjero.
Cuando esa carga incluye rostros, documentos de identidad, datos financieros o de salud, o cualquier cosa sobre menores, es información personal sensible según el artículo 28 de la PIPL, lo que vuelve a subir el listón: un propósito específico, estricta necesidad y un consentimiento separado y reforzado. No encontramos ninguna declaración de Replicate de que entrene sus propios modelos con sus entradas — la exposición aquí no es un uso para entrenamiento por defecto, sino la propia transferencia y el tiempo que los datos permanecen en el extranjero (indefinidamente en las ejecuciones de la consola web, según la propia documentación de Replicate). Recortar lo que envía ayuda; no cambia el hecho de que salió del país.
La puerta del registro — y por qué recortar la conservación no la cierra
Suponga que resuelve la ingeniería y pone un botón de «generar», un asistente o una función de voz delante de usuarios del continente. Se abre una segunda puerta que no tiene nada que ver con la disponibilidad de Replicate. Ofrecer al público un servicio de IA generativa dentro de China depende de las Medidas Provisionales para la Gestión de los Servicios de IA Generativa (生成式人工智能服务管理暂行办法, Administración del Ciberespacio de China, en vigor desde el 15 de agosto de 2023): obligaciones sobre los datos de entrenamiento y la seguridad de los contenidos, un registro de algoritmos para los servicios capaces de influir en la opinión pública y — según las normas chinas de 2025 sobre el etiquetado de contenido generado por IA, en vigor desde el 1 de septiembre de 2025 — etiquetas visibles en las imágenes, el vídeo, el audio y el texto generados. Si su función clasifica o recomienda lo que sirve, también puede aplicarse el registro de las Disposiciones sobre Recomendación Algorítmica. Estos deberes recaen sobre el operador que sirve la función al público chino — usted —, no sobre el proveedor de la API, que no registra nada de esto en su nombre. La superficie orientada a China que la lleva — la aplicación, la ventana de chat, el borde de la API que usan sus usuarios del continente — conlleva además un deber de registro ICP (备案).
Por eso una configuración de conservación cero o el valor por defecto de una hora de la API de Replicate no cierran la puerta. Esos controles reducen lo que cruza y cuánto tiempo permanece; no cambian que haya cruzado. La transferencia transfronteriza según la PIPL y el deber de registro de IA generativa no se ven afectados por una ventana de conservación más corta. Cuando los datos personales o los datos importantes deben permanecer en China — para un operador de infraestructuras de información críticas —, el artículo 39 de la Ley de Ciberseguridad (antes artículo 37) impone un deber de localización de datos que un modelo en el extranjero no puede cumplir; la reforma de la Ley de Ciberseguridad de 2025, en vigor desde el 1 de enero de 2026, renumeró el artículo de localización de datos del 37 al 39, sin cambios de fondo. Nada de esto es un dictamen sobre su desarrollo concreto: trátelo como un mapa de exposición y concrete los detalles con asesoría legal china cualificada frente a lo que realmente lance.
La vía legal — cartografiar, localizar, entregar
Existe una forma legal de poner resultados de modelos al estilo de Replicate delante de usuarios en China, y no depende de nada ilícito. Como Replicate aloja modelos abiertos empaquetados como contenedores Cog, rara vez queda atado a un único endpoint en el extranjero — y esa es la oportunidad. El equipo de China de 21YunBox hace tres cosas. Cartografiamos su exposición: la posición transfronteriza y de información personal sensible según la PIPL, los deberes de registro y etiquetado de IA generativa y la obligación de ICP, contrastados con su entidad, sus volúmenes de datos y quiénes son sus usuarios. Localizamos la llamada al modelo que no puede servirse legalmente desde el extranjero — poniendo en marcha e integrando un modelo nacional registrado ante la CAC o un modelo de nube soberana dentro de China, o autoalojando el mismo modelo abierto dentro del país cuando su licencia lo permite, de modo que la generación que activan sus usuarios del continente ocurra sobre infraestructura china legal. Y entregamos la superficie orientada a China — la aplicación, la interfaz de chat, el borde de la API — sobre infraestructura dentro del país con registro ICP (el 21YunBox Optimizer), por delante del stack que ya utiliza, sin reconstruir y sin una segunda base de código.
La distinción lo es todo: localizar significa un modelo legal en China, no una ruta hacia el modelo en el extranjero. 21YunBox nunca utiliza ni sugiere ninguna forma de elusión. El resultado es una función de IA que funciona de forma legal y conforme para sus usuarios en China — una capa de cumplimiento sobre el stack que ya tiene, no una migración, y un socio de Replicate, no un competidor.
Solicitar una evaluación de cumplimiento →
Lectura relacionada:
- Las Medidas Provisionales para la Gestión de los Servicios de IA Generativa de China
- Transferencias transfronterizas de datos conforme a la PIPL
- Cómo obtener un registro ICP para China
- La Ley de Ciberseguridad de China — localización de datos (artículo 39)
Preguntas frecuentes
¿Está bloqueado Replicate en China?
La accesibilidad no es la pregunta decisiva, y no la planteamos en términos de «bloqueo». Replicate funciona sobre infraestructura en el extranjero sin región en China continental, así que, incluso cuando un endpoint responde, cada llamada lleva sus prompts y resultados a través de la frontera. Las cuestiones de cumplimiento — la transferencia transfronteriza según la PIPL y, para una función pública, el registro de IA generativa ante la CAC — son las que deciden si puede lanzar legalmente. 21YunBox nunca utiliza ni sugiere ninguna forma de elusión.
¿Llamar a la API de Replicate activa una transferencia transfronteriza según la PIPL?
Sí. Los prompts, las imágenes de referencia, el audio, los documentos, los datos de ajuste fino y el código fuente enviados a la inferencia de Replicate en el extranjero — y los resultados devueltos — salen del continente. Según los artículos 38 a 40 de la PIPL, el responsable del tratamiento (usted) debe notificar, obtener un consentimiento separado y establecer un mecanismo de transferencia; los datos sensibles en un prompt añaden los deberes del artículo 28. La propia documentación de Replicate muestra que las entradas y los resultados se almacenan en su infraestructura (en la API, alrededor de una hora por defecto; las ejecuciones web, indefinidamente).
¿Puedo poner legalmente una función de imagen o de chat basada en Replicate delante de usuarios del continente?
No llamando directamente al modelo en el extranjero para una función pública. Un servicio público de IA generativa en el continente depende de un registro ante la CAC conforme a las Medidas Provisionales para la Gestión de los Servicios de IA Generativa más el etiquetado de contenido generado por IA, y la superficie orientada a China necesita un registro ICP. Como los modelos de Replicate son abiertos y están empaquetados como contenedores Cog, la vía legal es localizar — ejecutar un modelo nacional o soberano registrado ante la CAC, o autoalojar el modelo abierto dentro del país cuando su licencia lo permite — y entregarlo sobre infraestructura con registro ICP. Sea cual sea la vía, Apple ahora comprueba el resultado: desde noviembre de 2026, App Store Connect exige que toda aplicación disponible en China continental declare si ofrece contenido generado por IA o sintético, y la verificación AIGC de Apple espera que un «Sí» vaya acompañado del número de registro aprobado por la CAC y del nombre registrado del modelo que usted realmente ejecuta, además de una autorización de su titular registrado si ese registro pertenece a otro. Trátelo como un mapa de riesgo y concrete los detalles con asesoría legal.


