Groq fonctionne-t-il en Chine ? Prompts, le dépôt IA générative et données transfrontalières
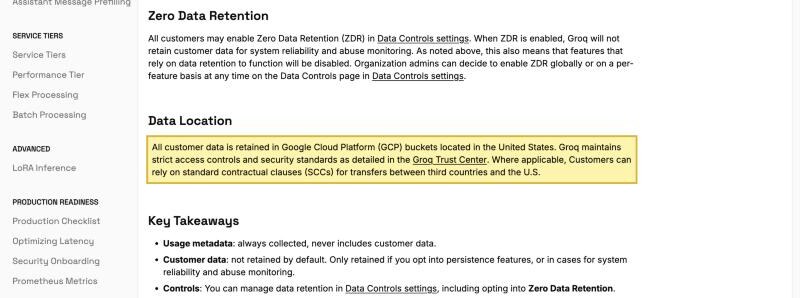
GroqCloud sert des modèles ouverts sur le matériel LPU de Groq basé aux États-Unis, et sa propre documentation place les données conservées dans des buckets US de Google Cloud sans région de Chine continentale — la décision n'est donc pas l'accessibilité. Chaque appel est un transfert transfrontalier PIPL, et une fonctionnalité d'IA générative publique sur le continent a besoin d'un dépôt auprès de la CAC. Un regard priorité à la conformité sur la résidence, le passage obligé du dépôt, et la voie IA légale en Chine.
Groq fonctionne-t-il en Chine ?
GroqCloud tourne sur du matériel basé aux États-Unis sans région de Chine continentale, de sorte que la question n'est pas de savoir si le point de terminaison répond — c'est de savoir si vos prompts et données peuvent légalement quitter la Chine, et si votre fonctionnalité IA publique a besoin d'un dépôt auprès de la CAC. GroqCloud sert des modèles ouverts via une API compatible OpenAI, et sa propre documentation place les données clients conservées dans des buckets US de Google Cloud ; l'atteindre depuis le continent envoie chaque prompt, document RAG, jeu de données de fine-tuning et ligne de code à l'étranger vers les États-Unis.
Parce que le modèle est hébergé dans une autre juridiction, la décision est une décision de conformité, non de vitesse. Chaque appel d'un utilisateur chinois est un transfert transfrontalier PIPL d'informations personnelles (souvent sensibles au titre de l'article 28), et offrir une fonctionnalité d'IA générative publique sur le continent dépend d'un dépôt auprès de la CAC au titre des Mesures provisoires pour la gestion des services d'intelligence artificielle générative — un dépôt que vous détenez, non le fournisseur d'API en amont. La Zero Data Retention et les contrôles de non-conservation par défaut de Groq réduisent ce qui est conservé, non le fait que les données ont franchi la frontière.
Ceci est une carte des risques, non une décision — réglez les détails avec un conseil chinois. Nous localisons votre fonctionnalité sur un modèle légal en Chine et la diffusons sur le territoire ; 21YunBox n'utilise ni ne suggère jamais aucun contournement, de quelque nature que ce soit. Notre équipe Chine peut cartographier votre exposition →
Aperçu de conformité
- ✕ Aucune région de Chine continentale ; la documentation de Groq place les données conservées dans des buckets US de Google Cloud
- ! Chaque prompt, document RAG, jeu de fine-tune et sortie envoyé à GroqCloud quitte la Chine (PIPL)
- ! Une fonctionnalité d'IA générative publique sur le continent a besoin d'un dépôt auprès de la CAC — vous le déposez, non Groq
- ! Les prompts avec données d'identité, financières, de santé ou biométriques sont une information personnelle sensible (PIPL art. 28)
- ! La Zero Data Retention rogne ce qui franchit & pour combien de temps, non le fait qu'elle a franchi la frontière
- ✓ 21YunBox cartographie l'exposition, localise un modèle domestique/souverain déclaré auprès de la CAC & le diffuse
Ce que la documentation officielle de Groq dit de la Chine
| Fait | Source primaire |
|---|---|
| GroqCloud stocke les données clients conservées dans des buckets US de Google Cloud, et il n'y a aucune région de Chine continentale. La documentation de données de Groq indique : “All customer data is retained in Google Cloud Platform (GCP) buckets located in the United States,” et que “By default, Groq does not retain customer data for inference requests.” Ce que Groq conserve se trouve aux États-Unis ; atteindre le modèle depuis la Chine envoie votre requête à l'étranger. | Groq — Your Data in GroqCloud (console.groq.com/docs/your-data), consulté le 2026-10-10 |
| Groq est une entreprise américaine qui traite les données aux États-Unis et dans d'autres juridictions mondiales — aucune en Chine continentale. Sa politique de confidentialité (en vigueur le 12 novembre 2025) indique que Groq “is located in the United States, and maintains processing operations in various global jurisdictions.” Les clients peuvent activer la Zero Data Retention, mais cela régit combien est conservé, non le fait que les données ont quitté la Chine. | Groq Privacy Policy, « Additional Information for International Users » (en vigueur le 12 novembre 2025), consulté le 2026-10-10 |
| Envoyer le prompt d'un utilisateur continental à GroqCloud aux États-Unis est un transfert transfrontalier d'informations personnelles au titre de la PIPL. Les articles 38 à 40 exigent une information, un consentement distinct, et un mécanisme de transfert — une évaluation de sécurité de la CAC, le contrat type de la CAC, ou une certification — avant que les données ne puissent quitter la Chine. Voir les transferts transfrontaliers de données au titre de la PIPL. | Loi sur la protection des informations personnelles (PIPL), articles 38 à 40 |
| Une fonctionnalité d'IA générative tournée vers le public pour des utilisateurs continentaux dépend d'un dépôt auprès de la CAC. Les Mesures provisoires pour la gestion des services d'intelligence artificielle générative (生成式人工智能服务管理暂行办法, en vigueur le 15 août 2023) exigent une évaluation de sécurité et un dépôt d'algorithme pour les services capables de façonner l'opinion publique, plus l'étiquetage du contenu généré par IA. L'obligation retombe sur la fonctionnalité que vous exploitez, non sur l'API américaine en amont. | Mesures provisoires pour la gestion des services d'intelligence artificielle générative (CAC, en vigueur le 2023-08-15) |
Sources vérifiées par Équipe Conformité 21YunBox le 10 octobre 2026.
Pour un produit visant la Chine continentale, la première question au sujet de Groq n’est pas de savoir si le point de terminaison de GroqCloud répond depuis Shanghai ou à quelle vitesse son matériel LPU renvoie les jetons en flux. C’est de savoir si les données que vous lui confiez peuvent légalement quitter le pays, et si la fonctionnalité IA publique que vous construisez par-dessus a besoin d’un dépôt avant de pouvoir faire face à des utilisateurs continentaux. GroqCloud sert des modèles ouverts tels que Llama via une API compatible OpenAI, et chaque appel porte une cargaison réelle : le prompt de l’utilisateur, tout document récupéré dans votre corpus RAG, des jeux de données de fine-tuning, le code source et les secrets qu’une fonctionnalité de code colle dedans, et la sortie générée par le modèle. Cette charge utile porte couramment des informations personnelles et souvent des secrets commerciaux. La propre documentation de Groq place les données clients conservées dans des buckets US de Google Cloud et ne nomme aucune région de Chine continentale — de sorte qu’atteindre le modèle depuis la Chine signifie envoyer cette charge utile à l’étranger.
Groq en Chine en un coup d’œil
| Ce qui le détermine | Dans les propres termes de Groq — et le droit chinois |
|---|---|
| Où tourne réellement l'inférence | GroqCloud tourne sur le matériel LPU propre de Groq, et sa documentation place les données clients conservées dans des “Google Cloud Platform (GCP) buckets located in the United States.” La politique de confidentialité de Groq indique que l'entreprise “is located in the United States.” Il n'y a aucune région de Chine continentale à sélectionner — atteindre le modèle depuis la Chine envoie votre requête aux États-Unis. |
| Ce que vous lui envoyez, et pourquoi c'est une information personnelle | Un prompt est rarement juste une question : il porte tout ce que l'utilisateur a tapé, téléversé ou collé, plus vos documents RAG, vos jeux de données de fine-tuning, et — pour une fonctionnalité de code — le code source et les secrets qu'il contient. C'est une information personnelle, et souvent des secrets commerciaux. Là où un prompt contient des données d'identité, financières, de santé, biométriques, ou celles d'un mineur, l'article 28 de la PIPL les traite comme une information personnelle sensible. |
| Les prompts ou le code de vos utilisateurs chinois = un transfert transfrontalier | Chaque appel d'un utilisateur continental vers GroqCloud aux États-Unis est un transfert transfrontalier d'informations personnelles au titre de la PIPL (articles 38 à 40) : il a besoin d'une information, d'un consentement distinct de l'accord pour utiliser la fonctionnalité, et d'un mécanisme de transfert légal — une évaluation de sécurité de la CAC, le contrat type de la CAC, ou une certification. |
| Le passage obligé du dépôt IA générative | Offrir une fonctionnalité d'IA générative tournée vers le public à des utilisateurs à l'intérieur du continent dépend des Mesures provisoires pour la gestion des services d'intelligence artificielle générative de la Chine (生成式人工智能服务管理暂行办法, CAC, en vigueur le 15 août 2023) — une évaluation de sécurité et un dépôt d'algorithme pour les services capables de façonner l'opinion publique, plus l'étiquetage du contenu généré par IA. Vous déposez pour la fonctionnalité que vous livrez ; le fournisseur d'API en amont ne la dépose pas pour vous. |
| L'accessibilité n'est pas l'axe | Même si le point de terminaison répond, ce n'est pas la décision — le transfert transfrontalier et le passage obligé du dépôt le sont. Et la surface tournée vers la Chine qui porterait la fonctionnalité (l'application, l'UI de chat, la périphérie d'API que vos utilisateurs continentaux atteignent) est elle-même un service public sur le continent, de sorte qu'elle porte une obligation de déclaration ICP (备案) et de diffusion sur le territoire qui lui est propre. |
Aucune région continentale, vos prompts et données quittent donc le pays
La position de Groq est fixée par l’endroit où il tourne, non par un test de temps de chargement. GroqCloud sert des modèles ouverts sur le matériel LPU propre de Groq, et la documentation de l’entreprise est explicite sur la résidence : les données clients conservées se trouvent dans des “Google Cloud Platform (GCP) buckets located in the United States,” et la politique de confidentialité de Groq indique que l’entreprise “is located in the United States, and maintains processing operations in various global jurisdictions.” Aucune de ces juridictions n’est la Chine continentale. Le point de terminaison développeur est une unique API mondiale ; l’atteindre depuis Shanghai ou Shenzhen ne place pas le modèle sur le territoire — cela envoie votre requête vers une infrastructure américaine.
Groq vend bien GroqRack, un cluster de calcul LPU sur site visant les acheteurs souverains et réglementés, et en principe ce matériel peut être implanté à l’intérieur d’un pays donné. Il vaut la peine d’être honnête sur ce que cela résout et ne résout pas : mettre du matériel sur le sol local est un ingrédient de résidence, non un verdict de conformité. Un service d’IA générative légal en Chine doit toujours être un service déposé, exploité par un opérateur qui détient les dépôts — l’emplacement du matériel seul ne crée pas cela. Pour cette raison, cette page ne publie aucun chiffre de latence Chine de première main pour GroqCloud : la vitesse est le mauvais axe pour un modèle hébergé dans une autre juridiction et offert via un point de terminaison mondial américain. La question productive est de savoir comment mettre l’IA générative devant des utilisateurs chinois légalement.
Ce que vous lui envoyez est une information personnelle
Une requête de complétion n’est pas un ping anonyme. Tout ce que vos utilisateurs tapent, collent ou téléversent l’accompagne, et tout ce que votre application y attache aussi : les passages récupérés dans un pipeline RAG, les enregistrements que vous injectez comme contexte, les jeux de données derrière un fine-tune, et — dans une fonctionnalité de code par IA — le code source, les clés d’API et les identifiants que ce code contient. Au titre de la loi chinoise sur la protection des informations personnelles, la plus grande partie en est une information personnelle, et le droit met l’obligation sur le responsable — vous, l’opérateur de la fonctionnalité — non sur le fournisseur du modèle. Là où un prompt porte un numéro de pièce d’identité, des détails financiers ou de santé, des données biométriques, ou les informations d’un mineur, l’article 28 de la PIPL les traite comme une information personnelle sensible, relevant la barre sur le consentement et la nécessité. Les secrets commerciaux dans un prompt ne sont pas le sujet de la PIPL, mais ils sont les vôtres à perdre dès l’instant où ils quittent le pays.
Les conditions de données de Groq aident en fait sur un point étroit, et il vaut la peine de le dire équitablement : sa documentation indique que GroqCloud ne conserve pas les données clients pour les requêtes d’inférence par défaut, offre une Zero Data Retention que les clients peuvent activer, et conserve les journaux de fiabilité et d’abus jusqu’à trente jours. C’est une posture authentique de minimisation des données. Mais cela répond à combien est conservé et pour combien de temps — non à savoir si les données ont franchi la frontière en premier lieu. Le transfert se produit à l’instant où la requête est envoyée aux États-Unis ; les réglages de conservation changent le résidu, non le franchissement. Pour un opérateur d’infrastructure d’information critique, l’obligation de localisation des données à l’article 39 (anciennement l’article 37) de la loi sur la cybersécurité — l’amendement 2025 de la loi sur la cybersécurité, en vigueur le 1er janvier 2026, a renuméroté l’article de localisation des données de 37 à 39, substance inchangée — exige que les informations personnelles et les données importantes soient stockées à l’intérieur de la Chine, une obligation que l’inférence hébergée aux États-Unis ne peut pas satisfaire.
Le passage obligé du dépôt — et pourquoi rogner la conservation ne ferme pas la porte
Supposez que la question des données soit traitée et que vous vouliez toujours un chatbot, un assistant, ou un bouton « générer » pour des utilisateurs continentaux. Un deuxième passage obligé s’ouvre, sans rapport avec la conservation : celui de savoir si vous pouvez offrir un service d’IA générative tourné vers le public en Chine tout court. Les Mesures provisoires pour la gestion des services d’intelligence artificielle générative de la Chine (生成式人工智能服务管理暂行办法, Administration du cyberespace de Chine, en vigueur depuis le 15 août 2023) régissent l’usage de l’IA générative pour fournir du contenu texte, image, audio et vidéo « au public » à l’intérieur du continent. Elles exigent, entre autres, une évaluation de sécurité et un dépôt d’algorithme pour les services capables de façonner l’opinion publique, et — au titre des règles d’étiquetage 2025 — un étiquetage clair du contenu généré par IA. Si votre fonctionnalité classe ou recommande aussi du contenu aux utilisateurs, les Dispositions sur la recommandation par algorithme ajoutent un dépôt qui leur est propre. Ces obligations s’attachent à la fonctionnalité publique que vous exploitez ; Groq, une API américaine en amont, n’en dépose aucune pour vous.
C’est pourquoi la Zero Data Retention, un plafond de journaux de trente jours, ou l’épinglage du stockage à une région particulière ne ferme pas la porte. Ces contrôles réduisent ce qui franchit et combien de temps une copie vit — réels et utiles — mais ils ne changent pas le fait que les données d’un utilisateur continental sont envoyées à l’étranger pour être traitées, et ils ne font rien pour l’obligation de dépôt, qui est déclenchée par l’offre du service au public, non par la façon dont vous stockez ses entrées. La résidence et le passage obligé du dépôt ne sont pas affectés par le rognage de la conservation. Rien de cela n’est une décision sur votre produit particulier : c’est une carte de l’endroit où se situe l’exposition. Réglez les détails — quelles obligations s’attachent, quel mécanisme de transfert convient, si votre fonctionnalité est dans le périmètre — avec un conseil chinois qualifié au regard de ce que vous livrez réellement.
La voie légale — cartographier, localiser, diffuser
Il existe une manière légale de mettre l’IA générative devant des utilisateurs chinois, et elle ne contourne rien de ce qui précède. Elle passe par un modèle servi depuis l’intérieur de la Chine par un opérateur détenant les dépôts, avec les données gardées sur une assise conforme. Deux schémas sont courants : un grand modèle domestique qui détient déjà le dépôt IA générative de la CAC, ou un modèle de cloud souverain en Chine exploité par un opérateur local licencié. Lequel convient dépend de votre cas d’usage, de vos données et de votre entité — confirmez-le avec un conseil et l’opérateur avant de construire.
Voici où 21YunBox s’inscrit — un overlay conforme et un partenaire de votre stack, jamais un concurrent de Groq. Notre équipe Chine fait trois choses. Nous cartographions votre exposition — la question transfrontalière PIPL, le fait que les Mesures sur l’IA générative atteignent ou non votre fonctionnalité, les obligations d’information personnelle sensible et de déclaration ICP — au regard de votre entité, de vos données et de qui sont vos utilisateurs. Nous localisons : nous mettons en place une voie IA légale en Chine — un modèle domestique déclaré auprès de la CAC ou un modèle de cloud souverain en Chine — et l’intégrons à la place de l’appel qui ne peut pas être légalement servi depuis les États-Unis, en gardant un traitement consenti, sur le territoire, pour ce qui doit rester sur le sol continental (et, là où un acheteur poursuit véritablement du matériel souverain tel que GroqRack, en l’associant à un modèle et un opérateur déposés de sorte que le matériel se trouve derrière un service légal, non seul). Et nous diffusons : toute surface tournée vers la Chine — l’application, l’UI de chat, la périphérie d’API que vos utilisateurs continentaux atteignent — tourne sur une diffusion déclarée ICP, sur le territoire, le 21YunBox Optimizer, devant le stack que vous exploitez déjà, sans reconstruction et sans seconde base de code.
Ce que nous ne faisons pas, et ce que personne ne peut faire légalement, c’est transformer un modèle hébergé aux États-Unis en un modèle continental. 21YunBox n’utilise ni ne suggère jamais aucun contournement, de quelque nature que ce soit. Nous localisons et diffusons un équivalent légal, de sorte que votre fonctionnalité IA tourne légalement et en conformité pour vos utilisateurs en Chine.
Obtenir une évaluation de conformité →
À lire également :
- Les Mesures provisoires de la Chine pour la gestion des services d’intelligence artificielle générative
- Les transferts transfrontaliers de données au titre de la PIPL
- Comment obtenir une déclaration ICP pour la Chine
- La loi chinoise sur la cybersécurité et la localisation des données
Questions fréquentes
Groq est-il disponible en Chine continentale ?
Il n'y a aucune région de Chine continentale pour GroqCloud. La propre documentation de Groq place les données clients conservées dans des buckets US de Google Cloud, et sa politique de confidentialité indique que l'entreprise est située aux États-Unis, de sorte qu'atteindre le modèle depuis le continent envoie vos données à l'étranger plutôt que vers un service sur le territoire. La décision pour un produit tourné vers la Chine n'est pas de savoir si le point de terminaison répond — c'est de savoir si les données peuvent légalement quitter la Chine et si votre fonctionnalité IA publique a besoin d'un dépôt auprès de la CAC. Il n'existe aucune voie légale pour transformer un modèle hébergé aux États-Unis en un modèle continental, et 21YunBox n'utilise ni ne suggère jamais aucun contournement, de quelque nature que ce soit.
GroqCloud conserve-t-il mes prompts ou s'en sert-il pour l'entraînement ?
Selon la documentation de Groq, GroqCloud ne conserve pas les données clients pour les requêtes d'inférence par défaut, offre une Zero Data Retention que vous pouvez activer, et conserve les journaux de fiabilité et d'abus jusqu'à trente jours ; les données conservées se trouvent dans des buckets US de Google Cloud. C'est une posture authentique de minimisation des données, mais elle répond à combien est conservé et pour combien de temps — non au fait que les données ont franchi la frontière. Le transfert transfrontalier PIPL se produit à l'instant où la requête d'un utilisateur continental est envoyée aux États-Unis, et l'obligation de dépôt IA générative est déclenchée par l'offre de la fonctionnalité au public, non par la façon dont ses entrées sont stockées.
Groq vend du matériel souverain GroqRack — cela rend-il un déploiement en Chine conforme ?
Pas à lui seul. GroqRack est du matériel LPU sur site visant les acheteurs souverains et réglementés, et en principe il peut se trouver à l'intérieur d'un pays — mais mettre du matériel sur le sol local est un ingrédient de résidence, non un verdict de conformité. Un service d'IA générative légal en Chine doit toujours être un service déposé exploité par un opérateur qui détient les dépôts auprès de la CAC, diffusé sur une infrastructure déclarée ICP. 21YunBox cartographie cette voie, localise votre fonctionnalité sur un modèle domestique déclaré auprès de la CAC ou un modèle de cloud souverain en Chine, et la diffuse sur le territoire — jamais une route vers le modèle à l'étranger.


