¿Funciona Kafka / Confluent en China? Regiones de Confluent Cloud, Kafka autoalojado y residencia de datos
Apache Kafka es software de código abierto que puede autoalojar en cualquier lugar, incluido China continental; Confluent Cloud es Kafka gestionado sin región en China continental. Así que la pregunta decisiva no es la velocidad — es la residencia de datos: transmitir datos personales o importantes recogidos en China a través de un clúster de Confluent Cloud en el extranjero es una transferencia transfronteriza según la PIPL, con una evaluación de seguridad de la CAC y almacenamiento dentro del país según la CSL (artículo 39, antes artículo 37) para los datos importantes y los CIIO. Una mirada, con el cumplimiento por delante, a la puerta de los datos — y a la vía autoalojada dentro del país.
¿Funciona Apache Kafka / Confluent en China?
Si Kafka funciona en China depende de a qué «Kafka» se refiera — y es una cuestión de residencia de datos, no de velocidad. Apache Kafka es software de streaming de eventos de código abierto que puede autoalojar en cualquier lugar, incluido dentro de China continental; Confluent Cloud es el servicio de Kafka totalmente gestionado de Confluent y, según su propia documentación, solo funciona en regiones de AWS, Azure y Google Cloud — ninguna dentro de China continental.
Así que, si transmite datos que recoge de usuarios en China a través de un clúster de Confluent Cloud en una región fuera de China continental (las más cercanas son Hong Kong, Taiwán, Tokio, Seúl o Singapur), los datos personales — y a veces importantes — que circulan por esos topics acaban residiendo fuera. Eso es una transferencia transfronteriza (数据出境) que regula la PIPL: notificación, un consentimiento separado y un mecanismo de transferencia, con una evaluación de seguridad de la CAC para datos importantes, grandes volúmenes o un CIIO. Para un CIIO o para datos importantes, el deber de almacenamiento dentro del país de la Ley de Ciberseguridad (artículo 39, antes artículo 37) mantiene esos datos en el continente — algo que ningún clúster en el extranjero puede cumplir.
La vía con residencia de datos es la de código abierto: autoalojar Apache Kafka (o un Kafka gestionado residente en China) dentro de China, mantener los flujos dentro del país y entregar la aplicación orientada a China dentro del país sobre infraestructura con registro ICP. Esto es un mapa de riesgo, no un veredicto — sus obligaciones dependen de sus datos, sus volúmenes y su papel, así que confírmelas con asesoría legal. Nuestro equipo de China puede cartografiar con usted su exposición de datos en Kafka →
Instantánea de cumplimiento
- ! Es una cuestión de residencia de datos (数据出境), no de velocidad — y la respuesta se divide por producto: Apache Kafka es software de código abierto que puede autoalojar en cualquier lugar, mientras que Confluent Cloud es un SaaS gestionado cuyas regiones deciden dónde residen sus flujos.
- ✕ Confluent Cloud no ofrece ninguna región en China continental — su propia documentación enumera regiones de AWS, Azure y Google Cloud (Hong Kong, Taiwán, Tokio, Seúl, Singapur y otras) sin ninguna dentro del continente.
- ! Transmitir datos personales — o importantes — recogidos en China a través de un clúster de Confluent Cloud en una región en el extranjero es una transferencia transfronteriza según la PIPL: notificación, un consentimiento separado y un mecanismo de transferencia.
- ! Para un CIIO, o para datos importantes, se aplican el almacenamiento dentro del país y una evaluación de seguridad de exportación de datos de la CAC (CSL artículo 39, antes artículo 37) — un clúster en el extranjero no puede cumplirlo.
- ✓ Existe una vía con residencia de datos: autoalojar Apache Kafka (o un Kafka gestionado residente en China) dentro de China, mantener los flujos dentro del país y entregar la aplicación orientada a China dentro del país sobre infraestructura con registro ICP.
Lo que la documentación oficial de Apache Kafka / Confluent dice sobre China
| Hecho | Fuente primaria |
|---|---|
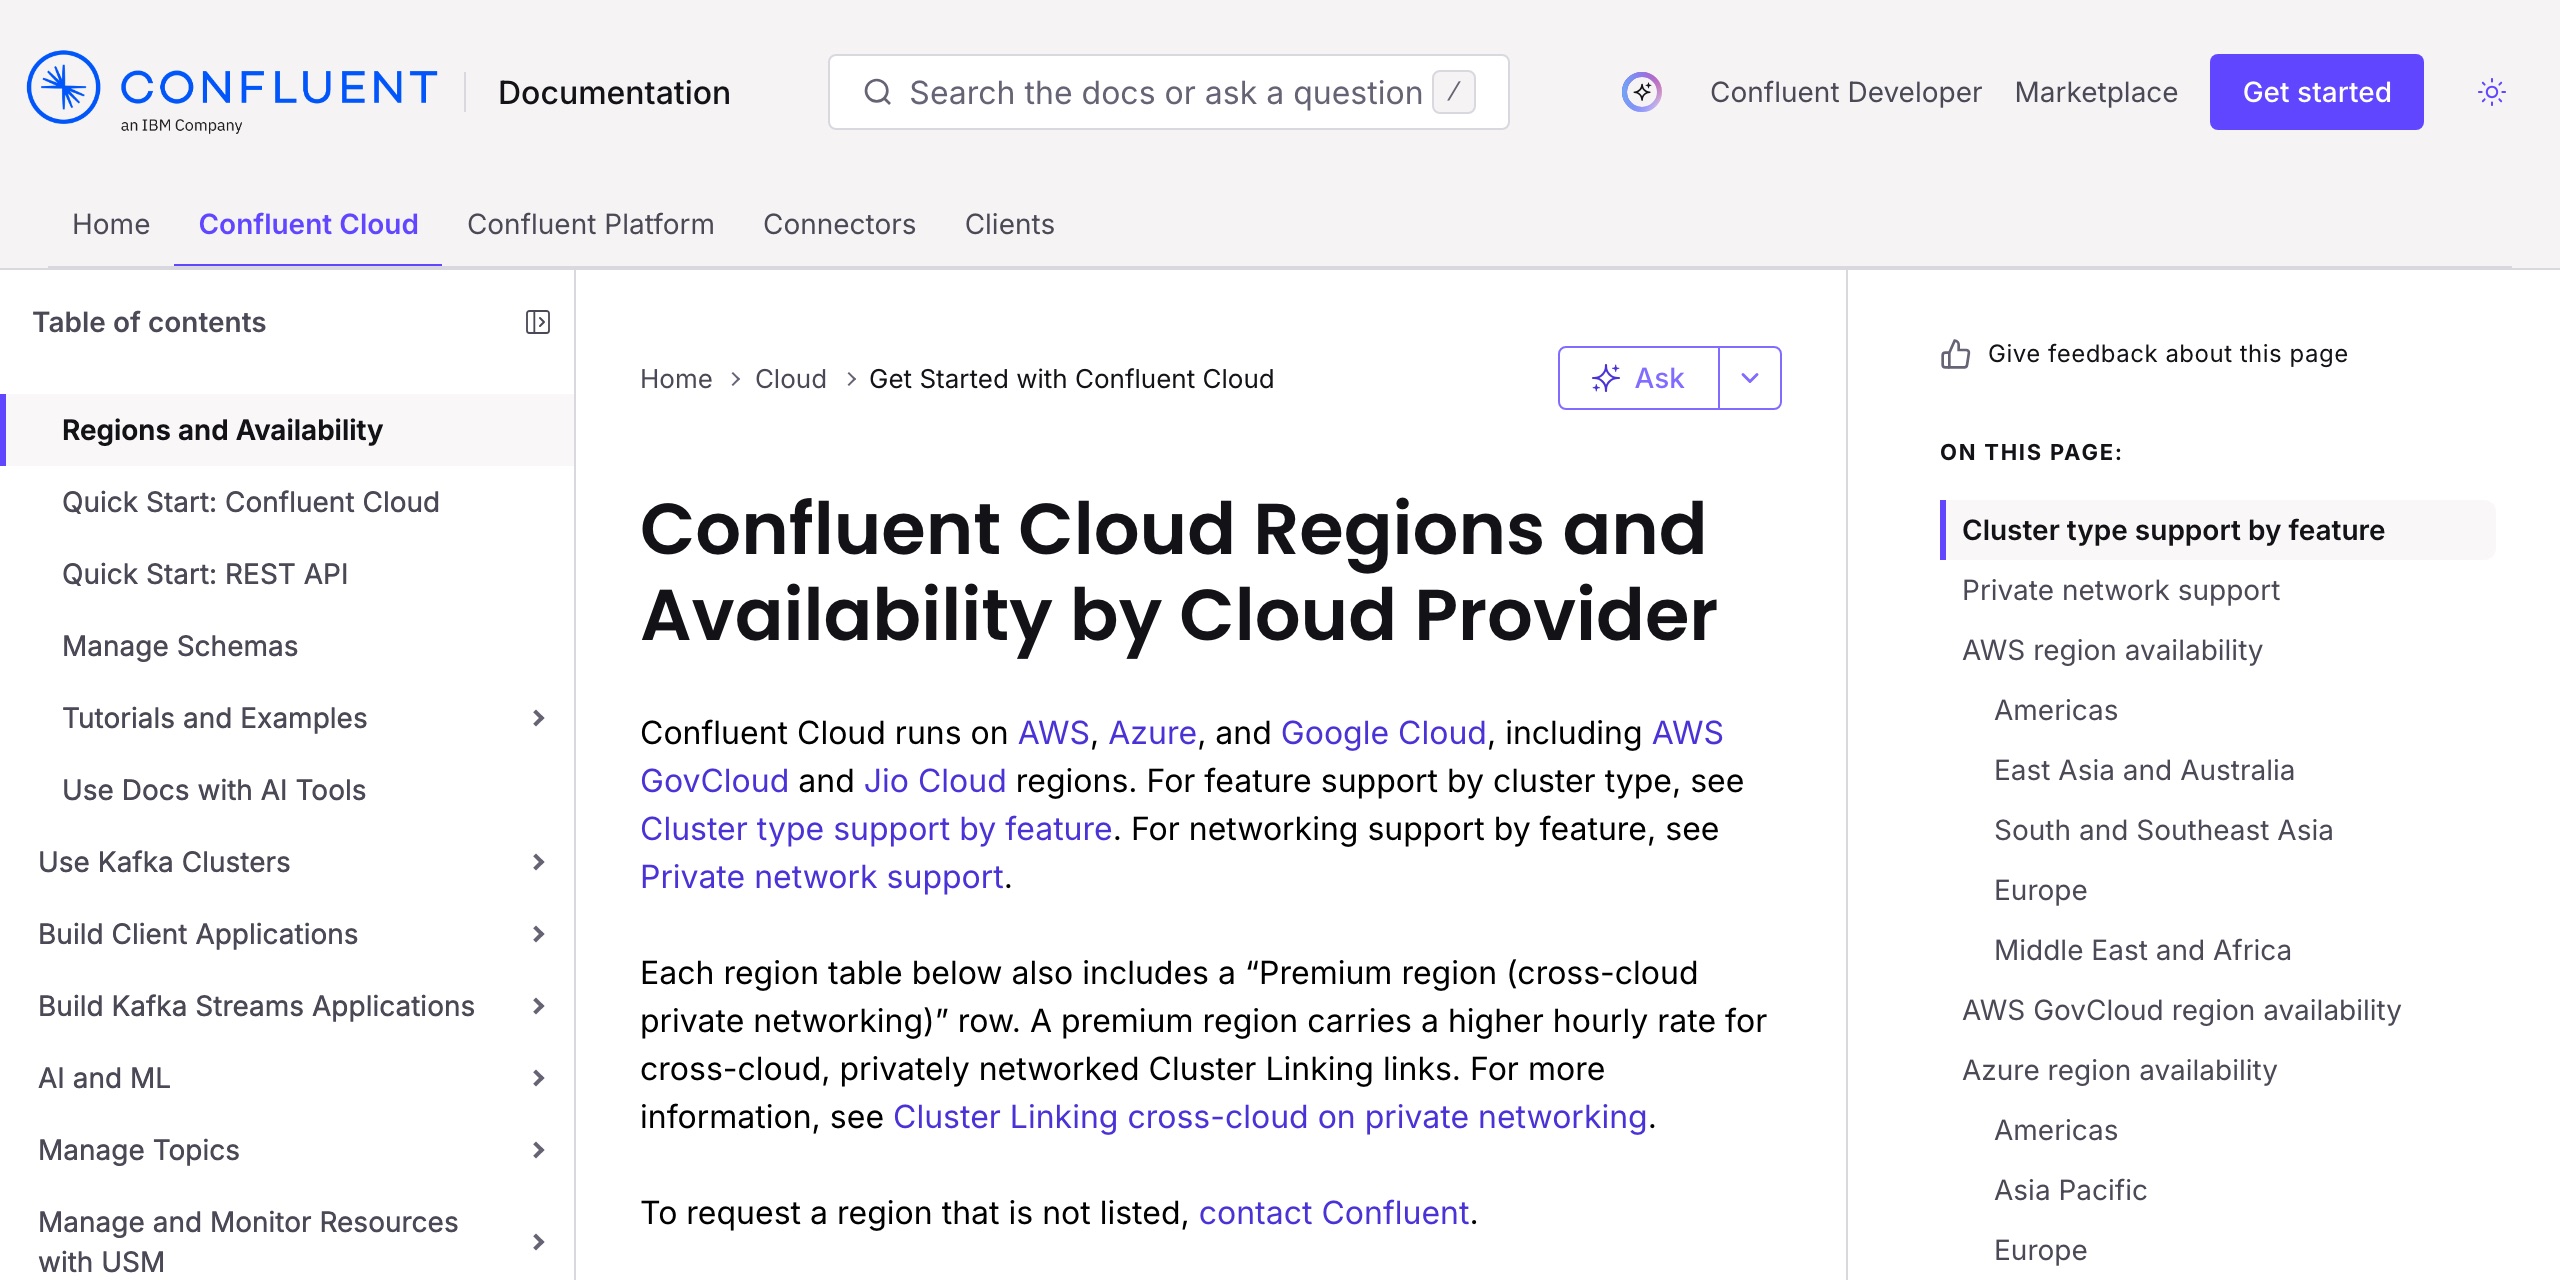
| Confluent Cloud es un servicio totalmente gestionado sin región en China continental. Confluent describe Confluent Cloud como “a fully managed, cloud-native service for Apache Kafka®,” y su documentación de Cloud afirma que “runs on AWS, Azure, and Google Cloud, including AWS GovCloud and Jio Cloud regions.” Esas tablas de regiones enumeran ubicaciones de Asia-Pacífico — Hong Kong, Taiwán, Tokio, Osaka, Seúl, Singapur, Yakarta, Bombay y Sídney —, pero ninguna dentro de China continental; las más cercanas son Hong Kong y Taiwán. | Documentación de Confluent, «Cloud Providers and Regions for Confluent Cloud», y Confluent, «Confluent Cloud, a Fully Managed Apache Kafka® Service» (docs.confluent.io / confluent.io), consultado el 2026-10-08 |
| Apache Kafka es software de código abierto que usted mismo ejecuta. La Apache Software Foundation lo describe como “an open-source distributed event streaming platform.” Como usted despliega y opera los brokers, puede ejecutar Apache Kafka en cualquier lugar — incluso en infraestructura dentro de China continental —, y esa es la vía que mantiene los datos de eventos en suelo chino. | Apache Kafka, Apache Software Foundation (kafka.apache.org), consultado el 2026-10-08 |
| Transmitir al extranjero datos personales recogidos en China es una transferencia transfronteriza según la PIPL. Enviar información personal recogida de usuarios en China a un clúster fuera del continente activa los artículos 38–40 de la PIPL: notificación, un consentimiento separado, distinto del uso ordinario, y un mecanismo de transferencia — una evaluación de seguridad de la CAC, el contrato estándar de la CAC o una certificación. El deber es del responsable del tratamiento — suyo, el cliente de Confluent, no del proveedor de Kafka. | Ley de Protección de Información Personal de la RPC, artículos 38–40 (cac.gov.cn), consultado el 2026-10-08 |
| Los datos importantes y los datos de un CIIO deben quedarse en el continente. Según la Ley de Ciberseguridad, la información personal y los datos importantes recogidos en China por un operador de infraestructuras de información críticas deben almacenarse en el continente — artículo 39 (antes artículo 37, renumerado por la reforma de 2025, en vigor desde el 2026-01-01) —, y cualquier transferencia al exterior de datos importantes requiere una evaluación de seguridad de la CAC conforme a las Medidas de Evaluación de Seguridad de las Transferencias de Datos al Extranjero. Un clúster de Confluent Cloud en el extranjero no puede cumplir un deber de almacenamiento en el continente. | Ley de Ciberseguridad de la RPC, art. 39 (antes art. 37); Medidas de Evaluación de Seguridad de las Transferencias de Datos al Extranjero (cac.gov.cn), consultado el 2026-10-08 |
| La exposición crece con el volumen y el papel. Según las Disposiciones para Promover y Regular los Flujos Transfronterizos de Datos de la CAC, de marzo de 2024, un operador que no sea CIIO y transfiera información personal no sensible de menos de 100 000 personas en un año natural está exento de la evaluación de seguridad, el contrato estándar y la certificación — mientras que exportar datos importantes, o cualquier exportación de un CIIO, sigue requiriendo la evaluación de seguridad de la CAC. | CAC — Disposiciones para Promover y Regular los Flujos Transfronterizos de Datos, marzo de 2024 (gov.cn), consultado el 2026-10-08 |
Fuentes verificadas por el Equipo de Cumplimiento de 21YunBox el 8 de octubre de 2026.
«¿Funciona Kafka en China?» tiene dos respuestas, porque «Kafka» designa dos cosas distintas. Apache Kafka es software de streaming de eventos de código abierto que usted mismo ejecuta — y puede ejecutarlo en cualquier lugar, incluso en servidores dentro de China continental. Confluent Cloud es el servicio de Kafka totalmente gestionado de Confluent, y solo funciona en las regiones de AWS, Azure y Google Cloud que ofrece Confluent — ninguna de las cuales está en China continental. Así que la pregunta decisiva no es si un broker es accesible ni lo rápido que se transmite un mensaje; es dónde se permite que acaben residiendo los datos que circulan por sus topics. Para un producto orientado a China, eso es una cuestión de residencia de datos — 数据出境 —, y cuál de los dos ejecute la resuelve.
Apache Kafka / Confluent en China de un vistazo
| Qué lo decide | En los propios términos de Apache y de Confluent — y la ley china |
|---|---|
| Qué está ejecutando realmente | Apache Kafka es software de código abierto que usted aloja por su cuenta — “an open-source distributed event streaming platform” — y puede ejecutarlo en cualquier lugar, incluido dentro de China continental. Confluent Cloud es el “fully managed, cloud-native service for Apache Kafka®” de Confluent, que se consume desde las regiones que ofrece Confluent. |
| Dónde pone sus datos Confluent Cloud | Según la documentación de Confluent, Confluent Cloud “runs on AWS, Azure, and Google Cloud,” en regiones de EE. UU., Europa y Asia-Pacífico — Hong Kong, Taiwán, Tokio, Osaka, Seúl, Singapur, Yakarta, Bombay, Sídney —, sin ninguna región dentro de China continental. Las más cercanas son Hong Kong y Taiwán. |
| La transferencia transfronteriza | Los datos personales — y a veces importantes — que su aplicación transmite desde usuarios en China llegan a ese clúster en el extranjero. Eso es una transferencia transfronteriza (数据出境) que regula la PIPL, y el responsable es usted, el cliente de Confluent, no Confluent. |
| Datos importantes y residencia | Si transporta datos importantes, u opera como CIIO, los datos deben almacenarse en el continente (Ley de Ciberseguridad artículo 39, antes artículo 37), y cualquier exportación debe superar una evaluación de seguridad de la CAC — deberes que ninguna región de Confluent Cloud puede cumplir. |
| La vía con residencia de datos | Autoalojar Apache Kafka (o un Kafka gestionado residente en China) dentro de China para que los flujos se queden dentro del país, y entregar la aplicación orientada a China dentro del país sobre infraestructura con registro ICP. Ningún selector de región de una nube gestionada sustituye a esto. |
Apache Kafka frente a Confluent Cloud: cuál de los dos ejecuta es toda la cuestión
Es fácil confundirlos e importante separarlos. Apache Kafka es, en palabras de la Apache Software Foundation, “an open-source distributed event streaming platform” — software que usted descarga, despliega y opera en la infraestructura que elija. Nada en él obliga a que sus datos salgan al extranjero; ejecute los brokers en servidores dentro de China continental y los datos de eventos se quedan en suelo chino.
Confluent Cloud es el intercambio opuesto. Confluent lo presenta como “a fully managed, cloud-native service for Apache Kafka®” — no lo coloca en sus propios servidores; lo consume desde las regiones que opera Confluent. Según la propia documentación de Confluent Cloud, “Confluent Cloud runs on AWS, Azure, and Google Cloud,” y sus tablas de regiones publicadas cubren Estados Unidos, Europa y ubicaciones de Asia-Pacífico como Hong Kong, Taiwán, Tokio, Osaka, Seúl, Singapur, Yakarta, Bombay y Sídney — pero ni una sola región dentro de China continental. Así que, en el momento en que una aplicación orientada a China transmite a través de Confluent Cloud, los datos de esos topics acaban residiendo en una región en el extranjero. Eso, y no la latencia, es a lo que responde la ley de datos de China.
Transmita datos de China a través de un clúster en el extranjero y cruzarán la frontera
Los registros que fluyen por sus topics rara vez son anónimos. Los flujos de eventos transportan altas de usuarios, pedidos, flujos de clics, pagos y señales de dispositivo y de ubicación — información personal según la ley china y, a veces, también datos importantes. Cuando esos flujos los generan usuarios en China continental y llegan a un clúster de Confluent Cloud en una región en el extranjero, eso es una transferencia transfronteriza de información personal que regula la Ley de Protección de Información Personal de China. La PIPL impone el deber al responsable del tratamiento — usted, el cliente de Confluent, no Confluent — y exige notificación, un consentimiento separado para la transferencia, distinto del uso ordinario, y un mecanismo de transferencia: una evaluación de seguridad de la CAC, el contrato estándar de la CAC o una certificación. Cuando los datos incluyen datos importantes o superan ciertos volúmenes, las Medidas de Evaluación de Seguridad de las Transferencias de Datos al Extranjero convierten la evaluación de seguridad de la CAC en la vía obligatoria. Funcionar sobre Confluent Cloud no resuelve nada de eso; llegar a un clúster y estar habilitado para trasladar a él los datos de usuarios chinos son preguntas distintas.
Cuánto está en juego — volumen, papel y datos importantes
El peso de estos deberes no es uniforme. Según las Disposiciones para Promover y Regular los Flujos Transfronterizos de Datos de la CAC, de marzo de 2024, un responsable que no sea operador de infraestructuras de información críticas y transfiera información personal no sensible de menos de 100 000 personas en un año natural está exento de la evaluación de seguridad, el contrato estándar y la certificación — una vía realmente más ligera para una aplicación pequeña.
En el otro extremo hay dos casos a los que Confluent Cloud no puede atender por su propia estructura. Si sus flujos transportan datos importantes, o si usted es un operador de infraestructuras de información críticas, la Ley de Ciberseguridad de China exige que la información personal y los datos importantes recogidos en el continente se almacenen en el continente — artículo 39 (antes artículo 37, renumerado por la reforma de 2025, en vigor desde el 1 de enero de 2026) — y cualquier transferencia al exterior pasa por la evaluación de seguridad de la CAC. Ninguna región de Confluent Cloud puede cumplir un deber de almacenamiento en el continente, porque ninguna está en China. Si sus flujos alcanzan estos niveles es un riesgo que conviene confirmar con asesoría legal según los datos que mueve realmente.
La vía con residencia de datos: mantener los flujos en suelo chino
Aquí la mitad de código abierto de la historia es la respuesta. Como Apache Kafka es software que usted mismo opera, puede ejecutarlo dentro de China continental — autoalojado en infraestructura dentro del país, o en una oferta de Kafka gestionado residente en China operada por un proveedor local —, de modo que los topics que transportan datos de usuarios chinos nunca salen del continente. El streaming sigue siendo idéntico; lo que cambia es dónde residen los brokers y los datos. Para los casos más estrictos — datos importantes, o los datos de un CIIO —, esa base dentro del país no es una optimización, es la condición para poder funcionar. Y la aplicación orientada a China que produce y consume esos flujos es en sí misma un servicio público en el continente, por lo que conlleva un deber de registro ICP (备案) y necesita una entrega conforme dentro del país, como cualquier otra propiedad orientada a China.
Dónde encaja 21YunBox — cartografiar la obligación, localizar los datos, entregar dentro del país
Usted sigue construyendo sobre Kafka; nada de su arquitectura tiene que cambiar de forma. Nuestro equipo de China trabaja en tres frentes. Cartografiamos sus obligaciones transfronterizas y de residencia de datos — cuáles de los mecanismos de la PIPL debe, si sus flujos transportan datos importantes y si su papel le sitúa en el nivel de CIIO. Localizamos los propios datos: cuando la ley exige que los registros de usuarios chinos se queden en el continente, le ayudamos a ejecutar dentro de China un despliegue de Apache Kafka autoalojado, o un Kafka gestionado residente en China, para que los flujos nunca salgan. Y entregamos dentro del país la aplicación orientada a China que produce y consume esos flujos, sobre infraestructura con registro ICP situada por delante del origen que ya utiliza — el 21YunBox Optimizer —, sin reconstruir y sin un segundo código base. El resultado es un stack de streaming cuyos datos de China residen en suelo chino y cuya aplicación se entrega legalmente en el continente. Esto es un mapa de riesgo, no un veredicto: sus deberes exactos dependen de sus datos, sus volúmenes y su papel, así que concrételos con asesoría legal antes de construir.
Solicitar una evaluación de cumplimiento →
Lectura relacionada:
- Medidas de Evaluación de Seguridad de las Transferencias de Datos al Extranjero
- Transferencias transfronterizas de datos conforme a la PIPL
- La Ley de Ciberseguridad de China — localización de datos y artículo 39
Preguntas frecuentes
¿Funciona Apache Kafka en China?
Depende de a qué «Kafka» se refiera, y la verdadera cuestión es la residencia de datos, no la velocidad. Apache Kafka es software de código abierto que usted mismo ejecuta, así que puede autoalojarlo en infraestructura dentro de China continental y mantener los datos de eventos en suelo chino. Confluent Cloud, el servicio totalmente gestionado, es distinto: según la propia documentación de Confluent, solo funciona en regiones de AWS, Azure y Google Cloud, ninguna dentro de China continental, así que un flujo orientado a China sobre él reside en el extranjero. Trate sus obligaciones exactas como un riesgo que confirmar con asesoría legal.
¿Almacena Confluent Cloud mis datos en China?
No. Confluent Cloud no ofrece ninguna región en China continental — sus clústeres funcionan en las regiones de AWS, Azure y Google Cloud que enumera Confluent, y las más cercanas son Hong Kong, Taiwán, Tokio, Seúl y Singapur. Así que los datos personales — y a veces importantes — que su aplicación recoge de usuarios en China se almacenan en el extranjero, lo que es una transferencia transfronteriza de información personal que regula la PIPL: notificación, un consentimiento separado y un mecanismo de transferencia, con una evaluación de seguridad de la CAC para datos importantes, grandes volúmenes o un CIIO.
¿Cómo mantenemos nuestros datos de Kafka en China y cumplimos la normativa?
Use la vía de código abierto: autoaloje Apache Kafka, o un Kafka gestionado residente en China, en infraestructura dentro del continente para que los flujos que transportan datos de usuarios chinos nunca salgan. La aplicación orientada a China que produce y consume esos flujos es en sí misma un servicio público en el continente, así que sigue necesitando un registro ICP y una entrega conforme dentro del país. 21YunBox cartografía su exposición transfronteriza y de residencia de datos, le ayuda a poner en marcha el despliegue de Kafka dentro del país y ofrece la entrega dentro del país con registro ICP — no es una forma de llegar a un clúster en el extranjero. Confirme sus deberes concretos con asesoría legal.


