Kafka / Confluent fonctionne-t-il en Chine ? Régions Confluent Cloud, Kafka auto-hébergé et résidence des données
Apache Kafka est un logiciel open source que vous pouvez auto-héberger n'importe où, y compris à l'intérieur de la Chine continentale ; Confluent Cloud est un Kafka managé sans région de Chine continentale. Ainsi la question décisive n'est pas la vitesse — c'est la résidence des données : faire transiter des données personnelles ou importantes collectées en Chine par un cluster Confluent Cloud à l'étranger est un transfert transfrontalier au titre de la PIPL, avec une évaluation de sécurité de la CAC et un stockage sur le territoire au titre de la CSL (article 39, anciennement l'article 37) pour les données importantes et les opérateurs d'infrastructure d'information critique. Un regard priorité à la conformité sur la porte des données — et la voie auto-hébergée, sur le territoire.
Apache Kafka / Confluent fonctionne-t-il en Chine ?
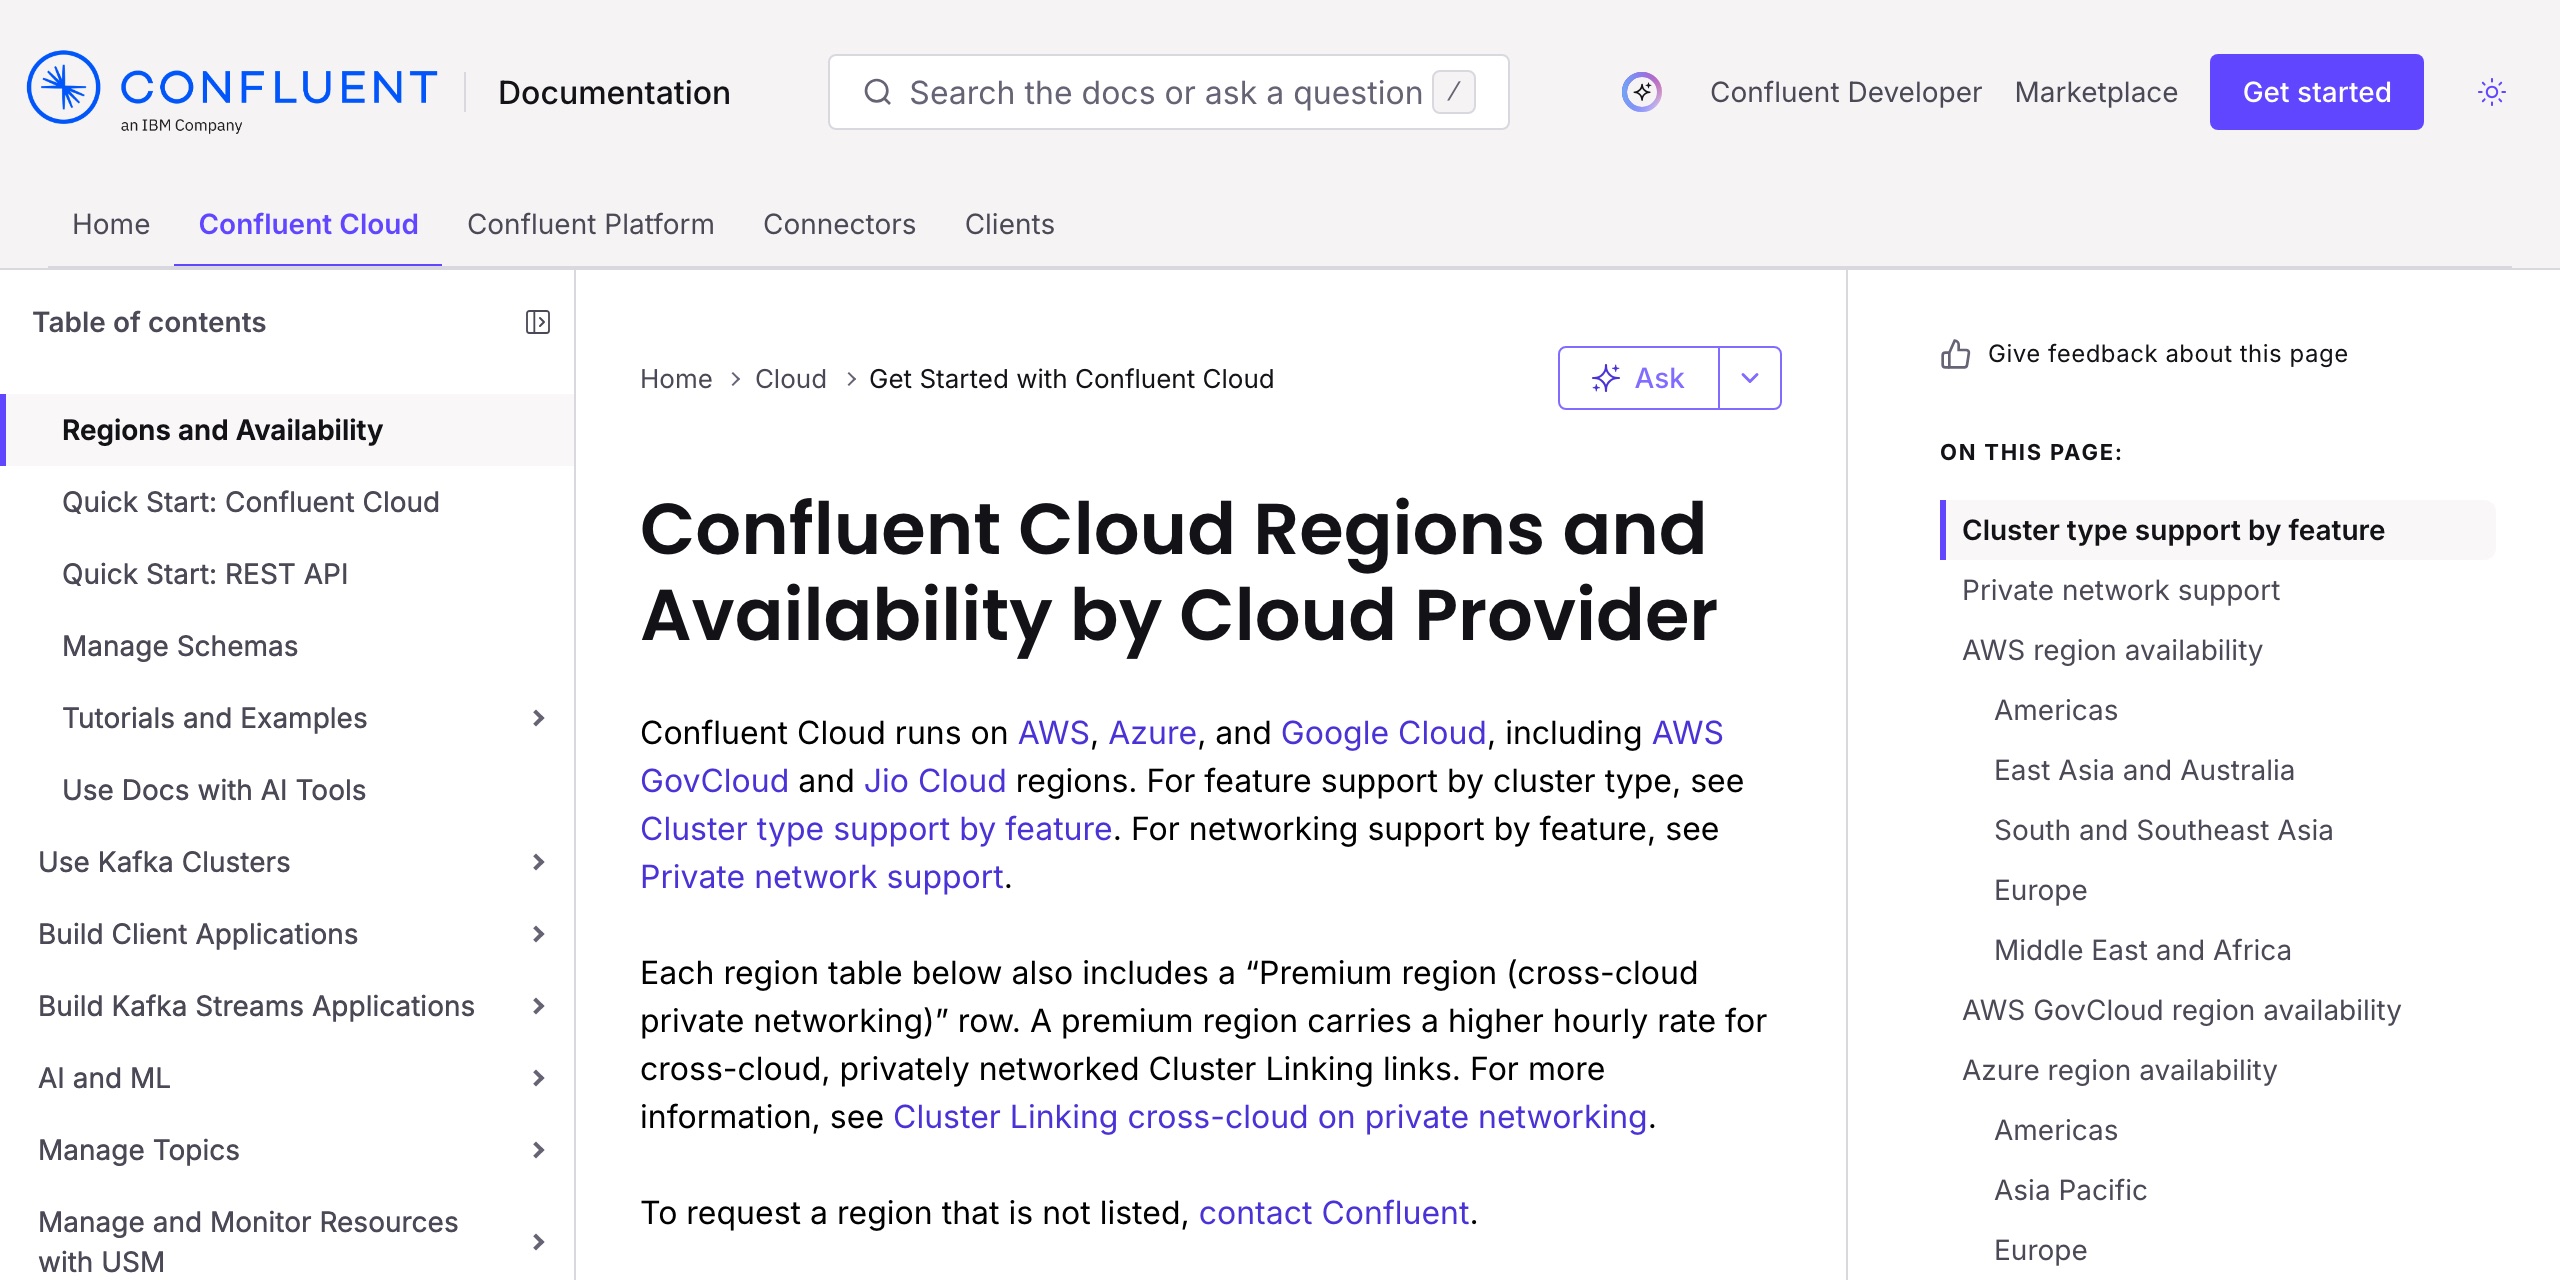
Savoir si Kafka fonctionne en Chine dépend de quel « Kafka » vous parlez — et c'est une question de résidence des données, non de vitesse. Apache Kafka est un logiciel d'event-streaming open source que vous pouvez auto-héberger n'importe où, y compris à l'intérieur de la Chine continentale ; Confluent Cloud est le service Kafka entièrement managé de Confluent, et selon sa propre documentation il tourne uniquement dans des régions AWS, Azure et Google Cloud — aucune à l'intérieur de la Chine continentale.
Ainsi, si vous faites transiter des données que vous collectez auprès d'utilisateurs en Chine par un cluster Confluent Cloud dans une région à l'étranger (les plus proches étant Hong Kong, Taïwan, Tokyo, Séoul ou Singapour), les données personnelles — et parfois importantes — qui transitent par ces topics viennent reposer à l'étranger. C'est un transfert transfrontalier (数据出境) que la PIPL régit : information, un consentement distinct, et un mécanisme de transfert, avec une évaluation de sécurité de la CAC pour les données importantes, les grands volumes, ou un opérateur d'infrastructure d'information critique. Pour un opérateur d'infrastructure d'information critique ou des données importantes, l'obligation de stockage sur le territoire de la loi sur la cybersécurité (article 39, anciennement l'article 37) garde ces données sur le continent — ce qu'aucun cluster à l'étranger ne peut satisfaire.
La voie résidente en données est la voie open source : auto-héberger Apache Kafka (ou un Kafka managé résident en Chine) à l'intérieur de la Chine, garder les flux sur le territoire, et diffuser l'app tournée vers la Chine sur le territoire sur une infrastructure déclarée ICP. Ceci est une carte des risques, non un verdict — vos obligations dépendent de vos données, de vos volumes et de votre rôle, alors confirmez-les avec un conseil. Notre équipe Chine peut cartographier avec vous votre exposition de données Kafka →
Aperçu de conformité
- ! C'est une question de résidence des données (数据出境), non de vitesse — et la réponse se divise par produit : Apache Kafka est un logiciel open source que vous auto-hébergez n'importe où, tandis que Confluent Cloud est un SaaS managé dont les régions décident où reposent vos flux.
- ✕ Confluent Cloud n'offre aucune région de Chine continentale — ses propres docs listent des régions AWS, Azure et Google Cloud (Hong Kong, Taïwan, Tokyo, Séoul, Singapour et plus) sans aucune à l'intérieur du continent.
- ! Faire transiter des données personnelles — ou importantes — collectées en Chine par un cluster Confluent Cloud dans une région à l'étranger est un transfert transfrontalier au titre de la PIPL : information, un consentement distinct, et un mécanisme de transfert.
- ! Pour un opérateur d'infrastructure d'information critique, ou pour des données importantes, un stockage sur le territoire plus une évaluation de sécurité pour l'exportation de données de la CAC s'appliquent (CSL article 39, anciennement l'article 37) — un cluster à l'étranger ne peut pas satisfaire cela.
- ✓ Une voie résidente en données existe : auto-héberger Apache Kafka (ou un Kafka managé résident en Chine) à l'intérieur de la Chine, garder les flux sur le territoire, et diffuser l'app tournée vers la Chine sur le territoire sur une infrastructure déclarée ICP.
Ce que la documentation officielle de Apache Kafka / Confluent dit de la Chine
| Fait | Source primaire |
|---|---|
| Confluent Cloud est un service entièrement managé sans région de Chine continentale. Confluent décrit Confluent Cloud comme un “fully managed, cloud-native service for Apache Kafka®,” et sa documentation Cloud indique qu'il “runs on AWS, Azure, and Google Cloud, including AWS GovCloud and Jio Cloud regions.” Ces tableaux de régions listent des sites Asie-Pacifique — Hong Kong, Taïwan, Tokyo, Osaka, Séoul, Singapour, Jakarta, Mumbai et Sydney — mais aucun à l'intérieur de la Chine continentale, les plus proches étant Hong Kong et Taïwan. | Confluent Documentation, « Cloud Providers and Regions for Confluent Cloud », et Confluent, « Confluent Cloud, a Fully Managed Apache Kafka® Service » (docs.confluent.io / confluent.io), consulté le 2026-10-08 |
| Apache Kafka est un logiciel open source que vous exécutez vous-même. L'Apache Software Foundation le décrit comme “an open-source distributed event streaming platform.” Parce que vous déployez et exploitez les brokers, vous pouvez exécuter Apache Kafka n'importe où — y compris sur une infrastructure à l'intérieur de la Chine continentale — ce qui est la voie qui garde les données d'événement sur le sol chinois. | Apache Kafka, Apache Software Foundation (kafka.apache.org), consulté le 2026-10-08 |
| Faire transiter des données personnelles collectées en Chine à l'étranger est un transfert transfrontalier PIPL. Envoyer l'information personnelle collectée auprès d'utilisateurs en Chine vers un cluster hors du continent déclenche les articles 38 à 40 de la PIPL : information, un consentement distinct de l'usage ordinaire, et un mécanisme de transfert — une évaluation de sécurité de la CAC, le contrat type de la CAC, ou une certification. L'obligation est celle du responsable de l'information personnelle — la vôtre, le client de Confluent, non celle du fournisseur de Kafka. | Loi sur la protection des informations personnelles de la RPC, articles 38 à 40 (cac.gov.cn), consulté le 2026-10-08 |
| Les données importantes et les données d'opérateur d'infrastructure d'information critique doivent rester sur le continent. Au titre de la loi sur la cybersécurité, l'information personnelle et les données importantes collectées par un opérateur d'infrastructure d'information critique en Chine doivent être stockées sur le continent — article 39 (anciennement l'article 37, renuméroté par l'amendement 2025 en vigueur le 2026-01-01) — et toute exportation sortante de données importantes exige une évaluation de sécurité de la CAC au titre des Mesures pour l'évaluation de sécurité des exportations de données. Un cluster Confluent Cloud à l'étranger ne peut pas satisfaire une obligation de stockage sur le continent. | Loi sur la cybersécurité de la RPC, art. 39 (anciennement l'art. 37) ; Mesures pour l'évaluation de sécurité des exportations de données (cac.gov.cn), consulté le 2026-10-08 |
| L'exposition varie avec le volume et le rôle. Au titre du Règlement de la CAC de mars 2024 sur la promotion et la régulation des flux de données transfrontaliers, un responsable non-opérateur d'infrastructure d'information critique transférant l'information personnelle non sensible de moins de 100 000 individus en une année civile est exempté de l'évaluation de sécurité, du contrat type et de la certification — tandis qu'exporter des données importantes, ou toute exportation par un opérateur d'infrastructure d'information critique, exige encore l'évaluation de sécurité de la CAC. | CAC — Règlement sur la promotion et la régulation des flux de données transfrontaliers, mars 2024 (gov.cn), consulté le 2026-10-08 |
Sources vérifiées par Équipe Conformité 21YunBox le 8 octobre 2026.
« Kafka fonctionne-t-il en Chine ? » a deux réponses, parce que « Kafka » nomme deux choses différentes. Apache Kafka est un logiciel d’event-streaming open source que vous exécutez vous-même — et vous pouvez l’exécuter n’importe où, y compris sur des serveurs à l’intérieur de la Chine continentale. Confluent Cloud est le service Kafka entièrement managé de Confluent, et il tourne uniquement dans les régions AWS, Azure et Google Cloud que Confluent offre — dont aucune n’est en Chine continentale. Ainsi la question décisive n’est pas de savoir si un broker est accessible ou à quelle vitesse un message circule ; c’est de savoir où les données qui transitent par vos topics ont le droit de venir reposer. Pour un produit tourné vers la Chine, c’est une question de résidence des données — 数据出境 — et laquelle des deux vous exécutez la règle.
Apache Kafka / Confluent en Chine en un coup d’œil
| Ce qui le décide | Dans les propres termes d'Apache et de Confluent — et la loi chinoise |
|---|---|
| Ce que vous exécutez réellement | Apache Kafka est un logiciel open source que vous hébergez vous-même — “an open-source distributed event streaming platform” — et vous pouvez l'exécuter n'importe où, y compris à l'intérieur de la Chine continentale. Confluent Cloud est le “fully managed, cloud-native service for Apache Kafka®” de Confluent, consommé depuis les régions que Confluent offre. |
| Où Confluent Cloud met vos données | Selon les docs de Confluent, Confluent Cloud “runs on AWS, Azure, and Google Cloud,” à travers des régions US, européennes et Asie-Pacifique — Hong Kong, Taïwan, Tokyo, Osaka, Séoul, Singapour, Jakarta, Mumbai, Sydney — avec aucune région à l'intérieur de la Chine continentale. Les plus proches sont Hong Kong et Taïwan. |
| Le transfert transfrontalier | Les données personnelles — et parfois importantes — que votre app fait transiter depuis des utilisateurs en Chine aboutissent dans ce cluster à l'étranger. C'est un transfert transfrontalier (数据出境) que la PIPL régit, et le responsable est vous, le client de Confluent, non Confluent. |
| Données importantes et résidence | Portez des données importantes, ou opérez comme un opérateur d'infrastructure d'information critique, et les données doivent être stockées sur le continent (article 39 de la loi sur la cybersécurité, anciennement l'article 37), avec toute exportation franchie par une évaluation de sécurité de la CAC — des obligations qu'aucune région Confluent Cloud ne peut satisfaire. |
| La voie résidente en données | Auto-hébergez Apache Kafka (ou un Kafka managé résident en Chine) à l'intérieur de la Chine de sorte que les flux restent sur le territoire, et diffusez l'app tournée vers la Chine sur le territoire sur une infrastructure déclarée ICP. Aucun basculement de région sur un cloud managé ne remplace cela. |
Apache Kafka vs Confluent Cloud : lequel vous exécutez est toute la question
Les deux sont faciles à confondre et importants à distinguer. Apache Kafka est, dans les mots de l’Apache Software Foundation, “an open-source distributed event streaming platform” — un logiciel que vous téléchargez, déployez et exploitez sur une infrastructure que vous choisissez. Rien en lui ne force vos données à l’étranger ; exécutez les brokers sur des serveurs à l’intérieur de la Chine continentale et les données d’événement restent sur le sol chinois.
Confluent Cloud est le compromis inverse. Confluent le commercialise comme un “fully managed, cloud-native service for Apache Kafka®” — vous ne le placez pas sur vos propres serveurs ; vous le consommez depuis les régions que Confluent exploite. Selon la propre documentation Cloud de Confluent, “Confluent Cloud runs on AWS, Azure, and Google Cloud,” et ses tableaux de régions publiés couvrent les États-Unis, l’Europe, et des sites Asie-Pacifique tels que Hong Kong, Taïwan, Tokyo, Osaka, Séoul, Singapour, Jakarta, Mumbai et Sydney — mais pas une région à l’intérieur de la Chine continentale. Ainsi à l’instant où une app tournée vers la Chine transite par Confluent Cloud, les données dans ces topics viennent reposer dans une région à l’étranger. C’est cela, non la latence, ce à quoi la loi chinoise sur les données répond.
Faites transiter des données Chine par un cluster à l’étranger et elles franchissent la frontière
Les enregistrements qui circulent par vos topics sont rarement anonymes. Les flux d’événements portent des inscriptions, commandes, parcours de clics, paiements, et signaux d’appareil et de localisation — une information personnelle au titre de la loi chinoise, et parfois des données importantes aussi. Quand ces flux sont produits par des utilisateurs en Chine continentale et aboutissent dans un cluster Confluent Cloud dans une région à l’étranger, c’est un transfert transfrontalier d’information personnelle que la loi chinoise sur la protection des informations personnelles régit. La PIPL met l’obligation sur le responsable de l’information personnelle — vous, le client de Confluent, non Confluent — et demande une information, un consentement distinct pour le transfert distinct de l’usage ordinaire, et un mécanisme de transfert : une évaluation de sécurité de la CAC, le contrat type de la CAC, ou une certification. Là où les données incluent des données importantes ou franchissent des lignes de volume, les Mesures pour l’évaluation de sécurité des exportations de données font de l’évaluation de sécurité de la CAC la route obligatoire. Tourner sur Confluent Cloud ne règle rien de cela ; atteindre un cluster et être autorisé à y déplacer les données d’utilisateurs chinois sont des questions différentes.
Combien est en jeu — volume, rôle, et données importantes
Le poids de ces obligations n’est pas uniforme. Au titre du Règlement de la CAC de mars 2024 sur la promotion et la régulation des flux de données transfrontaliers, un responsable qui n’est pas un opérateur d’infrastructure d’information critique et déplace l’information personnelle non sensible de moins de 100 000 individus en une année civile est exempté de l’évaluation de sécurité, du contrat type et de la certification — une voie véritablement plus légère pour une petite app.
À l’autre bout se trouvent deux cas que Confluent Cloud ne peut structurellement pas servir. Si vos flux portent des données importantes, ou si vous êtes un opérateur d’infrastructure d’information critique, la loi chinoise sur la cybersécurité exige que l’information personnelle et les données importantes collectées sur le continent soient stockées sur le continent — article 39 (anciennement l’article 37, renuméroté par l’amendement 2025 entré en vigueur le 1er janvier 2026) — et toute exportation sortante passe par l’évaluation de sécurité de la CAC. Aucune région Confluent Cloud ne peut satisfaire une obligation de stockage sur le continent, parce qu’aucune d’elles ne se trouve en Chine. Savoir si vos flux atteignent ces niveaux est un risque à confirmer avec un conseil au regard des données que vous déplacez réellement.
La voie résidente en données : garder les flux sur le sol chinois
Ici la moitié open source de l’histoire est la réponse. Parce qu’Apache Kafka est un logiciel que vous exploitez vous-même, vous pouvez l’exécuter à l’intérieur de la Chine continentale — auto-hébergé sur une infrastructure sur le territoire, ou sur une offre Kafka managée résidente en Chine exploitée par un fournisseur local — de sorte que les topics qui portent les données d’utilisateurs chinois ne quittent jamais le continent. Le streaming reste identique ; ce qui change, c’est l’endroit où vivent les brokers et les données. Pour les cas les plus stricts — données importantes, ou données d’un opérateur d’infrastructure d’information critique — cette assise sur le territoire n’est pas une optimisation, c’est la condition pour être autorisé à tourner tout court. Et l’app tournée vers la Chine qui produit et consomme ces flux est elle-même un service public sur le continent, de sorte qu’elle porte une obligation de déclaration ICP (备案) et a besoin d’une diffusion conforme, sur le territoire, comme toute autre propriété tournée vers la Chine.
Où 21YunBox s’inscrit — cartographier l’obligation, localiser les données, diffuser sur le territoire
Vous continuez de construire sur Kafka ; rien de votre architecture n’a à changer de forme. Notre équipe Chine travaille sur trois fronts. Nous cartographions vos obligations transfrontalières et de résidence des données — lesquels des mécanismes de la PIPL vous devez, si vos flux portent des données importantes, et si votre rôle vous tire dans le niveau opérateur d’infrastructure d’information critique. Nous localisons les données elles-mêmes : là où la loi exige que les enregistrements d’utilisateurs chinois restent sur le continent, nous vous aidons à exécuter un déploiement Apache Kafka auto-hébergé, ou un Kafka managé résident en Chine, à l’intérieur de la Chine, de sorte que les flux ne partent jamais. Et nous diffusons l’app tournée vers la Chine qui produit et consomme ces flux sur le territoire, sur une infrastructure déclarée ICP se tenant devant l’origine que vous exploitez déjà — le 21YunBox Optimizer — sans reconstruction et sans seconde base de code. Le résultat est un stack de streaming dont les données Chine se trouvent sur le sol chinois et dont l’app est diffusée légalement sur le continent. Ceci est une carte des risques, non un verdict : vos obligations exactes dépendent de vos données, de vos volumes et de votre rôle, alors réglez-les avec un conseil avant de construire.
Obtenir une évaluation de conformité →
À lire également :
- Les mesures pour l’évaluation de sécurité des exportations de données
- Les transferts transfrontaliers de données au titre de la PIPL
- La loi chinoise sur la cybersécurité — localisation des données et article 39
Questions fréquentes
Apache Kafka fonctionne-t-il en Chine ?
Cela dépend de quel « Kafka » vous parlez, et le vrai enjeu est la résidence des données, non la vitesse. Apache Kafka est un logiciel open source que vous exécutez vous-même, de sorte que vous pouvez l'auto-héberger sur une infrastructure à l'intérieur de la Chine continentale et garder les données d'événement sur le sol chinois. Confluent Cloud, le service entièrement managé, est différent : selon la propre documentation de Confluent, il tourne uniquement dans des régions AWS, Azure et Google Cloud, aucune à l'intérieur de la Chine continentale, de sorte qu'un flux tourné vers la Chine sur lui repose à l'étranger. Traitez vos obligations exactes comme un risque à confirmer avec un conseil.
Confluent Cloud stocke-t-il mes données en Chine ?
Non. Confluent Cloud n'offre aucune région de Chine continentale — ses clusters tournent dans les régions AWS, Azure et Google Cloud que Confluent liste, les plus proches étant Hong Kong, Taïwan, Tokyo, Séoul et Singapour. Ainsi les données personnelles — et parfois importantes — que votre app collecte auprès d'utilisateurs en Chine sont stockées à l'étranger, ce qui est un transfert transfrontalier d'information personnelle que la PIPL régit : information, un consentement distinct, et un mécanisme de transfert, avec une évaluation de sécurité de la CAC pour les données importantes, les grands volumes, ou un opérateur d'infrastructure d'information critique.
Comment gardons-nous nos données Kafka en Chine et restons-nous conformes ?
Utilisez la voie open source : auto-hébergez Apache Kafka, ou un Kafka managé résident en Chine, sur une infrastructure à l'intérieur du continent de sorte que les flux portant les données d'utilisateurs chinois ne partent jamais. L'app tournée vers la Chine qui produit et consomme ces flux est elle-même un service continental public, de sorte qu'elle a toujours besoin d'une déclaration ICP et d'une diffusion conforme sur le territoire. 21YunBox cartographie votre exposition transfrontalière et de résidence des données, vous aide à mettre en place le déploiement Kafka sur le territoire, et fournit la diffusion déclarée ICP, sur le territoire — ce n'est pas un moyen d'atteindre un cluster à l'étranger. Confirmez vos obligations précises avec un conseil.


