¿Funciona OpenSearch en China? Transferencia transfronteriza según la PIPL, residencia de datos y autoalojamiento
OpenSearch es un almacén de datos en reposo: los documentos que indexa y los embeddings k-NN que deriva de ellos son información personal cuando describen a personas en China. El servicio global Amazon OpenSearch Service no tiene región en China continental, así que indexar datos de usuarios chinos en el extranjero es una transferencia transfronteriza según la PIPL — una mirada, con el cumplimiento por delante, a la exposición de residencia y a la palanca del autoalojamiento dentro del país.
¿Funciona OpenSearch en China?
OpenSearch es un almacén de datos en reposo con los documentos indexados de sus usuarios y los embeddings k-NN construidos a partir de ellos — y el servicio global Amazon OpenSearch Service no tiene región en China continental, así que, para sus usuarios en China, ese contenido queda en el extranjero como una transferencia transfronteriza según la PIPL, con una cuestión de residencia de datos añadida.
Usted carga OpenSearch con documentos, tickets, registros y fichas, y su motor vectorial deriva embeddings densos almacenados junto a la carga útil en bruto — todo ello información personal cuando describe a personas en China. Guardarlo en un clúster en el extranjero es una transferencia transfronteriza según la PIPL (notificación, consentimiento separado y un mecanismo de transferencia, artículos 38–40), con un deber de almacenamiento en el continente para los operadores de infraestructuras críticas y los tratantes de grandes volúmenes (artículo 40; Ley de Ciberseguridad artículo 39 (antes artículo 37)); y, como un embedding permite la inversión y la inferencia de pertenencia, no elimina ese deber mediante la anonimización. La palanca legal es mantener el índice y los embeddings dentro del país — OpenSearch es Apache 2.0 y se puede autoalojar por completo en infraestructura del continente, y Amazon OpenSearch Service también se ofrece en la partición AWS China (Beijing/Ningxia) con licencia —, no hacer accesible un endpoint en el extranjero.
Esto es un mapa de riesgo, no un veredicto — qué mecanismo de transferencia encaja, y si se aplica un deber de localización, depende de su entidad, de sus volúmenes de datos y de a quién pertenecen los datos. Nuestro equipo de China puede cartografiar su exposición →
Instantánea de cumplimiento
- ! OpenSearch es un almacén de datos en reposo: los documentos indexados y los embeddings son datos personales
- ! Los embeddings no son anónimos; la inversión y la inferencia de pertenencia los mantienen como datos personales
- ✕ El OpenSearch gestionado global no tiene región en el continente; el índice está en el extranjero
- ! Amazon OpenSearch Service funciona en AWS China (Beijing/Ningxia) a través de un operador local
- ✓ El motor Apache 2.0 se autoaloja dentro del país; 21YunBox añade la entrega con registro ICP
Lo que la documentación oficial de OpenSearch dice sobre China
| Hecho | Fuente primaria |
|---|---|
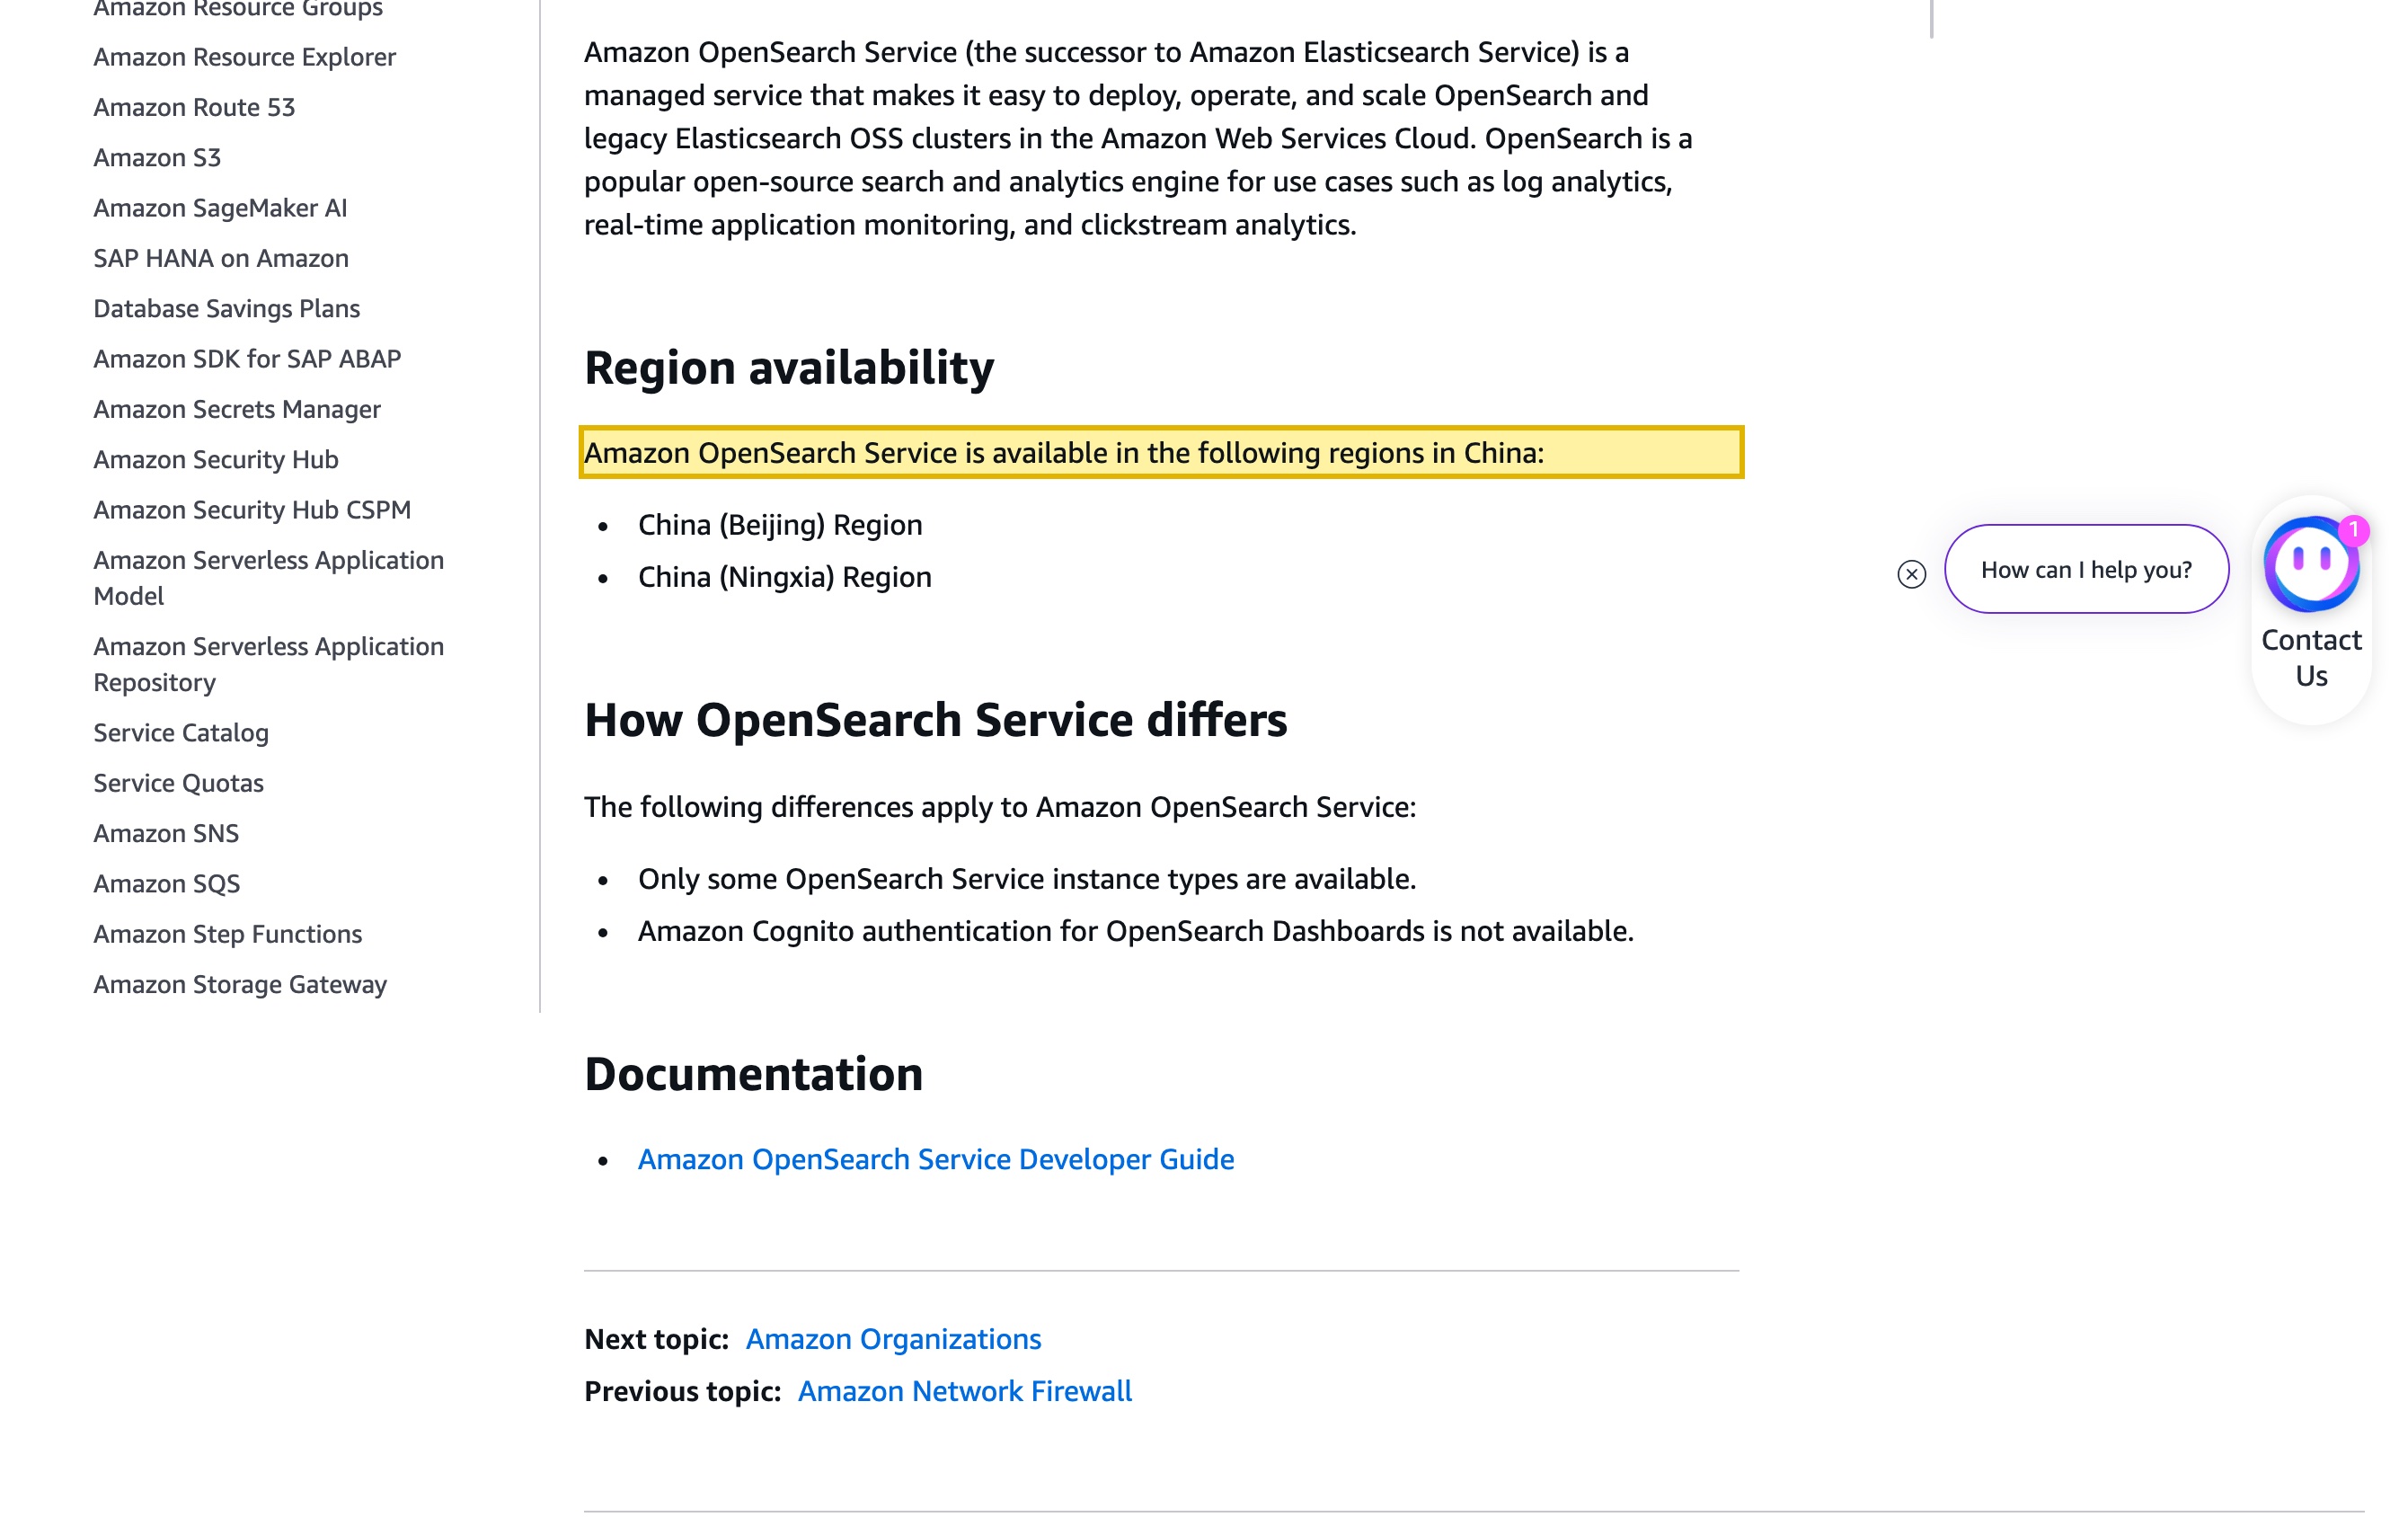
| Amazon OpenSearch Service está disponible dentro de la partición AWS China — una opción gestionada genuina dentro del país. La documentación de AWS para China afirma “Amazon OpenSearch Service is available in the following regions in China:” y enumera la región China (Beijing) y la región China (Ningxia) — la partición AWS China operada por socios locales con licencia (Sinnet en Beijing, NWCD en Ningxia). Necesita una cuenta independiente de AWS China y solo están disponibles algunos tipos de instancia, así que trátela como un aviso positivo, no como un pase global limpio — y distinta del servicio global Amazon OpenSearch Service, que no tiene región en China continental. | Documentación de AWS China — Amazon OpenSearch Service in Amazon Web Services China (docs.amazonaws.cn), consultado el 2026-10-10 |
| El motor OpenSearch es Apache 2.0 y se puede autoalojar por completo — la forma más sólida de la palanca dentro del país —, y su motor k-NN almacena embeddings. OpenSearch es el motor de búsqueda y vectorial de código abierto Apache 2.0, gobernado por la OpenSearch Software Foundation bajo la Linux Foundation, así que puede ejecutarlo en la infraestructura que elija, incluida China continental. Su motor vectorial k-NN integrado convierte texto e imágenes en embeddings de vectores densos almacenados en campos knn_vector para la búsqueda semántica y RAG — información personal en reposo cuando se deriva de los datos de sus usuarios chinos. | OpenSearch — opensearch.org (Apache 2.0; OpenSearch Software Foundation / Linux Foundation) y guía para desarrolladores de k-NN, consultado el 2026-10-10 |
| Indexar en el extranjero contenido de usuarios de China es una transferencia transfronteriza según la PIPL — y los embeddings no la eximen. Los documentos que indexa y los embeddings derivados de ellos son información personal cuando describen a personas en China, así que guardarlos en un clúster en el extranjero es una transferencia transfronteriza según la PIPL: usted, el responsable del tratamiento, debe notificar, obtener un consentimiento separado y cumplir un mecanismo de transferencia (una evaluación de seguridad de la CAC, el contrato estándar de la CAC o una certificación) según los artículos 38–40. Como un embedding permite la inversión y la inferencia de pertenencia, «solo enviamos vectores» no es una exención. | PIPL artículos 38–40 (transferencia transfronteriza de información personal), consultado el 2026-10-10 |
| Para los operadores de infraestructuras críticas y los tratantes de grandes volúmenes, los datos personales recogidos en China deben quedarse en el continente — ningún clúster en el extranjero puede cumplirlo. Los operadores de infraestructuras de información críticas y los responsables por encima de los umbrales de volumen de los reguladores deben almacenar dentro del país los datos personales recogidos en China (PIPL artículo 40; Ley de Ciberseguridad artículo 39 (antes artículo 37)). La reforma de la Ley de Ciberseguridad de 2025, en vigor desde el 1 de enero de 2026, renumeró el artículo de localización de datos del 37 al 39, sin cambios de fondo. Un clúster de OpenSearch autoalojado en infraestructura del continente, o la partición AWS China con licencia, puede cumplir ese deber donde el servicio gestionado global no puede. | PIPL artículo 40; Ley de Ciberseguridad artículo 39 (antes artículo 37), consultado el 2026-10-10 |
Fuentes verificadas por el Equipo de Cumplimiento de 21YunBox el 10 de octubre de 2026.
Para una aplicación orientada a China, la pregunta decisiva sobre OpenSearch no es si se puede llegar al endpoint de un clúster — es dónde se permite que resida el contenido que usted indexa y vectoriza. OpenSearch es un almacén de datos en reposo: usted lo carga con los documentos, tickets, registros y fichas que quiere buscar, y los guarda en un índice invertido y — mediante su motor vectorial k-NN integrado — como embeddings de vectores densos para la búsqueda semántica y RAG. Para sus usuarios en China, ese contenido es información personal que reposa allí donde funcione el motor. OpenSearch es el motor de código abierto Apache 2.0, bajo la OpenSearch Software Foundation (Linux Foundation), y se puede autoalojar por completo — que es exactamente la palanca. Tres frentes deciden el riesgo: la residencia y la transferencia transfronteriza del contenido indexado; que los embeddings son información personal que no se puede anonimizar; y mantener el índice dentro del país autoalojando el motor abierto en lugar de recurrir a una nube en el extranjero.
OpenSearch en China de un vistazo
| Qué lo decide | En los propios términos de OpenSearch — y la ley china |
|---|---|
| Qué carga en él | OpenSearch guarda los documentos, registros, tickets y fichas que usted indexa en un índice invertido y — mediante su motor vectorial k-NN — los embeddings de vectores densos, además de la carga útil y el texto fuente almacenados junto a ellos. Cuando ese contenido describe a personas en China, es información personal guardada en reposo, no una caché transitoria. |
| Dónde funciona el motor | O bien autoaloja el motor Apache 2.0 en la infraestructura que elija, o bien usa un servicio gestionado. El servicio global Amazon OpenSearch Service funciona en regiones de AWS fuera del continente, así que indexar datos de usuarios chinos en cualquier clúster en el extranjero es una transferencia transfronteriza realizada por usted (数据出境; PIPL artículos 38–40). Amazon OpenSearch Service también se ofrece en la partición AWS China (Beijing/Ningxia) a través de un operador local con licencia — una opción dentro del país, no un pase global. |
| Los embeddings son información personal | Un embedding k-NN se calcula a partir del texto o la imagen de una persona; permite la inversión (reconstrucción aproximada de la fuente) y la inferencia de pertenencia, así que no está anonimizado. Un almacén de embeddings de los datos de sus usuarios chinos es en sí mismo un almacén de información personal — «solo enviamos vectores, no datos en bruto» no es una exención transfronteriza. |
| Localización de datos y registros de consultas | Un operador de infraestructuras de información críticas o un tratante de grandes volúmenes debe conservar en el continente los datos personales recogidos en China (PIPL artículo 40; Ley de Ciberseguridad artículo 39 (antes artículo 37)). Las cadenas de búsqueda y los registros de consultas también llevan información personal y el mismo deber de residencia. |
| Llegar al endpoint no es el eje | Que el clúster responda no es la cuestión de cumplimiento. El movimiento duradero es mantener el índice y los embeddings dentro del país — autoalojar el motor de código abierto en infraestructura del continente, o usar la opción gestionada dentro del país con licencia — y minimizar y seudonimizar lo que se indexa. La aplicación pública que consulta el índice sigue conllevando un deber de registro ICP. |
Lo que realmente almacena — el contenido indexado y sus embeddings
OpenSearch es, en palabras de la propia AWS, un popular motor de búsqueda y analítica de código abierto para casos como la analítica de registros, la supervisión de aplicaciones en tiempo real y la analítica de clics (“a popular open-source search and analytics engine for use cases such as log analytics, real-time application monitoring, and clickstream analytics”). Lo que lo convierte en un objeto de cumplimiento no son las consultas que responde, sino lo que guarda para responderlas. Cuando usted indexa un documento, OpenSearch almacena el _source original y construye un índice invertido sobre sus campos; cuando ejecuta búsqueda semántica o RAG, su motor vectorial k-NN (a través de los componentes neural-search y ml-commons) convierte texto o imágenes en embeddings de vectores densos escritos en campos knn_vector, y la carga útil en bruto y los metadatos — ID de usuario, fragmentos de la fuente, marcas de tiempo — se almacenan habitualmente junto a cada vector para poder vincular una coincidencia con un registro.
Así que un clúster de OpenSearch construido con los tickets de soporte, los registros de chat, los perfiles y los documentos de sus usuarios chinos guarda su información personal tres veces: como el texto indexado original, como el índice invertido derivado de él y como los embeddings derivados de eso. Todo ello es información personal en reposo, y reside allí donde funcione el clúster — una región de EE. UU. o de la UE del servicio gestionado global, un clúster autoalojado en el extranjero o una infraestructura dentro del país. El índice no es una caché delante de sus datos; es sus datos, transformados.
Es un problema de residencia y de transferencia transfronteriza — y los embeddings no lo anonimizan — según la PIPL
Como el contenido indexado y sus embeddings son información personal, guardarlos en un clúster que funciona fuera del continente es una transferencia transfronteriza de información personal (数据出境) que regula directamente la Ley de Protección de Información Personal de China. Como responsable del tratamiento — usted, no el proveedor del motor —, debe notificar, obtener un consentimiento separado y cumplir un mecanismo de transferencia (una evaluación de seguridad de la CAC, el contrato estándar de la CAC o una certificación) según los artículos 38–40 de la PIPL. Si usted es un operador de infraestructuras de información críticas, o trata información personal por encima de los umbrales de volumen de los reguladores, esos datos recogidos en China también deben almacenarse en el continente (PIPL artículo 40; artículo 39 de la Ley de Ciberseguridad (antes artículo 37) — la reforma de la Ley de Ciberseguridad de 2025, en vigor desde el 1 de enero de 2026, renumeró el artículo de localización de datos del 37 al 39, sin cambios de fondo) — un deber de residencia que ningún clúster en el extranjero puede cumplir.
El frente que la mayoría de los equipos pasa por alto son los embeddings. Es tentador tratar un índice vectorial como exento porque almacena matrices de números de coma flotante en lugar de nombres y direcciones. Ese instinto se equivoca en lo que aquí importa. Un embedding se calcula directamente a partir del mensaje, el ticket o el documento de una persona, y conserva lo suficiente del original como para permitir la inversión — la reconstrucción aproximada del texto fuente — y la inferencia de pertenencia, es decir, determinar si el registro de una persona concreta estaba en el conjunto de entrenamiento o indexado. Un almacén de embeddings de los datos de sus usuarios chinos es, por tanto, en sí mismo un almacén de su información personal, con los mismos deberes de residencia y transfronterizos que el texto en bruto; «solo enviamos vectores, no datos en bruto» es un falso consuelo. Las cadenas de consulta y los registros de búsqueda están sujetos a la misma regla, porque también revelan quién buscó qué.
Llegar al endpoint no es la cuestión — mantener el índice dentro del país sí lo es
Que se pueda llegar a un endpoint de OpenSearch desde el continente no es el eje. El eje es dónde se permite que reposen el índice y los embeddings, y OpenSearch le da una respuesta inusualmente limpia: como el motor es Apache 2.0 y se puede autoalojar por completo, usted puede ejecutarlo en infraestructura dentro del país y mantener el índice y los embeddings en el continente — la forma honesta y sólida de la palanca. Cuando se prefiere un servicio gestionado, Amazon OpenSearch Service se ofrece dentro de la partición AWS China — la región China (Beijing), operada por Sinnet, y la región China (Ningxia), operada por NWCD —, lo que es una opción genuina de residencia dentro del país a través de un operador local con licencia (necesita una cuenta independiente de AWS China, y solo están disponibles algunos tipos de instancia). Trátela como un aviso positivo, no como un pase global limpio, y manténgala separada del servicio global Amazon OpenSearch Service (EE. UU., la UE y otras regiones), que no tiene región en China continental. Cualquiera de las dos vías dentro del país va acompañada de minimizar y seudonimizar lo que se indexa, y de gobernar cualquier transferencia residual. Lo que no es, es un conducto que responda a las consultas desde el continente mientras envía los datos al extranjero de todos modos — eso mantiene la información personal exactamente donde la ley no la quiere.
Esto es un mapa de riesgo, no un veredicto: si se aplica un deber de localización, y qué mecanismo transfronterizo encaja, depende de su entidad, de cuántos datos personales guarda y de quién son — concrete los detalles con asesoría legal antes de construir.
La vía legal — cartografiar, localizar, entregar
OpenSearch sigue siendo su motor de búsqueda y vectorial; nada se mueve fuera de él. Lo que 21YunBox añade es la capa de cumplimiento en torno al stack que ya utiliza — sin reconstruir y sin un segundo código base.
- cartografiar — inventariar qué contenido indexa y vectoriza, qué información personal lleva, si se almacenan embeddings de datos personales, dónde funciona el motor (una región gestionada global, un clúster autoalojado en el extranjero o dentro del país), la exposición de los registros de consultas y su base de consentimiento.
- localizar — mantener dentro del país el contenido indexado y los embeddings de usuarios de China: autoalojar el motor Apache 2.0 en infraestructura del continente, o usar la opción gestionada dentro del país con licencia, y minimizar y seudonimizar lo que se indexa, gobernando cualquier transferencia transfronteriza residual.
- entregar — la aplicación o el sitio que consulta el índice conlleva un deber de registro ICP y necesita una entrega conforme dentro del país (el 21YunBox Optimizer) por delante del stack que ya utiliza.
21YunBox es una capa conforme y un socio, no un competidor de OpenSearch. 21YunBox nunca utiliza ni recomienda ninguna forma de elusión. El resultado con el que cerramos es sencillo: OpenSearch funciona de forma legal y conforme para sus usuarios en China.
Solicitar una evaluación de cumplimiento →
Lectura relacionada:
- Transferencias transfronterizas de datos conforme a la PIPL
- La Ley de Ciberseguridad de China y la localización de datos
- Las medidas de evaluación de seguridad de la exportación de datos de China
- Cómo obtener un registro ICP para China
Preguntas frecuentes
¿Son nuestros datos de OpenSearch un problema según la ley china si son «solo un índice de vectores»?
Trátelos como información personal, porque eso es lo que son. OpenSearch almacena los documentos indexados originales, el índice invertido construido sobre ellos y — mediante su motor k-NN — embeddings junto con la carga útil y los metadatos, todo ello derivado de los textos, tickets y perfiles de sus usuarios. Un embedding permite la inversión (reconstrucción aproximada de la fuente) y la inferencia de pertenencia, así que no está anonimizado. Un índice construido a partir de la actividad de sus usuarios chinos guarda, por tanto, su información personal en forma transformada, y mantenerlo en un clúster en el extranjero es una transferencia transfronteriza según la PIPL — la notificación, el consentimiento separado y un mecanismo de transferencia recaen sobre usted como responsable.
¿Que Amazon OpenSearch Service esté en las regiones de AWS China nos hace conformes?
Ayuda, pero es un aviso positivo, no un sí automático. Amazon OpenSearch Service se ofrece en las regiones China (Beijing) y (Ningxia) de AWS, operadas por socios locales con licencia (Sinnet y NWCD) — una opción genuina de residencia dentro del país que necesita una cuenta independiente de AWS China y ofrece solo algunos tipos de instancia. Mantener el índice dentro del país resuelve la cuestión de la residencia, pero usted sigue debiendo notificación y consentimiento separado, minimización de datos y — si algún dato sigue saliendo del continente — un mecanismo de transferencia. El servicio global Amazon OpenSearch Service, en cambio, no tiene región en China continental.
¿Puede 21YunBox ayudarnos a que nuestra aplicación basada en OpenSearch funcione en China?
Sí. Nuestro equipo de China cartografía dónde están su contenido indexado y sus embeddings, determina su posición transfronteriza y de residencia de datos según la PIPL para su entidad, sus volúmenes de datos y sus usuarios, y pone en marcha la vía legal dentro del país — autoalojando el motor Apache 2.0 en infraestructura del continente o usando la opción gestionada dentro del país con licencia —, además de la entrega dentro del país, con registro ICP, que necesita la aplicación pública, por delante del stack que ya utiliza y sin reconstruir. Póngase en contacto para revisar su caso concreto.


