¿Funciona Elasticsearch en China? Transferencia transfronteriza según la PIPL, residencia de datos y autoalojamiento
Elasticsearch es a la vez un motor de búsqueda de texto completo y una base de datos vectorial: los documentos que indexa y los embeddings de vectores densos derivados de ellos son información personal almacenada en reposo, y Elastic Cloud no tiene ninguna región en China continental — de modo que indexar allí los datos de sus usuarios en China es una transferencia transfronteriza según la PIPL. Un análisis centrado en el cumplimiento de la exposición en residencia y de la palanca del autoalojamiento dentro del país.
¿Funciona Elasticsearch en China?
Elasticsearch es un almacén de datos en reposo con el contenido de sus usuarios — los documentos que indexa y los embeddings de vectores densos derivados de ellos — y Elastic Cloud no tiene ninguna región en China continental, de modo que un índice orientado a China reside en el extranjero: un problema de residencia y de transferencia transfronteriza, no de velocidad.
Usted carga Elasticsearch con documentos, datos estructurados, logs y los embeddings que calcula a partir de ellos para la búsqueda kNN y la RAG — todo ello construido a partir de los mensajes, los perfiles y los archivos de sus usuarios, y por tanto información personal cuando esos usuarios están en China. Indexarlo en una región de Elastic Cloud en el extranjero (AWS, GCP o Azure — la más cercana es Hong Kong, no el continente) es una transferencia transfronteriza según la PIPL (notificación, un consentimiento separado y un mecanismo de transferencia, artículos 38–40), con un deber de almacenamiento en el continente para los operadores de infraestructuras de información críticas y los tratantes de grandes volúmenes (artículo 40; artículo 39 de la Ley de Ciberseguridad (antes artículo 37)). Los embeddings no lo anonimizan — admiten inversión e inferencia de pertenencia, así que un almacén vectorial sigue siendo un almacén de información personal. Como Elasticsearch es de código abierto (AGPL desde 2024) y totalmente autoalojable, la palanca legal es mantener el índice y los embeddings dentro del país — autoalojando el motor abierto en infraestructura del continente o utilizando un despliegue gestionado con licencia dentro del país —, no hacer accesible un endpoint en el extranjero.
Esto es un mapa de riesgo, no un veredicto — qué mecanismo de transferencia encaja y si le vincula un deber de localización depende de su entidad, de sus volúmenes de datos y de quién son los datos. Nuestro equipo de China puede cartografiar su exposición →
Instantánea de cumplimiento
- ! Elastic Cloud se ejecuta en AWS, GCP y Azure — la región más cercana es Hong Kong, no el continente
- ! Lo que indexa — documentos y embeddings de vectores densos — son datos personales en reposo
- ! Los embeddings no son anónimos — la inversión y la inferencia de pertenencia recuperan a la persona
- ✕ Elastic Cloud no tiene región en China continental, así que no puede cumplir la localización de datos
- ! Alibaba Cloud Elasticsearch funciona dentro del país a través de un operador con licencia — una advertencia, no un aprobado
- ✓ Autoalojar el motor de código abierto (AGPL) dentro del país; el ICP recae en la aplicación que va delante
Lo que la documentación oficial de Elasticsearch dice sobre China
| Hecho | Fuente primaria |
|---|---|
| Elasticsearch vuelve a ser de código abierto y totalmente autoalojable — la palanca para mantener los datos dentro del país. En agosto de 2024, Elastic añadió la opción de licencia AGPL (AGPLv3), aprobada por la OSI, junto a la Elastic License v2 y la SSPL, y escribió que “Elasticsearch and Kibana can be called Open Source again.” (Elasticsearch y Kibana pueden volver a llamarse código abierto). Como puede ejecutar el mismo motor en su propio hardware, puede alojar el clúster — índice y embeddings de vectores densos — en infraestructura del continente en lugar de en una región gestionada en el extranjero. | Blog de Elastic — “Elasticsearch Is Open Source. Again!” (Shay Banon, 29 de agosto de 2024), consultado el 2026-10-10 |
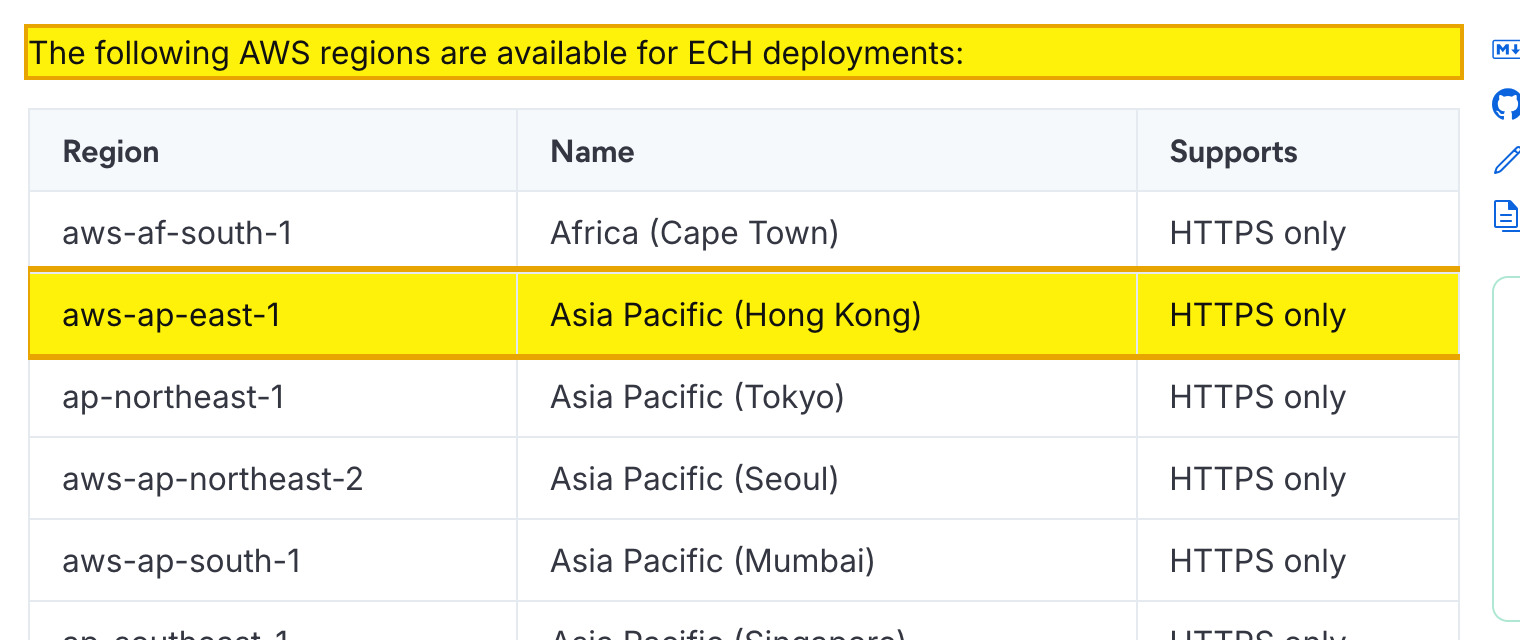
| Elastic Cloud no tiene región en China continental — y almacena embeddings de vectores densos, no solo texto. La propia página de regiones de Elastic Cloud Hosted de Elastic enumera ubicaciones de AWS, GCP y Azure; su región de Asia-Pacífico más cercana es Hong Kong (aws-ap-east-1), y ninguna está dentro de China continental. Elasticsearch indexa tanto documentos (en un índice invertido) como embeddings mediante su tipo de campo dense_vector para la búsqueda kNN — de modo que un despliegue orientado a China en Elastic Cloud mantiene ese contenido en el extranjero. | Elastic Docs — Elastic Cloud Hosted regions; Elastic Docs — kNN / dense_vector, consultado el 2026-10-10 |
| Indexar datos de usuarios en China en un clúster en el extranjero es una transferencia transfronteriza según la PIPL, con un deber de almacenamiento dentro del país para algunos responsables del tratamiento. Conservar información personal en una región en el extranjero activa las normas transfronterizas de la PIPL — notificación, un consentimiento separado y un mecanismo de transferencia (una evaluación de seguridad de la CAC, el contrato estándar de la CAC o una certificación), artículos 38–40. Un operador de infraestructuras de información críticas o un tratante de grandes volúmenes debe almacenar en el continente la información personal recogida en China (artículo 40 de la PIPL; artículo 39 de la Ley de Ciberseguridad (antes artículo 37) — la reforma de 2025 de la Ley de Ciberseguridad, en vigor desde el 1 de enero de 2026, renumeró el artículo de localización de datos del 37 al 39, sin cambios de fondo). | PIPL, artículos 38–40 (traducción de DigiChina/Stanford); Ley de Ciberseguridad, artículo 39 (antes artículo 37), consultado el 2026-10-10 |
| Los embeddings se derivan de datos personales y no constituyen anonimización. La PIPL define la información personal como la información relativa a personas físicas identificadas o identificables y solo trata como fuera de su ámbito los datos verdaderamente anonimizados (artículo 4). Un embedding vectorial se calcula a partir del texto o la imagen de una persona y admite inversión (reconstrucción aproximada del original) e inferencia de pertenencia, de modo que un almacén de embeddings de los datos de sus usuarios sigue siendo un almacén de información personal — «solo enviamos vectores» no lo saca de los deberes de residencia y de transferencia transfronteriza de la PIPL. | PIPL, artículo 4 (traducción de DigiChina/Stanford), consultado el 2026-10-10 |
Fuentes verificadas por el Equipo de Cumplimiento de 21YunBox el 10 de octubre de 2026.
Para una aplicación orientada a China, la cuestión sobre Elasticsearch no es si un clúster responderá a una consulta — lo hará —, sino dónde puede residir el contenido con el que lo alimenta. Elasticsearch es un almacén de datos en reposo en dos sentidos a la vez: un motor de búsqueda de texto completo que guarda en un índice invertido los documentos, los datos estructurados y los logs que usted indexa, y una base de datos vectorial que guarda embeddings de vectores densos en su tipo de campo dense_vector, que impulsan la búsqueda de k vecinos más cercanos (kNN) para la búsqueda semántica y la RAG. Ambos se construyen a partir de los mensajes, los perfiles y los archivos de sus usuarios — información personal en forma transformada. El motor vuelve a ser de código abierto y totalmente autoalojable, pero Elastic Cloud, la oferta gestionada, se ejecuta en AWS, GCP y Azure sin ninguna región en China continental. Así que las cuestiones decisivas son la residencia y la transferencia transfronteriza, el hecho de que los embeddings no anonimizan a las personas que hay detrás y la palanca de autoalojar el motor abierto dentro del país.
Elasticsearch en China de un vistazo
| Qué lo decide | En los propios términos de Elasticsearch — y la ley china |
|---|---|
| Lo que carga en él | Documentos, datos estructurados, logs y chats que indexa en un índice invertido, además de los embeddings de vectores densos que Elasticsearch calcula a partir de ellos para la búsqueda kNN y la RAG. Cuando sus usuarios están en China, eso es su información personal almacenada en reposo. |
| Dónde se ejecuta el motor | Elastic Cloud (gestionado) se ejecuta en AWS, GCP y Azure — su región de Asia-Pacífico más cercana es Hong Kong (aws-ap-east-1), que no es China continental. Indexar allí datos de usuarios en China es una transferencia transfronteriza (数据出境) según los artículos 38 a 40 de la PIPL; autoalojar el motor abierto los mantiene dentro del país. |
| Los embeddings son información personal | Un vector se calcula a partir del texto o la imagen de una persona; admite inversión (reconstrucción aproximada) e inferencia de pertenencia, de modo que no está anonimizado. Un almacén de embeddings de los datos de sus usuarios es en sí mismo un almacén de información personal — «solo vectores, no datos en bruto» es un falso consuelo. |
| Localización de datos y logs de consultas | Un operador de infraestructuras de información críticas o un tratante de grandes volúmenes debe conservar en el continente los datos personales recogidos en China (artículo 40 de la PIPL; artículo 39 de la Ley de Ciberseguridad, antes artículo 37). Los logs de consultas también pueden contener información personal. Una región de Elastic Cloud en el extranjero no cumple nada de esto. |
| Lo decisivo no es la accesibilidad | Si un clúster responde a una consulta nunca fue la cuestión. La palanca es mantener el índice y los embeddings dentro del país — autoalojando el motor de código abierto (AGPL) o mediante un despliegue gestionado con licencia dentro del país —, minimizar y seudonimizar lo que indexa y llevar el registro ICP en la aplicación que va delante. |
Lo que realmente almacena — contenido indexado y sus embeddings
Elasticsearch se gana su lugar guardando sus datos, no haciéndolos pasar. Como motor de búsqueda, conserva cada documento que usted indexa — tickets de soporte, fichas de producto, perfiles de usuario, logs, transcripciones de chat — en un índice invertido diseñado para la recuperación rápida de texto completo. Como base de datos vectorial, guarda embeddings de vectores densos en su tipo de campo dense_vector, que impulsan la búsqueda de k vecinos más cercanos (kNN) para la búsqueda semántica y la generación aumentada por recuperación; la mayoría de los diseños almacenan además el texto o la carga útil originales junto a cada vector para que una coincidencia pueda mostrarse y rastrearse. Cada una de esas estructuras se deriva del propio contenido de sus usuarios. Cuando esos usuarios están en China, el índice no es un residuo accesorio — es un almacén de su información personal en reposo, y reside allí donde se ejecute el clúster. Por eso la cuestión decisiva es de ubicación, no de latencia: ¿dónde puede Elasticsearch guardar todo esto?
Es un problema de residencia y de transferencia transfronteriza según la PIPL — y los embeddings no lo anonimizan
Ejecute ese clúster en Elastic Cloud y la geografía responde a la pregunta por usted. El servicio gestionado de Elastic funciona en AWS, GCP y Azure, y su propia página de regiones de Elastic Cloud Hosted no enumera ninguna ubicación dentro de China continental — la más cercana es Hong Kong (aws-ap-east-1), que no es el continente a efectos de localización de datos. Indexar los documentos y los embeddings de sus usuarios chinos en una región en el extranjero es, por tanto, una transferencia transfronteriza de información personal (数据出境) según la Ley de Protección de Información Personal de China: usted — el responsable del tratamiento, no Elastic — debe notificar, obtener un consentimiento separado y cumplir un mecanismo de transferencia (una evaluación de seguridad de la CAC, el contrato estándar de la CAC o una certificación) conforme a los artículos 38 a 40. Si usted es un operador de infraestructuras de información críticas o un tratante de grandes volúmenes, la información personal recogida en China debe almacenarse en el continente (artículo 40 de la PIPL; artículo 39 de la Ley de Ciberseguridad (antes artículo 37) — la reforma de 2025 de la Ley de Ciberseguridad, en vigor desde el 1 de enero de 2026, renumeró el artículo de localización de datos del 37 al 39, sin cambios de fondo) — un deber que ninguna región en el extranjero puede cumplir.
Y los embeddings no le sacan de esto. Resulta tentador pensar que un índice vectorial está exento porque almacena matrices de números de coma flotante en lugar de nombres y correos electrónicos — «solo enviamos vectores, no datos en bruto». Ese consuelo es falso. Un embedding se calcula directamente a partir del texto, el documento o la imagen de una persona, y conserva lo suficiente del original como para admitir inversión — la reconstrucción aproximada del texto de origen — e inferencia de pertenencia, que revela si los datos de una persona concreta están en el almacén. La PIPL define la información personal como la información relativa a personas físicas identificadas o identificables y solo deja fuera de su ámbito los datos verdaderamente anonimizados (artículo 4); un embedding de los datos de sus usuarios no está anonimizado ni queda fuera de su ámbito. Un almacén de embeddings de datos personales de usuarios chinos conlleva los mismos deberes de residencia y de transferencia transfronteriza que el texto en bruto del que procede.
Alcanzar el endpoint no es la cuestión — mantener el índice dentro del país, sí
Nada de esto depende de si un clúster en Oregón o Singapur responderá a una consulta desde Shanghái. Lo hará. La exposición está en que el índice y sus embeddings — información personal — permanecen en reposo fuera del continente. La palanca limpia se deriva directamente de lo que es Elasticsearch: código abierto. Desde que Elastic añadió la opción AGPL en 2024, usted puede ejecutar el mismo motor en su propia infraestructura dentro de China, manteniendo el índice y los embeddings dentro del país, y minimizar y seudonimizar lo que indexa para que, de entrada, se conserve menos información personal. Cuando se requiere un servicio totalmente gestionado, un Elasticsearch gestionado con licencia dentro del país — por ejemplo, Alibaba Cloud Elasticsearch, ofrecido a través de las regiones de Alibaba Cloud en el continente — es una opción positiva con reservas: mantiene los datos dentro del país, pero es un operador y un contrato distintos, y aún hay que resolver su base de consentimiento, su posición en materia de transferencias y el tratamiento de los logs de consultas. Lo que la palanca no es: una forma de mantener los datos en el extranjero y hacer que un endpoint lejano parezca local; localizar significa mantener el almacén de datos en reposo en una vía dentro del país, no encaminarlo fuera del continente y de vuelta.
Esto es un mapa de riesgo, no un veredicto: si le vincula un deber de localización, qué mecanismo transfronterizo encaja y qué parte de su índice cuenta como información personal depende de su entidad, de sus volúmenes de datos y de quién son los datos — concrete los detalles con asesoría legal antes de construir.
La vía legal — cartografiar, localizar, entregar
21YunBox es una capa de cumplimiento en torno al stack que ya utiliza, no un sustituto de Elasticsearch ni un competidor de Elastic. El trabajo tiene tres partes. Cartografiar: inventariar lo que indexa y vectoriza, qué información personal contienen esos documentos y embeddings, dónde se ejecuta hoy el clúster, qué captan sus logs de consultas y la base de consentimiento en la que se apoya. Localizar: mantener dentro del país el índice y los embeddings de sus usuarios en China — autoalojando el motor de código abierto (AGPL) en infraestructura del continente o utilizando un despliegue gestionado con licencia dentro del país —, minimizar y seudonimizar lo que se indexa y gobernar cualquier transferencia transfronteriza residual; se trata de mantener el almacén de datos en reposo en una vía dentro del país. Entregar: la aplicación que consulta el índice conlleva un deber de registro ICP y necesita una entrega conforme dentro del país — el 21YunBox Optimizer, situado por delante del stack que ya utiliza, sin reconstruir y sin una segunda base de código. 21YunBox nunca utiliza ni recomienda ninguna forma de elusión. El resultado es un despliegue de Elasticsearch que funciona de forma legal y conforme para sus usuarios en China.
Solicitar una evaluación de cumplimiento →
Lectura relacionada:
- Transferencias transfronterizas de datos conforme a la PIPL
- La Ley de Ciberseguridad de China, explicada
- Las medidas de evaluación de seguridad para la exportación de datos de China
- Cómo obtener un registro ICP para China
Preguntas frecuentes
¿Son realmente información personal los embeddings si solo son vectores?
Trátelos como información personal, porque es lo que son. Un embedding se calcula directamente a partir del mensaje, el documento o la imagen de un usuario, y se ha demostrado que los embeddings admiten inversión — la reconstrucción aproximada del texto de origen — e inferencia de pertenencia. Además, en la mayoría de los diseños Elasticsearch almacena el documento o la carga útil en bruto junto al vector. Así que un índice construido a partir de la actividad de sus usuarios chinos conserva su información personal en forma transformada, no anonimizada; según el artículo 4 de la PIPL, solo los datos verdaderamente anonimizados quedan fuera de su ámbito. Si se conserva en una región de Elastic Cloud en el extranjero, es una transferencia transfronteriza, y las obligaciones recaen en usted como responsable del tratamiento.
¿No es el autoalojamiento de Elasticsearch la respuesta limpia para China?
Es la palanca más sólida, y es real: desde que Elastic añadió la opción AGPL en 2024, Elasticsearch es de código abierto y usted puede ejecutar el mismo motor en su propia infraestructura dentro del continente, manteniendo el índice y sus embeddings dentro del país. Eso resuelve la residencia de datos. Por sí solo no lo resuelve todo — la aplicación pública que consulta el clúster sigue necesitando un registro ICP si atiende a un público del continente, sus deberes de consentimiento y notificación según la PIPL pasan a ser de su gestión, y los propios logs de consultas pueden contener información personal. Un Elasticsearch gestionado con licencia dentro del país (por ejemplo, Alibaba Cloud Elasticsearch en las regiones de Alibaba Cloud en el continente) es una alternativa positiva con reservas — dentro del país, pero con un operador y un contrato distintos.
¿Puede 21YunBox ayudarnos a que nuestra aplicación basada en Elasticsearch funcione en China?
Sí. Nuestro equipo de China puede inventariar lo que indexa y vectoriza y la información personal que contiene, cartografiar su posición en materia de transferencia transfronteriza y residencia de datos según la PIPL para su entidad y sus volúmenes de datos, y poner en marcha una vía de Elasticsearch autoalojada dentro del país — además de la entrega dentro del país, con registro ICP, que necesita la aplicación que va delante —, en torno al stack que ya utiliza, sin reconstruir y sin abandonar Elasticsearch. Póngase en contacto con nosotros para analizar su caso concreto.


