Elasticsearch fonctionne-t-il en Chine ? Transfert transfrontalier PIPL, résidence des données et auto-hébergement
Elasticsearch est à la fois un moteur de recherche plein texte et une base de données vectorielle : les documents que vous indexez et les plongements vectoriels denses qui en sont dérivés sont des informations personnelles détenues au repos, et Elastic Cloud n'a aucune région en Chine continentale — de sorte qu'indexer les données de vos utilisateurs en Chine là-bas est un transfert transfrontalier au titre de la PIPL. Un regard, d'abord sous l'angle de la conformité, sur l'exposition de résidence et le levier de l'auto-hébergement sur le territoire.
Elasticsearch fonctionne-t-il en Chine ?
Elasticsearch est un dépôt de données au repos du contenu de vos utilisateurs — les documents que vous indexez et les plongements vectoriels denses qui en sont dérivés — et Elastic Cloud n'a aucune région en Chine continentale, de sorte qu'un index tourné vers la Chine réside à l'étranger : un problème de résidence et de transfert transfrontalier, non de vitesse.
Vous chargez Elasticsearch avec des documents, enregistrements, journaux et les plongements qu'il calcule à partir d'eux pour la recherche kNN et le RAG — tous construits à partir des messages, profils et fichiers de vos utilisateurs, donc toutes des informations personnelles lorsque ces utilisateurs sont en Chine. Indexer cela dans une région Elastic Cloud à l'étranger (AWS, GCP ou Azure — la plus proche est Hong Kong, non le continent) est un transfert transfrontalier au titre de la PIPL (information, un consentement distinct et un mécanisme de transfert, articles 38 à 40), avec une obligation de stockage sur le continent pour les opérateurs d'infrastructure d'information critique et les responsables à grand volume (article 40 ; loi sur la cybersécurité article 39 (anciennement l'article 37)). Les plongements n'anonymisent pas cela — ils permettent l'inversion et l'inférence d'appartenance, un dépôt de vecteurs reste donc un dépôt d'informations personnelles. Parce qu'Elasticsearch est open source (AGPL depuis 2024) et entièrement auto-hébergeable, le levier légal consiste à garder l'index et les plongements sur le territoire — auto-héberger le moteur open source sur une infrastructure du continent, ou utiliser un déploiement géré agréé sur le territoire — non à rendre accessible un point de terminaison à l'étranger.
Il s'agit d'une image des risques, pas d'un verdict — quel mécanisme de transfert convient et si une obligation de localisation vous lie dépendent de votre entité, de vos volumes de données et de qui sont les données. Notre équipe Chine peut cartographier votre exposition →
Aperçu de conformité
- ! Elastic Cloud s'exécute sur AWS, GCP et Azure — la région la plus proche est Hong Kong, non le continent
- ! Ce que vous indexez — documents et plongements vectoriels denses — est des données personnelles au repos
- ! Les plongements ne sont pas anonymes — l'inversion et l'inférence d'appartenance retrouvent la personne
- ✕ Elastic Cloud n'a aucune région en Chine continentale, il ne peut donc satisfaire la localisation des données
- ! Alibaba Cloud Elasticsearch s'exécute sur le territoire via un opérateur agréé — un warn, non un feu vert
- ✓ Auto-hébergez le moteur open source (AGPL) sur le territoire ; l'ICP repose sur l'application en façade
Ce que la documentation officielle de Elasticsearch dit de la Chine
| Fait | Source primaire |
|---|---|
| Elasticsearch est de nouveau open source et entièrement auto-hébergeable — le levier pour garder les données sur le territoire. En août 2024, Elastic a ajouté l'option de licence AGPL (AGPLv3) approuvée par l'OSI aux côtés de l'Elastic License v2 et de la SSPL, en écrivant “Elasticsearch and Kibana can be called Open Source again.” Parce que vous pouvez exploiter le même moteur sur votre propre matériel, vous pouvez héberger le cluster — index et plongements vectoriels denses — sur une infrastructure du continent plutôt que sur une région gérée à l'étranger. | Blog Elastic — « Elasticsearch Is Open Source. Again! » (Shay Banon, 29 août 2024), consulté le 2026-10-10 |
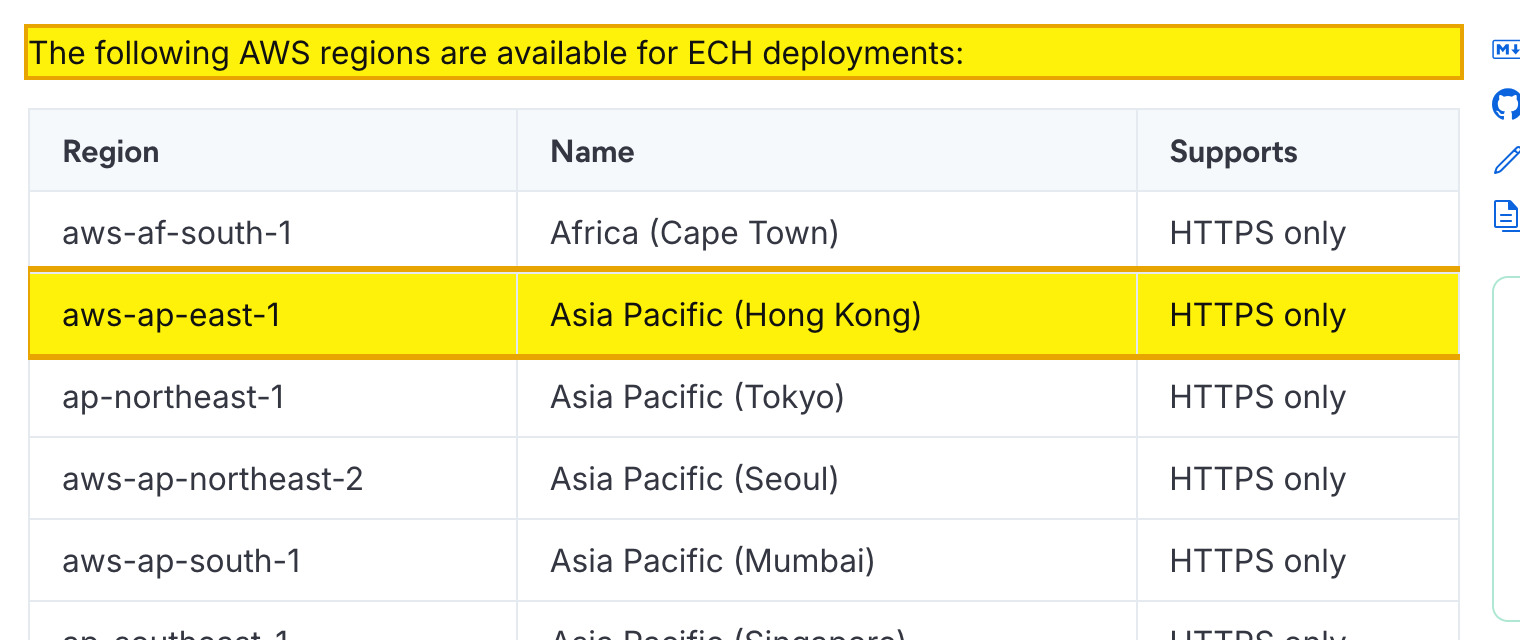
| Elastic Cloud n'a aucune région en Chine continentale — et il stocke des plongements vectoriels denses, non seulement du texte. La propre page des régions Elastic Cloud Hosted d'Elastic énumère des emplacements AWS, GCP et Azure ; sa région Asie-Pacifique la plus proche est Hong Kong (aws-ap-east-1), et aucune ne se trouve en Chine continentale. Elasticsearch indexe à la fois des documents (dans un index inversé) et des plongements via son type de champ dense_vector pour la recherche kNN — de sorte qu'un déploiement tourné vers la Chine sur Elastic Cloud garde ce contenu à l'étranger. | Elastic Docs — Elastic Cloud Hosted regions ; Elastic Docs — kNN / dense_vector, consulté le 2026-10-10 |
| Indexer les données des utilisateurs en Chine dans un cluster à l'étranger est un transfert transfrontalier PIPL, avec une obligation de stockage sur le territoire pour certains responsables. Détenir des informations personnelles dans une région à l'étranger déclenche les règles transfrontalières de la PIPL — information, un consentement distinct, et un mécanisme de transfert (une évaluation de sécurité de la CAC, le contrat type de la CAC, ou une certification), articles 38 à 40. Un opérateur d'infrastructure d'information critique ou un responsable à grand volume doit stocker les informations personnelles collectées en Chine sur le continent (PIPL article 40 ; loi sur la cybersécurité article 39 (anciennement l'article 37) — l'amendement 2025 de la loi sur la cybersécurité, entré en vigueur le 1er janvier 2026, a renuméroté l'article de localisation des données de 37 à 39, sans en changer la substance). | PIPL articles 38 à 40 (traduction DigiChina/Stanford) ; loi sur la cybersécurité article 39 (anciennement l'article 37), consulté le 2026-10-10 |
| Les plongements sont dérivés de données personnelles et ne sont pas une anonymisation. La PIPL définit les informations personnelles comme les informations relatives à des personnes physiques identifiées ou identifiables et ne traite comme hors de son champ que les données réellement anonymisées (article 4). Un plongement vectoriel est calculé à partir du texte ou de l'image d'une personne et permet l'inversion (reconstruction approximative de la source) et l'inférence d'appartenance, un dépôt de plongements des données de vos utilisateurs reste donc un dépôt d'informations personnelles — « nous n'envoyons que des vecteurs » ne le sort pas des obligations de résidence et transfrontalières de la PIPL. | PIPL article 4 (traduction DigiChina/Stanford), consulté le 2026-10-10 |
Sources vérifiées par Équipe Conformité 21YunBox le 10 octobre 2026.
Pour une application tournée vers la Chine, la question à propos d’Elasticsearch n’est pas de savoir si un cluster répondra à une requête — il le fera — mais où le contenu que vous lui donnez a le droit de résider. Elasticsearch est un dépôt de données au repos en deux sens à la fois : un moteur de recherche plein texte qui détient les documents, enregistrements et journaux que vous indexez dans un index inversé, et une base de données vectorielle qui détient des plongements vectoriels denses dans son type de champ dense_vector, alimentant la recherche k-plus-proches-voisins (kNN) pour la recherche sémantique et le RAG. Les deux sont construits à partir des messages, profils et fichiers de vos utilisateurs — des informations personnelles sous forme transformée. Le moteur est de nouveau open source et entièrement auto-hébergeable, mais Elastic Cloud, l’offre gérée, s’exécute sur AWS, GCP et Azure sans aucune région en Chine continentale. Les questions décisives sont donc la résidence et le transfert transfrontalier, le fait que les plongements n’anonymisent pas les personnes derrière eux, et le levier de l’auto-hébergement du moteur open source sur le territoire.
Elasticsearch en Chine en un coup d’œil
| Ce qui le détermine | Dans les termes d'Elasticsearch — et au regard du droit chinois |
|---|---|
| Ce que vous y chargez | Les documents, enregistrements, journaux et discussions que vous indexez dans un index inversé, plus les plongements vectoriels denses qu'Elasticsearch calcule à partir d'eux pour la recherche kNN et le RAG. Lorsque vos utilisateurs sont en Chine, ce sont leurs informations personnelles détenues au repos. |
| Où le moteur s'exécute | Elastic Cloud (géré) s'exécute sur AWS, GCP et Azure — sa région Asie-Pacifique la plus proche est Hong Kong (aws-ap-east-1), qui n'est pas la Chine continentale. Indexer les données des utilisateurs en Chine là-bas est un transfert transfrontalier (数据出境) au titre des articles 38 à 40 de la PIPL ; auto-héberger le moteur open source les garde sur le territoire. |
| Les plongements sont des informations personnelles | Un vecteur est calculé à partir du texte ou de l'image d'une personne ; il permet l'inversion (reconstruction approximative) et l'inférence d'appartenance, il n'est donc pas anonymisé. Un dépôt de plongements des données de vos utilisateurs est lui-même un dépôt d'informations personnelles — « seulement des vecteurs, pas des données brutes » est un faux réconfort. |
| Localisation des données et journaux de requêtes | Un opérateur d'infrastructure d'information critique ou un responsable de traitement à grand volume doit garder les données personnelles collectées en Chine sur le continent (PIPL article 40 ; loi sur la cybersécurité article 39, anciennement l'article 37). Les journaux de requêtes peuvent eux aussi transporter des informations personnelles. Une région Elastic Cloud à l'étranger ne satisfait rien de cela. |
| L'accessibilité n'est pas l'axe | Qu'un cluster réponde à une requête n'a jamais été la question. Le levier consiste à garder l'index et les plongements sur le territoire — auto-héberger le moteur open source (AGPL), ou un déploiement géré agréé sur le territoire — minimiser et pseudonymiser ce que vous indexez, et porter la déclaration ICP sur l'application en façade. |
Ce que vous stockez réellement — contenu indexé et ses plongements
Elasticsearch gagne sa place en détenant vos données, non en les laissant passer. En tant que moteur de recherche, il conserve chaque document que vous indexez — tickets de support, fiches produit, profils utilisateurs, journaux, transcriptions de discussion — dans un index inversé conçu pour une récupération plein texte rapide. En tant que base de données vectorielle, il conserve des plongements vectoriels denses dans son type de champ dense_vector, qui alimentent la recherche k-plus-proches-voisins (kNN) pour la recherche sémantique et la génération augmentée par récupération ; la plupart des conceptions stockent aussi le texte ou la charge utile d’origine aux côtés de chaque vecteur afin qu’une correspondance puisse être affichée et tracée. Chacune de ces structures est dérivée du contenu de vos propres utilisateurs. Lorsque ces utilisateurs sont en Chine, l’index n’est pas un résidu accessoire — c’est un dépôt de leurs informations personnelles au repos, et il réside là où le cluster s’exécute. C’est pourquoi la question décisive est une question d’emplacement, non de latence : où Elasticsearch a-t-il le droit de conserver tout cela ?
C’est un problème de résidence et de transfert transfrontalier — et les plongements ne l’anonymisent pas — au titre de la PIPL
Exploitez ce cluster sur Elastic Cloud et la géographie répond à la question pour vous. Le service géré d’Elastic s’exécute sur AWS, GCP et Azure, et sa propre page des régions Elastic Cloud Hosted ne liste aucun emplacement à l’intérieur de la Chine continentale — le plus proche est Hong Kong (aws-ap-east-1), qui n’est pas le continent aux fins de la localisation des données. Indexer les documents et plongements de vos utilisateurs chinois dans une région à l’étranger est donc un transfert transfrontalier d’informations personnelles (数据出境) au titre de la loi chinoise sur la protection des informations personnelles : vous — le responsable de traitement, non Elastic — devez informer, obtenir un consentement distinct, et satisfaire un mécanisme de transfert (une évaluation de sécurité de la CAC, le contrat type de la CAC, ou une certification) au titre des articles 38 à 40. Si vous êtes opérateur d’infrastructure d’information critique ou responsable de traitement à grand volume, les informations personnelles collectées en Chine doivent être stockées sur le continent (PIPL article 40 ; loi sur la cybersécurité article 39 (anciennement l’article 37) — l’amendement 2025 de la loi sur la cybersécurité, entré en vigueur le 1er janvier 2026, a renuméroté l’article de localisation des données de 37 à 39, sans en changer la substance) — une obligation qu’aucune région à l’étranger ne peut satisfaire.
Et les plongements ne vous en sortent pas. Il est tentant de penser qu’un index vectoriel est exempté parce qu’il stocke des tableaux de nombres à virgule flottante plutôt que des noms et des e-mails — « nous n’envoyons que des vecteurs, pas des données brutes ». Ce réconfort est faux. Un plongement est calculé directement à partir du texte, du document ou de l’image d’une personne, et il préserve suffisamment de l’original pour permettre l’inversion — la reconstruction approximative du texte source — et l’inférence d’appartenance, qui révèle si l’enregistrement d’une personne donnée se trouve dans le dépôt. La PIPL définit les informations personnelles comme les informations relatives à des personnes physiques identifiées ou identifiables et ne place hors de son champ que les données réellement anonymisées (article 4) ; un plongement des données de vos utilisateurs n’est ni anonymisé ni hors champ. Un dépôt de plongements des données personnelles d’utilisateurs chinois porte les mêmes obligations de résidence et transfrontalières que le texte brut dont il provient.
Atteindre le point de terminaison n’est pas la question — garder l’index sur le territoire l’est
Rien de tout cela ne concerne la question de savoir si un cluster en Oregon ou à Singapour répondra à une requête depuis Shanghai. Il le fera. L’exposition, c’est que l’index et ses plongements — des informations personnelles — se trouvent au repos hors du continent. Le levier propre découle directement de ce qu’est Elasticsearch : open source. Depuis qu’Elastic a ajouté l’option AGPL en 2024, vous pouvez exploiter le même moteur sur votre propre infrastructure à l’intérieur de la Chine, en gardant l’index et les plongements sur le territoire, et minimiser et pseudonymiser ce que vous indexez afin que moins d’informations personnelles soient détenues en premier lieu. Là où un service entièrement géré est requis, un Elasticsearch géré agréé sur le territoire — par exemple Alibaba Cloud Elasticsearch proposé via les régions continentales d’Alibaba Cloud — est un warn-positif : il garde les données sur le territoire, mais c’est un opérateur et un contrat distincts, et votre base de consentement, votre position de transfert et le traitement de vos journaux de requêtes restent à régler. Ce que le levier n’est pas, c’est un moyen de garder les données à l’étranger et de faire paraître local un point de terminaison lointain ; localiser signifie garder le dépôt de données au repos sur une voie sur le territoire, non l’acheminer hors du continent puis de retour.
Il s’agit d’une image des risques, pas d’un verdict : savoir si une obligation de localisation vous lie, quel mécanisme transfrontalier convient, et quelle part de votre index compte comme des informations personnelles, dépend de votre entité, de vos volumes de données et de qui sont les données — réglez les détails avec un conseil avant de construire.
La voie légale — cartographier, localiser, diffuser
21YunBox est une couche de conformité autour du stack que vous exploitez déjà, non un remplacement d’Elasticsearch ni un concurrent d’Elastic. Le travail a trois parties. Cartographier : inventorier ce que vous indexez et vectorisez, quelles informations personnelles ces documents et plongements transportent, où le cluster s’exécute aujourd’hui, ce que vos journaux de requêtes capturent, et la base de consentement sur laquelle vous reposez. Localiser : garder l’index et les plongements de vos utilisateurs en Chine sur le territoire — auto-héberger le moteur open source (AGPL) sur une infrastructure du continent, ou utiliser un déploiement géré agréé sur le territoire — minimiser et pseudonymiser ce qui est indexé, et gouverner tout transfert transfrontalier résiduel ; le but est de garder le dépôt de données au repos sur une voie sur le territoire. Diffuser : l’application qui interroge l’index porte une obligation de déclaration ICP et a besoin d’une diffusion conforme, sur le territoire — le 21YunBox Optimizer, placé devant le stack que vous exploitez déjà, sans reconstruction ni second code. 21YunBox n’utilise ni ne suggère jamais de contournement d’aucune sorte. Le résultat est un déploiement Elasticsearch qui s’exécute de manière légale et conforme pour vos utilisateurs en Chine.
Obtenir une évaluation de conformité →
À lire également :
- Les transferts transfrontaliers de données au titre de la PIPL
- La loi chinoise sur la cybersécurité expliquée
- Les Mesures d’évaluation de sécurité pour l’exportation de données de Chine
- Comment obtenir une déclaration ICP pour la Chine
Questions fréquentes
Les plongements sont-ils vraiment des informations personnelles s'il ne s'agit que de vecteurs ?
Traitez-les comme des informations personnelles, car c'est ce qu'ils sont. Un plongement est calculé directement à partir du message, document ou image d'un utilisateur, et il a été démontré que les plongements permettent l'inversion — la reconstruction approximative du texte source — et l'inférence d'appartenance. Elasticsearch stocke aussi le document ou la charge utile brute aux côtés du vecteur dans la plupart des conceptions. Un index construit à partir de l'activité de vos utilisateurs chinois détient donc leurs informations personnelles sous forme transformée, non anonymisée ; au titre de l'article 4 de la PIPL, seules les données réellement anonymisées sont hors champ. Détenu dans une région Elastic Cloud à l'étranger, c'est un transfert transfrontalier, et les obligations retombent sur vous en tant que responsable de traitement.
L'auto-hébergement d'Elasticsearch n'est-il pas la réponse propre pour la Chine ?
C'est le levier le plus fort, et il est réel : depuis qu'Elastic a ajouté l'option AGPL en 2024, Elasticsearch est open source et vous pouvez exploiter le même moteur sur votre propre infrastructure à l'intérieur du continent, en gardant l'index et ses plongements sur le territoire. Cela répond à la résidence des données. Cela ne répond pas, à soi seul, à tout — l'application publique qui interroge le cluster a toujours besoin d'une déclaration ICP si elle sert un public du continent, vos obligations de consentement et d'information PIPL sont désormais les vôtres à assurer, et les journaux de requêtes peuvent eux-mêmes transporter des informations personnelles. Un Elasticsearch géré agréé sur le territoire (par exemple Alibaba Cloud Elasticsearch dans les régions continentales d'Alibaba Cloud) est une alternative warn-positive — sur le territoire, mais un opérateur et un contrat distincts.
21YunBox peut-il aider à faire fonctionner notre application adossée à Elasticsearch en Chine ?
Oui. Notre équipe Chine peut inventorier ce que vous indexez et vectorisez et les informations personnelles que cela transporte, cartographier votre position transfrontalière et de résidence des données au titre de la PIPL pour votre entité et vos volumes de données, et mettre en place une voie Elasticsearch auto-hébergée et sur le territoire — plus la diffusion déclarée (ICP) et sur le territoire dont a besoin l'application en façade — autour du stack que vous exploitez déjà, sans reconstruction et sans quitter Elasticsearch. Prenez contact pour traiter votre cas précis.


