¿Funciona ElevenLabs en China? Transferencia transfronteriza según la PIPL, biometría de la huella de voz y residencia de datos
El audio que envía a ElevenLabs para sintetizar, clonar o transcribir lleva la huella de voz de quien habla — información personal biométrica sensible del artículo 28 que no puede anonimizarse —, y enviarlo a los servidores de ElevenLabs en el extranjero (EE. UU. por defecto, sin ninguna región en China continental) es una transferencia transfronteriza según la PIPL. Un análisis centrado en el cumplimiento del uso de la IA de voz de ElevenLabs en China continental.
¿Funciona ElevenLabs en China?
ElevenLabs no tiene región en China continental — el audio que le envía para sintetizar, clonar o transcribir es la grabación de la huella de voz de una persona enviada a sus servidores en el extranjero, información personal biométrica sensible que no puede anonimizarse.
Una grabación de voz lleva tanto la huella de voz de quien habla (un identificador biométrico sensible del artículo 28) como todo lo que se dijo, y ElevenLabs almacena los datos de los clientes en EE. UU. por defecto (la UE, India y Singapur solo para Enterprise) — de modo que cada llamada es una transferencia transfronteriza según la PIPL de información personal biométrica sensible; y como ElevenLabs sintetiza y clona voces, una función orientada a China activa también los deberes de síntesis profunda, de registro de IA generativa y de etiquetado de contenidos. La palanca legal es mantener dentro del país el tratamiento del audio de origen chino — un servicio de voz nacional con licencia, o un despliegue dentro del país validado con asesoría legal — con el consentimiento separado del artículo 28 y una evaluación de impacto previa, no hacer más accesible la API en el extranjero.
Esto es un mapa de riesgo, no un veredicto — concrete los detalles con su asesoría legal. Nuestro equipo de China puede cartografiar su exposición →
Instantánea de cumplimiento
- ✕ ElevenLabs no tiene región en China continental; su audio se trata en el extranjero
- ! Una grabación de voz es una huella de voz — dato biométrico sensible del art. 28 que no puede anonimizarse
- ! El audio de China enviado al extranjero constituye una transferencia transfronteriza según la PIPL (art. 38–40)
- ! Una voz clonada o sintetizada añade la puerta del registro de síntesis profunda e IA generativa ante la CAC
- ! El audio puede entrenar los modelos de ElevenLabs; la retención cero es solo Enterprise y solo para la API
- ✓ Vía legal: audio de China dentro del país + consentimiento del art. 28 + entrega con registro ICP
Lo que la documentación oficial de ElevenLabs dice sobre China
| Hecho | Fuente primaria |
|---|---|
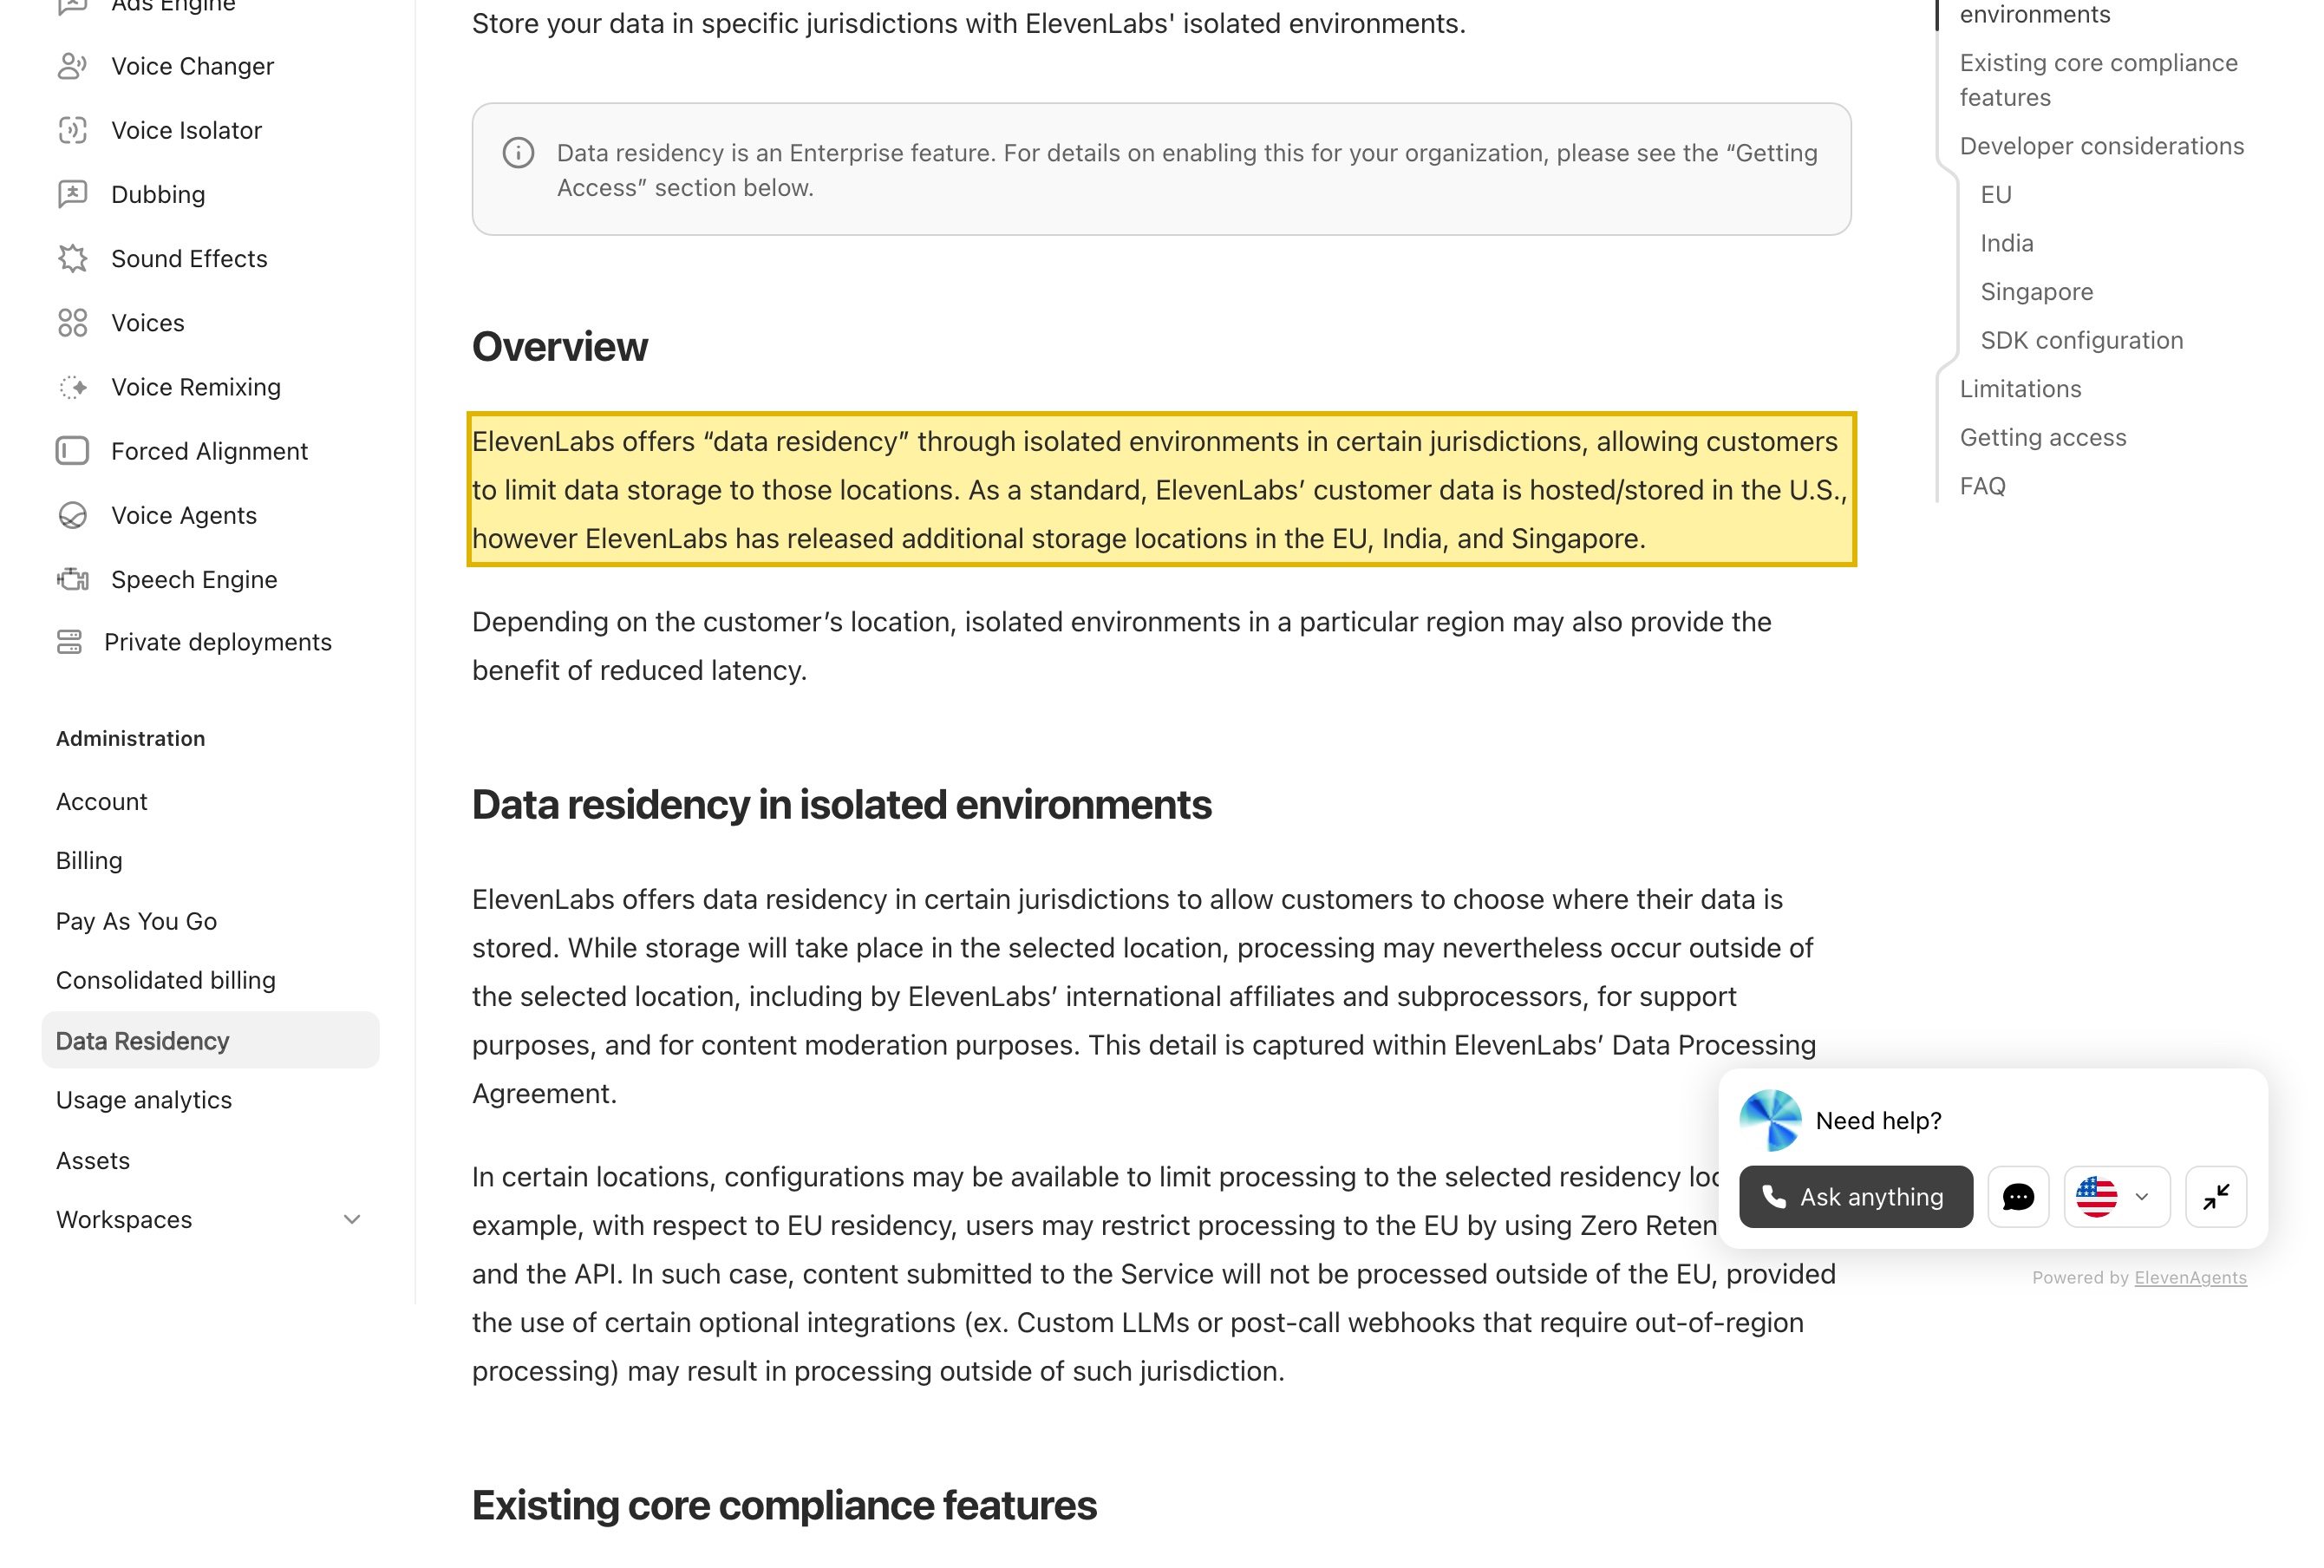
| ElevenLabs almacena los datos de los clientes en EE. UU. por defecto, sin ninguna región en China continental. Su documentación de residencia de datos afirma: “As a standard, ElevenLabs' customer data is hosted/stored in the U.S.,” (de forma estándar, los datos de los clientes de ElevenLabs se alojan y almacenan en EE. UU.), menciona la UE, India y Singapur como opciones de almacenamiento exclusivas de Enterprise y advierte de que, incluso entonces, “processing may nevertheless occur outside of the selected location” (el tratamiento puede producirse, no obstante, fuera de la ubicación seleccionada) a través de sus filiales internacionales y subencargados. Ninguna opción mantiene en el continente el audio de China continental. | ElevenLabs Docs — Data residency (elevenlabs.io), consultado el 2026-10-10 |
| ElevenLabs utiliza por defecto las entradas para entrenar sus modelos y advierte ella misma de que los datos de voz pueden ser biométricos. Su política de privacidad indica: “We use your personal information to research, build, train and improve our AI models,” (utilizamos su información personal para investigar, construir, entrenar y mejorar nuestros modelos de IA), que ello incluye “our models learning patterns in speech and audio,” (que nuestros modelos aprendan patrones del habla y del audio) y que, al verificar una voz, “may be handling biometric or sensitive or special category data under some laws.” (puede estar tratando datos biométricos, sensibles o de categoría especial según algunas legislaciones). El Zero Retention Mode está “available to select enterprise customers” (disponible para determinados clientes Enterprise) y “applies to API use only” (solo se aplica al uso de la API); existe una exclusión voluntaria del entrenamiento, pero solo con efectos hacia el futuro. | ElevenLabs — Privacy Policy y documentación de Zero Retention Mode (elevenlabs.io), consultado el 2026-10-10 |
| Una huella de voz es información personal biométrica sensible según el artículo 28 de la PIPL, y enviarla al extranjero es una transferencia transfronteriza. El artículo 28 trata la información biométrica como una categoría sensible que requiere un propósito específico, una necesidad estricta, un consentimiento separado y una evaluación de impacto previa sobre la protección de datos personales; los artículos 38–40 exigen notificación, un consentimiento separado y un mecanismo de transferencia (una evaluación de seguridad de la CAC, el contrato estándar de la CAC o una certificación) antes de que el audio de un usuario chino salga del país. No se puede anonimizar una grabación cuya razón de ser es la voz. | Ley de Protección de Información Personal de la RPC, artículos 28 y 38–40 (cac.gov.cn), consultado el 2026-10-10 |
| Una voz sintetizada o clonada orientada a China añade una puerta de registro de síntesis profunda y de IA generativa. Las disposiciones chinas sobre síntesis profunda y las Medidas Provisionales para la Administración de los Servicios de IA Generativa imponen un registro ante la CAC (生成式人工智能服务备案) y deberes de etiquetado de contenidos generados por IA a un servicio generativo ofrecido al público en el continente; clonar la voz de una persona real sin consentimiento es también una cuestión del artículo 28 y de derechos sobre la imagen y la voz. Para un operador de infraestructuras de información críticas o un tratante de grandes volúmenes, se aplica el almacenamiento dentro del país conforme al artículo 40 de la PIPL y al artículo 39 de la Ley de Ciberseguridad (antes artículo 37). | Medidas Provisionales para la Administración de los Servicios de IA Generativa, CAC (cac.gov.cn), consultado el 2026-10-10 |
Fuentes verificadas por el Equipo de Cumplimiento de 21YunBox el 10 de octubre de 2026.
Para un equipo de producto, de soporte o de voz que atiende a China continental, la cuestión sobre ElevenLabs nunca fue si su API responde desde el continente — por lo general, sí. La cuestión real es qué ocurre con el audio que usted le envía y con las voces que le pide construir. ElevenLabs es una plataforma de voz generativa: usted envía texto y una voz elegida para sintetizar habla, una muestra de la voz de una persona real para clonarla o — a través de sus endpoints de voz a texto Scribe y de cambio de voz — audio grabado para transcribirlo o transformarlo. Según la propia ElevenLabs, “As a standard, ElevenLabs’ customer data is hosted/stored in the U.S.” (de forma estándar, los datos de los clientes de ElevenLabs se alojan y almacenan en EE. UU.), con almacenamiento en la UE, India y Singapur solo para cuentas Enterprise, y sin ninguna región en China continental. Así, cada llamada envía fuera del país una grabación — una huella de voz biométrica más todo lo que se dijo —: una transferencia transfronteriza según la PIPL (artículos 38–40, 数据出境), el artículo 28 para la huella de voz sensible (un consentimiento separado y una evaluación de impacto previa), un deber de residencia del contenido conforme al artículo 39 de la Ley de Ciberseguridad para un operador de infraestructuras de información críticas o un tratante de grandes volúmenes y — como el servicio sintetiza y clona voces — las obligaciones chinas de registro de síntesis profunda y de IA generativa para cualquier función orientada a China.
ElevenLabs en China de un vistazo
| Qué lo decide | En los propios términos de ElevenLabs — y la ley china |
|---|---|
| Qué envía usted, y que lleva la huella de voz de quien habla | La razón de ser de un servicio de voz es la propia voz. Para sintetizar o clonar, usted envía texto y una voz elegida — o, para un Professional Voice Clone, una muestra de una persona real hablando —; para transcribir o transformar, envía audio grabado a los endpoints de voz a texto Scribe o de cambio de voz. La grabación de una persona es su huella de voz — un identificador biométrico — y lleva todo lo que se dijo: una llamada de soporte, un mensaje de voz, una nota dictada. Vinculado a una persona en China, eso es información personal según la PIPL; la huella de voz, y cualquier contenido de salud, financiero o de identificación presente en el habla, es sensible según el artículo 28. |
| Se envía al extranjero — una transferencia transfronteriza | ElevenLabs afirma: “As a standard, ElevenLabs' customer data is hosted/stored in the U.S.” (de forma estándar, los datos de los clientes se alojan y almacenan en EE. UU.), con “additional storage locations in the EU, India, and Singapore” (ubicaciones de almacenamiento adicionales en la UE, India y Singapur) para las cuentas Enterprise, y advierte de que, incluso entonces, “processing may nevertheless occur outside of the selected location” (el tratamiento puede producirse fuera de la ubicación seleccionada) a través de sus “international affiliates and subprocessors.” (filiales internacionales y subencargados). Ninguna de esas ubicaciones está en China continental. Enviar allí una grabación o una muestra de voz de origen chino es una transferencia transfronteriza regulada por la PIPL: notificación, un consentimiento separado y un mecanismo de transferencia (artículos 38–40, 数据出境). |
| Dato biométrico sensible — artículo 28, y una voz no se puede anonimizar | Una huella de voz es un dato biométrico, que el artículo 28 de la PIPL trata como sensible: requiere un propósito específico, una necesidad estricta, un consentimiento separado y específico, y una evaluación de impacto previa sobre la protección de datos personales (PIPIA) antes de tratarla o transferirla. Puede enmascarar una transcripción, pero no puede anonimizar el audio — la voz es el identificador. La propia ElevenLabs señala que, al verificar una voz, “may be handling biometric or sensitive or special category data under some laws.” (puede estar tratando datos biométricos, sensibles o de categoría especial según algunas legislaciones). |
| Voz generativa, retención y residencia | ElevenLabs sintetiza y clona voces, así que una función ofrecida al público en China activa también las disposiciones chinas sobre síntesis profunda y las medidas sobre IA generativa — un registro ante la CAC (生成式人工智能服务备案) y deberes de etiquetado de contenidos generados por IA —, y clonar la voz de una persona real sin consentimiento es una cuestión del artículo 28 y de derechos sobre la imagen y la voz. En cuanto a la retención, ElevenLabs utiliza por defecto las entradas para “research, build, train and improve our AI models” (investigar, construir, entrenar y mejorar sus modelos de IA); el Zero Retention Mode es exclusivo de Enterprise y “applies to API use only.” (solo se aplica al uso de la API). Para un operador de infraestructuras de información críticas o un tratante de grandes volúmenes, se aplica además el almacenamiento dentro del país (artículo 40 de la PIPL; artículo 39 de la Ley de Ciberseguridad (antes artículo 37)) — la reforma de 2025 de la Ley de Ciberseguridad, en vigor desde el 1 de enero de 2026, renumeró el artículo de localización de datos del 37 al 39, sin cambios de fondo. |
| La accesibilidad no es el eje | Que ElevenLabs sea accesible y devuelva audio desde el continente resuelve la mitad de la entrega, pero no contesta la pregunta — una API en el extranjero que se alcanza sin problemas solo consigue exportar más huellas de voz. La palanca legal es mantener dentro del país el tratamiento del audio de origen chino: encaminarlo a través de un servicio de voz con licencia dentro del país cuyos datos permanezcan en el continente, o ejecutar un despliegue dentro del país validado con asesoría legal, con el consentimiento separado del artículo 28, la retención para entrenamiento desactivada y — para cualquier voz sintetizada o clonada orientada a China — el registro de síntesis profunda y de IA generativa cumplido. La aplicación orientada a China que capta el audio conlleva su propio registro ICP y su propia entrega dentro del país. |
Lo que usted envía en realidad — la huella de voz y las palabras de quienes hablan
ElevenLabs es ante todo una plataforma de voz generativa — conversión de texto a voz y clonación de voz — y además ofrece conversión de voz a texto (su modelo Scribe) y un cambiador de voz. En todos los casos, lo que cruza la frontera es audio de una persona, o una muestra utilizada para construir una copia sintética de su voz. Una grabación no es como un campo de formulario que pueda enmascarar antes de enviarlo: es un identificador biométrico de quien habla y lleva el contenido de lo que se dijo — los datos de la cuenta de un cliente en una llamada de soporte, los síntomas de un paciente en una nota dictada, las observaciones de un directivo en una reunión grabada. Para un Professional Voice Clone, usted sube deliberadamente una muestra de una persona real hablando, y tanto la muestra como el clon resultante son biométricos.
Y no se queda en China — no hay opción en el continente. ElevenLabs afirma: “As a standard, ElevenLabs’ customer data is hosted/stored in the U.S.” (de forma estándar, los datos de los clientes de ElevenLabs se alojan y almacenan en EE. UU.), con la UE, India y Singapur disponibles como ubicaciones de almacenamiento, y “Data residency is an exclusive feature available to ElevenLabs’ Enterprise customers.” (la residencia de datos es una función exclusiva para los clientes Enterprise de ElevenLabs). Y, lo que es decisivo, almacenar no es tratar: ElevenLabs advierte de que “While storage will take place in the selected location, processing may nevertheless occur outside of the selected location” (aunque el almacenamiento tendrá lugar en la ubicación seleccionada, el tratamiento puede producirse, no obstante, fuera de ella), también por parte de sus “international affiliates and subprocessors” (filiales internacionales y subencargados), con fines de soporte y de moderación de contenidos. Para quien habla desde China, cada llamada es su voz saliendo del país en tiempo real.
En cuanto a retención y entrenamiento, la política de privacidad de ElevenLabs indica que utiliza la información personal para “research, build, train and improve our AI models” (investigar, construir, entrenar y mejorar nuestros modelos de IA), y que ello incluye “our models learning patterns in speech and audio” (que nuestros modelos aprendan patrones del habla y del audio), sobre la base del interés legítimo, con consentimiento solo “if required by law” (si la ley lo exige). Existe una exclusión voluntaria del entrenamiento con efectos solo hacia el futuro, y ElevenLabs se compromete a no conservar “data we generate about your voice for longer than 3 years after your last interaction” (los datos que generamos sobre su voz durante más de 3 años después de su última interacción), aunque ese límite está redactado en torno a los datos que la empresa genera y no claramente en torno a las grabaciones y los clones que usted sube. El Zero Retention Mode — que elimina “most data in requests and responses” (la mayoría de los datos de solicitudes y respuestas) una vez completada la solicitud — está “available to select enterprise customers” (disponible para determinados clientes Enterprise) y “applies to API use only” (solo se aplica al uso de la API), no a la aplicación web ni al playground. Son controles reales, pero dependen del nivel de cuenta y se limitan a la API, y ninguno de ellos convierte un servicio en el extranjero en uno con residencia en el continente.
Una transferencia transfronteriza de datos biométricos sensibles, según la PIPL
Enviar una grabación de origen chino, o una muestra utilizada para clonar una voz, a los servidores de ElevenLabs en EE. UU. (o en la UE, India o Singapur) es una transferencia transfronteriza de datos personales conforme a los artículos 38 a 40 de la PIPL (数据出境). Como responsable del tratamiento, usted — no ElevenLabs, que es el encargado — debe notificar, obtener un consentimiento separado para la exportación y establecer un mecanismo de transferencia: una evaluación de seguridad de la CAC, el contrato estándar de la CAC o una certificación. Una grabación es una transferencia de todo lo que se oye en ella, no simplemente de «un archivo».
Como una huella de voz es biométrica, el artículo 28 de la PIPL añade un listón más alto sobre la transferencia: un propósito específico, una necesidad estricta, un consentimiento separado y específico, y una evaluación de impacto previa sobre la protección de datos personales antes de tratar o transferir la voz. El contenido hablado puede sumar otras categorías sensibles — salud, finanzas, documentos de identidad oficiales. Y no se puede extraer el identificador de un audio cuyo propósito es la propia voz, así que el elemento sensible viaja con cada llamada.
Como ElevenLabs sintetiza y clona voces, una función orientada a China construida sobre él choca también con las disposiciones chinas sobre síntesis profunda y con las medidas sobre IA generativa: un registro ante la CAC (生成式人工智能服务备案) y deberes de etiquetado de contenidos generados por IA para un servicio generativo ofrecido al público en el continente — una segunda puerta que se suma a la transferencia. Clonar la voz de una persona real sin su consentimiento es, además, un problema del artículo 28 y de derechos sobre la imagen y la voz conforme al Código Civil.
Cuando su organización es un operador de infraestructuras de información críticas, o sus volúmenes superan los umbrales de los reguladores, se aplica un deber de almacenamiento dentro del país — los datos personales del continente deben almacenarse en el continente (artículo 40 de la PIPL; artículo 39 de la Ley de Ciberseguridad (antes artículo 37)) — y puede exigirse una evaluación de seguridad de la exportación de datos dirigida por la CAC antes de que nada de ello salga legalmente del país. La presencia de ElevenLabs en EE. UU., la UE, India y Singapur y su Zero Retention Mode son funciones reales de protección de datos, pero son controles de elección regional y limitados a la API, no una residencia en China continental, y ninguno de ellos aporta la base que la PIPL exige para la propia exportación.
Llegar a la API no es lo que importa — mantener el audio dentro del país, sí
Ante la mayoría de los problemas en China, el instinto es conseguir que una llamada lenta o fallida a un tercero cargue más rápido. En este eje, ese instinto va al revés: lograr que los endpoints de ElevenLabs en el extranjero respondan de forma más fiable a los usuarios del continente no reduce la exposición — exporta más huellas de voz, con más fluidez, sin aportar la base legal que la transferencia necesita.
Lo que realmente funciona es mantener el tratamiento del audio de origen chino en una vía dentro del país, y aquí conviene ser preciso sobre las opciones de ElevenLabs, porque han cambiado. Tradicionalmente un servicio solo en la nube, ElevenLabs anunció en 2026 un despliegue on-premise y en el dispositivo en acceso anticipado — “Built for governments, public sector, and regulated enterprises” (diseñado para gobiernos, el sector público y empresas reguladas), donde afirma que “No customer data or audio ever leaves your infrastructure” (ningún dato ni audio del cliente sale nunca de su infraestructura) —, junto con un modo VPC que ejecuta los modelos dentro de su propia cuenta de AWS o GCP. Es una palanca genuina dentro del país allí donde ElevenLabs la concede y usted ejecuta el hardware dentro del continente — pero está en acceso anticipado, las nubes del modo VPC no ofrecen una región limpia en China continental y, lo que es decisivo, mantener el audio dentro del país no resuelve por sí solo el registro de síntesis profunda y de IA generativa ni el consentimiento del artículo 28 para una voz sintetizada o clonada orientada a China. Por eso, para la mayoría de los equipos la vía fiable es un servicio de voz con licencia dentro del país cuyos datos permanezcan en el continente, junto con el consentimiento separado del artículo 28 y una PIPIA, la retención para entrenamiento desactivada y los deberes de síntesis profunda y de etiquetado de contenidos cumplidos para cualquier voz generada. Para la conversión de voz a texto en concreto, un modelo de transcripción abierto y autoalojable ejecutado en servidores dentro de China es otra forma de que el audio no salga nunca del país. Nada de esto es una vía que, de todos modos, envíe el audio al extranjero mientras oculta que lo hace.
Esto es un mapa de riesgo, no un veredicto. Si usted debe obtener un consentimiento separado, contar con un mecanismo de transferencia, superar una evaluación de la exportación de datos, almacenar dentro del país o presentar un registro de síntesis profunda o de IA generativa o un registro ICP — y en qué combinación — depende de su entidad, de sus volúmenes de datos, de qué parte de su audio de China es sensible y de qué envía exactamente para sintetizar, clonar o transcribir. Concrete los detalles con asesoría legal antes de enviar al extranjero una sola grabación del continente.
La vía legal — cartografiar, localizar, entregar
Para tratar legalmente la voz de China no necesita abandonar ElevenLabs en sus demás mercados. 21YunBox es una capa de cumplimiento, no una migración — y, para un servicio que ya utiliza, un socio que trabaja junto a su stack, no un competidor del motor de voz. Son tres movimientos que encajan entre sí.
Cartografiar. Nuestro equipo de cumplimiento para China inventaría qué audio fluye hacia ElevenLabs — qué grabaciones, muestras de voz y clones, de quién son las huellas de voz y qué contenido hablado contienen —, dónde lo trata y almacena ElevenLabs, si se conserva o se usa para entrenar modelos, si alguna función orientada a China sintetiza o clona una voz y dónde le falta una base legal (un consentimiento separado del artículo 28 y una PIPIA; un mecanismo de transferencia; un registro de síntesis profunda o de IA generativa), para que la exposición quede por escrito antes de cambiar nada.
Localizar. Como el riesgo es que el audio de origen chino salga del país, localizar significa aquí mantener su tratamiento dentro del país — un servicio de voz con licencia dentro del país cuyos datos permanezcan en el continente, o un despliegue dentro del país validado con asesoría legal —, con el consentimiento separado del artículo 28, la retención para entrenamiento desactivada y, para cualquier voz sintetizada o clonada orientada a China, el registro de síntesis profunda y de IA generativa y los deberes de etiquetado de contenidos cumplidos. Nunca significa una vía que, de todos modos, haga la llamada al extranjero. 21YunBox nunca utiliza ni recomienda ninguna forma de elusión.
Entregar. El sitio o la aplicación orientados a China que captan y reproducen el audio son un servicio público de internet con un deber de registro ICP y necesitan una entrega conforme dentro del país — el 21YunBox Optimizer la proporciona, con registro ICP y dentro del país, por delante del stack que ya utiliza. Sin reconstruir, sin una segunda base de código.
El objetivo es sencillo: que sus funciones de voz funcionen de forma legal y conforme para sus usuarios en China.
Solicitar una evaluación de cumplimiento →
Lectura relacionada:
- Transferencias transfronterizas de datos conforme a la PIPL
- La Ley de Ciberseguridad de China y la localización de datos (artículo 39)
- Las medidas de evaluación de seguridad de la exportación de datos de China
- Las medidas de China sobre IA generativa (síntesis profunda y registro ante la CAC)
- Cómo obtener un registro ICP para China
Preguntas frecuentes
¿Funciona ElevenLabs en China?
Por lo general, su API responde desde el continente, pero la accesibilidad no es la cuestión de cumplimiento. ElevenLabs no tiene región en China continental — su documentación de residencia de datos indica que los datos de los clientes se “hosted/stored in the U.S.” (alojan y almacenan en EE. UU.) por defecto, con la UE, India y Singapur como opciones exclusivas de Enterprise —, de modo que el audio que envía para sintetizar, clonar o transcribir se trata en el extranjero. La grabación de una persona es su huella de voz, que el artículo 28 de la PIPL trata como información personal biométrica sensible que no puede anonimizarse, y enviarla al extranjero es una transferencia transfronteriza conforme a los artículos 38–40 (notificación, un consentimiento separado y un mecanismo de transferencia). Como ElevenLabs sintetiza y clona voces, una función orientada a China activa también los deberes de síntesis profunda, de registro de IA generativa y de etiquetado de contenidos. Nunca utilizamos ni recomendamos ninguna forma de elusión — confirme sus obligaciones exactas con su asesoría legal.
¿Es realmente una grabación de voz un dato biométrico sensible según la PIPL?
Sí. La grabación de la voz de una persona es su huella de voz, un identificador biométrico, y el artículo 28 de la PIPL clasifica la información biométrica como información personal sensible — requiere un propósito específico, una necesidad estricta, un consentimiento separado y específico, y una evaluación de impacto previa sobre la protección de datos personales antes de tratar o transferir la voz. Se puede enmascarar una transcripción, pero no anonimizar el audio: la propia voz es el identificador. ElevenLabs reconoce que, al verificar una voz, “may be handling biometric or sensitive or special category data under some laws.” (puede estar tratando datos biométricos, sensibles o de categoría especial según algunas legislaciones). El contenido hablado puede añadir otras categorías sensibles — salud, finanzas, documentos de identidad oficiales —, que viajan con cada llamada.
¿Cuál es la vía conforme y dentro del país para la IA de voz en China?
Mantenga en el continente el tratamiento del audio de origen chino. Para la mayoría de los equipos, eso significa un servicio de voz con licencia dentro del país cuyos datos permanezcan en China, o — allí donde ElevenLabs conceda su despliegue on-premise o VPC en acceso anticipado y usted ejecute el hardware dentro del continente — un despliegue dentro del país validado con asesoría legal, junto con el consentimiento separado del artículo 28 y una evaluación de impacto previa, la retención para entrenamiento desactivada y, para cualquier voz sintetizada o clonada, los deberes de síntesis profunda, de registro de IA generativa y de etiquetado de contenidos cumplidos. Las aplicaciones de la tienda de Apple para China continental tienen ahora que documentar ese registro: desde noviembre de 2026, App Store Connect pregunta a cada una de ellas si ofrece contenido generado por IA o sintético — con la generación o alteración de voz mediante IA entre los ejemplos de Apple —, y un «Sí» en la declaración de contenido generado por IA de Apple exige el número de registro aprobado por la CAC y el nombre registrado del modelo o algoritmo de voz, además de una autorización de su titular registrado si pertenece a otro. Para la conversión de voz a texto, un modelo de transcripción abierto y autoalojable ejecutado dentro de China evita que el audio salga nunca del país. Después, entregue la aplicación orientada a China que capta el audio sobre infraestructura con registro ICP dentro del país. 21YunBox cartografía la exposición, localiza sobre la opción dentro del país y proporciona la entrega — sin reconstruir. Es un despliegue legal dentro del país, no una forma de esquivar las condiciones de nadie.


