Funktioniert ElevenLabs in China? PIPL-Grenztransfer, Voiceprint-Biometrie & Datenlokalisierung
Die Audiodaten, die Sie ElevenLabs zum Synthetisieren, Klonen oder Transkribieren senden, tragen den Voiceprint des Sprechers in sich — biometrische sensible personenbezogene Informationen nach Artikel 28, die Sie nicht anonymisieren können — und ihre Übermittlung an die Offshore-Server von ElevenLabs (standardmäßig die USA, keine Region in Festlandchina) ist ein PIPL-Grenztransfer. Ein Compliance-orientierter Blick auf den Einsatz der Sprach-KI von ElevenLabs in Festlandchina.
Funktioniert ElevenLabs in China?
ElevenLabs hat keine Region in Festlandchina — die Audiodaten, die Sie ihm zum Synthetisieren, Klonen oder Transkribieren senden, sind die Aufnahme des Voiceprints einer Person, verschickt an seine Offshore-Server, und das sind sensible biometrische personenbezogene Informationen, die Sie nicht anonymisieren können.
Eine Sprachaufnahme trägt sowohl den Voiceprint des Sprechers (ein sensibles biometrisches Identifikationsmerkmal nach Artikel 28) als auch das Gesagte, und ElevenLabs speichert Kundendaten standardmäßig in den USA (die EU, Indien und Singapur nur für Enterprise) — jeder Aufruf ist also ein PIPL-Grenztransfer sensibler biometrischer personenbezogener Informationen, und weil ElevenLabs Stimmen synthetisiert und klont, löst eine auf China ausgerichtete Funktion auch die Deep-Synthesis- und generative-KI-Melde- und Kennzeichnungspflichten aus. Der rechtmäßige Hebel ist, die Verarbeitung von Audiodaten chinesischen Ursprungs im Inland zu halten — ein lizenzierter inländischer Sprachdienst oder eine mit Rechtsberatung geprüfte Inland-Bereitstellung — mit der gesonderten Artikel-28-Einwilligung und einer vorherigen Folgenabschätzung, nicht, die Offshore-API erreichbarer zu machen.
Dies ist eine Risikokarte, kein Urteil — klären Sie die Einzelheiten mit Rechtsberatung. Unser China-Team kann Ihre Risikolage kartieren →
Compliance-Momentaufnahme
- ✕ ElevenLabs hat keine Region in Festlandchina; Ihre Audiodaten werden im Ausland verarbeitet.
- ! Eine Sprachaufnahme ist ein Voiceprint — sensible Biometrie nach Art. 28, nicht anonymisierbar.
- ! China-Audio ins Ausland gesendet ist ein PIPL-Grenztransfer (Artikel 38–40).
- ! Geklonte/synthetisierte Stimme fügt eine CAC-Deep-Synthesis- + generative-KI-Meldetür hinzu.
- ! Audio kann ElevenLabs' Modelle trainieren; Zero-Retention ist Enterprise- + nur-API.
- ✓ Rechtmäßiger Pfad: China-Audio im Inland + Art.-28-Einwilligung + ICP-registrierte Zustellung.
Was die offizielle ElevenLabs-Dokumentation über China sagt
| Fakt | Primärquelle |
|---|---|
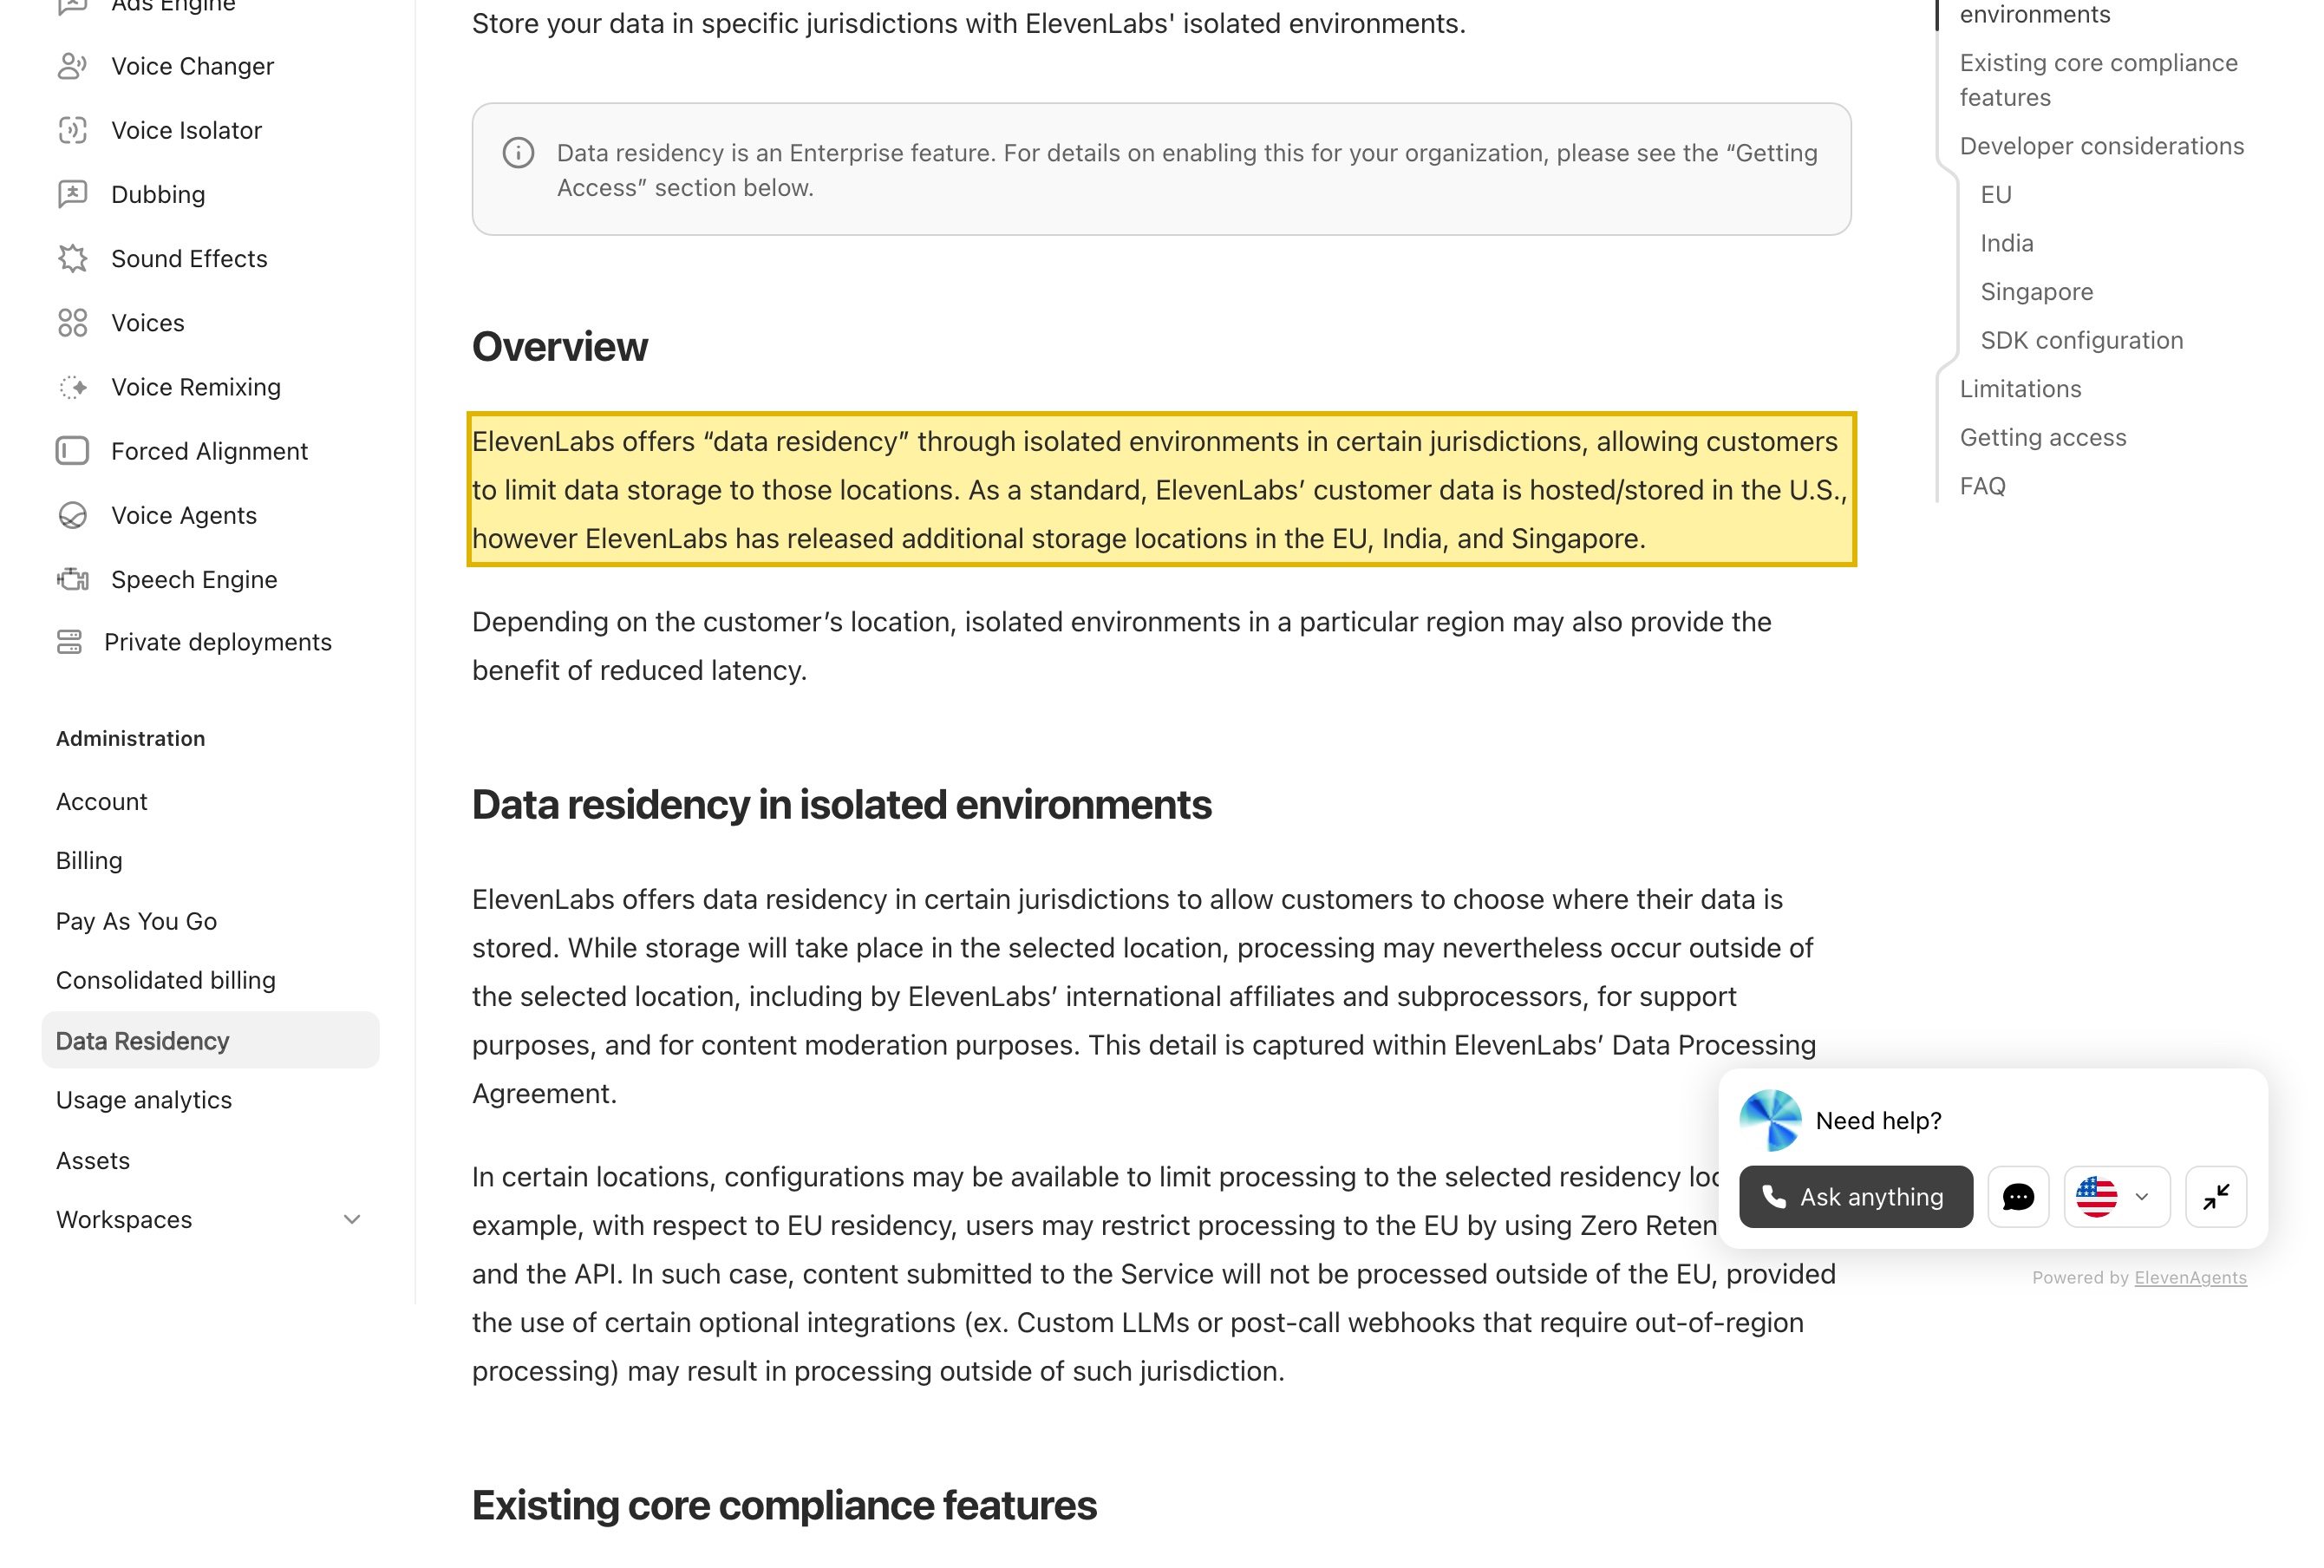
| ElevenLabs speichert Kundendaten standardmäßig in den USA, ohne Region in Festlandchina. Seine Dokumentation zur Datenlokalisierung erklärt: „As a standard, ElevenLabs' customer data is hosted/stored in the U.S.“, nennt die EU, Indien und Singapur als Enterprise-exklusive Speicheroptionen und warnt, dass selbst dann „processing may nevertheless occur outside of the selected location“ über seine internationalen verbundenen Unternehmen und Unterauftragsverarbeiter erfolgen kann. Keine Option hält Festland-China-Audio im Festland. | ElevenLabs Docs — Data residency (elevenlabs.io), abgerufen 2026-10-10 |
| ElevenLabs nutzt Eingaben standardmäßig zum Trainieren seiner Modelle und markiert Sprachdaten selbst als möglicherweise biometrisch. Seine Datenschutzrichtlinie sagt: „We use your personal information to research, build, train and improve our AI models“, dass dies „our models learning patterns in speech and audio“ einschließt, und dass es bei der Verifizierung einer Stimme „may be handling biometric or sensitive or special category data under some laws“. Der Zero Retention Mode ist „available to select enterprise customers“ und „applies to API use only“; ein Trainings-Opt-out existiert, ist aber prospektiv. | ElevenLabs Privacy Policy & Zero Retention Mode docs (elevenlabs.io), abgerufen 2026-10-10 |
| Ein Voiceprint ist eine sensible biometrische personenbezogene Information nach PIPL Artikel 28, und ihn ins Ausland zu senden ist ein Grenztransfer. Artikel 28 behandelt biometrische Informationen als sensible Kategorie, die einen bestimmten Zweck, strikte Erforderlichkeit, eine gesonderte Einwilligung und eine vorherige Folgenabschätzung zum Schutz personenbezogener Informationen verlangt; Artikel 38–40 verlangen Hinweis, eine gesonderte Einwilligung und einen Transfermechanismus (eine CAC-Sicherheitsbewertung, den CAC-Standardvertrag oder eine Zertifizierung), bevor das Audio eines chinesischen Nutzers das Land verlässt. Sie können eine Aufnahme, deren Sinn die Stimme ist, nicht anonymisieren. | Gesetz zum Schutz personenbezogener Informationen der VR China, Artikel 28 und 38–40 (cac.gov.cn), abgerufen 2026-10-10 |
| Eine auf China ausgerichtete synthetisierte oder geklonte Stimme fügt eine Deep-Synthesis- und generative-KI-Meldetür hinzu. Chinas Deep-Synthesis-Bestimmungen und die Interimsmaßnahmen für generative KI-Dienste erlegen einem der Öffentlichkeit im Festland angebotenen generativen Dienst eine CAC-Registrierung (生成式人工智能服务备案) und Pflichten zur Kennzeichnung von KI-Inhalten auf; die Stimme einer echten Person ohne Einwilligung zu klonen, ist auch ein Artikel-28- sowie ein Bildnis- und Stimmrechtsthema. Für einen Betreiber kritischer Informationsinfrastruktur oder Verarbeiter großer Mengen greift die Inland-Speicherung nach PIPL Artikel 40 und Cybersicherheitsgesetz Artikel 39 (vormals Artikel 37). | Interimsmaßnahmen für die Verwaltung generativer KI-Dienste, CAC (cac.gov.cn), abgerufen 2026-10-10 |
Quellen vom 21YunBox Compliance-Team am 10. Oktober 2026 geprüft.
Für ein Produkt-, Support- oder Sprachteam, das Festlandchina bedient, war die Frage zu ElevenLabs nie, ob seine API vom Festland aus erreichbar ist — das ist sie in aller Regel. Die eigentliche Frage ist, was mit den Audiodaten geschieht, die Sie ihm senden, und mit den Stimmen, die Sie es aufbauen lassen. ElevenLabs ist eine generative Sprachplattform: Sie senden Text und eine ausgewählte Stimme, um Sprache zu synthetisieren, eine Probe der Stimme einer echten Person, um sie zu klonen, oder — über die Scribe-Speech-to-Text- und Voice-Changer-Endpunkte — aufgezeichnete Audiodaten, um sie zu transkribieren oder umzuwandeln. Nach ElevenLabs’ eigener Darstellung gilt: „As a standard, ElevenLabs’ customer data is hosted/stored in the U.S.“, mit Speicherung in der EU, in Indien und in Singapur nur für Enterprise-Konten und ohne Region in Festlandchina. Jeder Aufruf versendet also eine Aufnahme — einen biometrischen Voiceprint plus das Gesagte — aus dem Land hinaus: ein PIPL-Grenztransfer (Artikel 38–40, 数据出境), Artikel 28 für den sensiblen Voiceprint (eine gesonderte Einwilligung und eine vorherige Folgenabschätzung), eine Pflicht zur Inhaltslokalisierung nach Artikel 39 des Cybersicherheitsgesetzes für einen Betreiber kritischer Informationsinfrastruktur oder Verarbeiter großer Mengen und — weil der Dienst Stimmen synthetisiert und klont — Chinas Meldepflichten für Deep Synthesis und generative KI für jede auf China ausgerichtete Funktion.
ElevenLabs in China auf einen Blick
| Was entscheidet | In ElevenLabs' eigenen Worten — und nach chinesischem Recht |
|---|---|
| Was Sie senden — und dass es den Voiceprint des Sprechers enthält | Der Sinn eines Sprachdienstes ist die Stimme selbst. Zum Synthetisieren oder Klonen senden Sie Text und eine ausgewählte Stimme — oder, für einen Professional Voice Clone, eine Probe einer echten sprechenden Person; zum Transkribieren oder Umwandeln senden Sie aufgezeichnete Audiodaten an die Scribe-Speech-to-Text- oder Voice-Changer-Endpunkte. Eine Aufnahme einer Person ist ihr Voiceprint — ein biometrisches Identifikationsmerkmal — und sie trägt alles Gesagte in sich: einen Supportanruf, eine Sprachnachricht, eine diktierte Notiz. Mit einer Person in China verknüpft, sind das personenbezogene Informationen nach PIPL; der Voiceprint sowie alle gesundheits-, finanz- oder ausweisbezogenen Inhalte in der Sprache sind nach Artikel 28 sensibel. |
| Es wird ins Ausland gesendet — ein Grenztransfer | ElevenLabs erklärt: „As a standard, ElevenLabs' customer data is hosted/stored in the U.S.“, mit „additional storage locations in the EU, India, and Singapore“ für Enterprise-Konten, und warnt, dass selbst dann „processing may nevertheless occur outside of the selected location“ über seine „international affiliates and subprocessors“ erfolgen kann. Keine davon liegt in Festlandchina. Eine Aufnahme oder Stimmprobe chinesischen Ursprungs dorthin zu senden, ist ein Grenztransfer, den PIPL regelt: Hinweis, eine gesonderte Einwilligung und ein Transfermechanismus (Artikel 38–40, 数据出境). |
| Sensible Biometrie — Artikel 28, und eine Stimme lässt sich nicht anonymisieren | Ein Voiceprint ist biometrische Information, die PIPL Artikel 28 als sensibel behandelt: Sie verlangt einen bestimmten Zweck, strikte Erforderlichkeit, eine gesonderte ausdrückliche Einwilligung und eine vorherige Folgenabschätzung zum Schutz personenbezogener Informationen (PIPIA), bevor die Stimme verarbeitet oder übermittelt wird. Ein Transkript können Sie schwärzen, aber die Audiodaten können Sie nicht anonymisieren — die Stimme ist das Identifikationsmerkmal. ElevenLabs selbst merkt an, dass es bei der Verifizierung einer Stimme „may be handling biometric or sensitive or special category data under some laws“. |
| Generative Stimme, Speicherung und Residency | ElevenLabs synthetisiert und klont Stimmen, sodass eine in China öffentlich angebotene Funktion auch Chinas Deep-Synthesis-Bestimmungen und die Maßnahmen zu generativer KI auslöst — eine CAC-Registrierung (生成式人工智能服务备案) und Pflichten zur Kennzeichnung von KI-Inhalten — und das Klonen der Stimme einer echten Person ohne Einwilligung ist ein Artikel-28- sowie ein Bildnis- und Stimmrechtsthema. Zur Speicherung nutzt ElevenLabs Eingaben standardmäßig, um „research, build, train and improve our AI models“; der Zero Retention Mode ist Enterprise-exklusiv und „applies to API use only“. Für einen Betreiber kritischer Informationsinfrastruktur oder Verarbeiter großer Mengen greift zudem die Inland-Speicherung (PIPL Artikel 40; Cybersicherheitsgesetz Artikel 39 (vormals Artikel 37)) — die Novelle des Cybersicherheitsgesetzes von 2025, in Kraft seit dem 1. Januar 2026, hat den Artikel zur Datenlokalisierung von 37 zu 39 umnummeriert, inhaltlich unverändert. |
| Erreichbarkeit ist nicht die Achse | Dass ElevenLabs vom Festland aus Audiodaten auflöst und zurückliefert, ist die Zustellungs-Hälfte, nicht die Antwort — eine erreichbare Offshore-API exportiert schlicht mehr Voiceprints. Der rechtmäßige Hebel ist, die Verarbeitung von Audiodaten chinesischen Ursprungs im Inland zu halten: Leiten Sie sie über einen lizenzierten inländischen Sprachdienst, dessen Daten im Festland bleiben, oder betreiben Sie eine mit Rechtsberatung geprüfte Inland-Bereitstellung — mit der gesonderten Artikel-28-Einwilligung, deaktivierter Trainingsspeicherung und, für jede auf China ausgerichtete synthetisierte oder geklonte Stimme, erfüllter Deep-Synthesis- und generativer-KI-Meldung. Die auf China ausgerichtete App, die die Audiodaten erfasst, trägt ihre eigene ICP-Registrierung und inländische Zustellung. |
Was Sie tatsächlich senden — die Voiceprints und Worte Ihrer Sprecher
ElevenLabs ist zuerst eine generative Sprachplattform — Text-to-Speech und Voice Cloning — und betreibt außerdem Speech-to-Text (sein Scribe-Modell) sowie einen Voice Changer. Über alle hinweg ist das, was die Grenze überschreitet, Audio einer Person oder eine Probe, die zum Aufbau einer synthetischen Kopie ihrer Stimme verwendet wird. Eine Aufnahme ist nicht wie ein Formularfeld, das Sie vor dem Senden maskieren können: Sie ist ein biometrisches Identifikationsmerkmal des Sprechers und trägt den Inhalt des Gesagten in sich — die Kontodaten eines Kunden in einem Supportanruf, die Symptome eines Patienten in einer diktierten Notiz, die Bemerkungen einer Führungskraft in einem aufgezeichneten Meeting. Für einen Professional Voice Clone laden Sie bewusst eine Probe einer echten sprechenden Person hoch, und sowohl die Probe als auch der resultierende Klon sind biometrisch.
Und sie bleibt nicht in China — es gibt keine Festland-Option. ElevenLabs erklärt: „As a standard, ElevenLabs’ customer data is hosted/stored in the U.S.“, mit der EU, Indien und Singapur als verfügbare Speicherorte, und „Data residency is an exclusive feature available to ElevenLabs’ Enterprise customers.“ Entscheidend: Speicherung ist nicht Verarbeitung. ElevenLabs warnt, dass „While storage will take place in the selected location, processing may nevertheless occur outside of the selected location“, einschließlich durch seine „international affiliates and subprocessors“, zu Support- und Content-Moderations-Zwecken. Für einen Sprecher in China ist jeder Aufruf seine Stimme, die das Land in Echtzeit verlässt.
Zu Speicherung und Training sagt ElevenLabs’ Datenschutzrichtlinie, dass personenbezogene Informationen genutzt werden, um „research, build, train and improve our AI models“, und dass dies „our models learning patterns in speech and audio“ einschließt, auf Grundlage berechtigter Interessen, mit Einwilligung nur „if required by law“. Ein prospektives Trainings-Opt-out existiert, und ElevenLabs verpflichtet sich, „data we generate about your voice“ nicht länger als „3 years after your last interaction“ aufzubewahren — auch wenn diese Grenze um die von ihm generierten Daten herum formuliert ist und nicht klar um die Aufnahmen und Klone, die Sie hochladen. Der Zero Retention Mode — der „most data in requests and responses“ nach Abschluss einer Anfrage löscht — ist „available to select enterprise customers“ und „applies to API use only“, nicht für die Web-App oder den Playground. Das sind echte Kontrollen, aber sie sind kontostufen- und API-gebunden, und keine von ihnen macht aus einem Offshore-Dienst einen im Festland ansässigen.
Es ist ein Grenztransfer sensibler biometrischer Daten — nach PIPL
Eine Aufnahme chinesischen Ursprungs oder eine zum Klonen einer Stimme verwendete Probe an ElevenLabs’ Server in den USA (oder der EU, in Indien oder Singapur) zu senden, ist ein Grenztransfer personenbezogener Informationen nach PIPL Artikel 38–40 (数据出境). Als Verarbeiter im Sinne des Handelnden müssen Sie — nicht ElevenLabs, der Auftragsverarbeiter — einen Hinweis geben, eine gesonderte Einwilligung für den Export einholen und einen Transfermechanismus einrichten: eine CAC-Sicherheitsbewertung, den CAC-Standardvertrag oder eine Zertifizierung. Eine Aufnahme ist eine Übermittlung all dessen, was darin hörbar ist, nicht bloß „einer Datei“.
Weil ein Voiceprint biometrisch ist, fügt PIPL Artikel 28 der Übermittlung eine höhere Hürde hinzu: einen bestimmten Zweck, strikte Erforderlichkeit, eine gesonderte ausdrückliche Einwilligung und eine vorherige Folgenabschätzung zum Schutz personenbezogener Informationen, bevor die Stimme verarbeitet oder übermittelt wird. Gesprochene Inhalte können weitere sensible Kategorien hinzufügen — Gesundheit, Finanzen, amtliche Ausweise. Und Sie können das Identifikationsmerkmal nicht aus Audiodaten herauslösen, deren Zweck die Stimme ist, sodass das sensible Element mit jedem Aufruf mitreist.
Weil ElevenLabs Stimmen synthetisiert und klont, stößt eine auf China ausgerichtete Funktion, die darauf aufbaut, auch auf Chinas Deep-Synthesis-Bestimmungen und die Maßnahmen zu generativer KI: eine CAC-Registrierung (生成式人工智能服务备案) und Pflichten zur Kennzeichnung von KI-Inhalten für einen generativen Dienst, der der Öffentlichkeit im Festland angeboten wird — eine zweite Tür, die auf der Übermittlung aufsitzt. Die Stimme einer echten Person ohne deren Einwilligung zu klonen, ist gesondert ein Artikel-28-Problem und ein Bildnis- und Stimmrechtsproblem nach dem Zivilgesetzbuch.
Wo Ihre Organisation ein Betreiber kritischer Informationsinfrastruktur ist oder Ihre Mengen die Schwellen der Regulierer überschreiten, greift eine Inland-Speicherpflicht — personenbezogene Informationen aus dem Festland müssen im Festland gespeichert werden (PIPL Artikel 40; Cybersicherheitsgesetz Artikel 39 (vormals Artikel 37)) — und eine CAC-geführte Sicherheitsbewertung für den Datenexport kann erforderlich sein, bevor etwas davon rechtmäßig das Land verlässt. ElevenLabs’ Präsenz in den USA, der EU, Indien und Singapur sowie sein Zero Retention Mode sind echte Datenschutzfunktionen, aber sie sind Regionswahl- und API-gebundene Kontrollen, keine Residency in Festlandchina, und keine von ihnen liefert die PIPL-Grundlage, die der Export selbst erfordert.
Die API zu erreichen ist nicht die Frage — die Audiodaten im Inland zu halten ist es
Der Instinkt bei den meisten China-Problemen ist, einen langsamen oder scheiternden Drittanbieter-Aufruf schneller laden zu lassen. Auf dieser Achse ist dieser Instinkt verkehrt herum: ElevenLabs’ Offshore-Endpunkte für Festland-Nutzer zuverlässiger antworten zu lassen, verkleinert die Risikolage nicht — es exportiert mehr Voiceprints, reibungsloser, ohne die rechtmäßige Grundlage zu liefern, die die Übermittlung braucht.
Was tatsächlich wirkt, ist, die Verarbeitung von Audiodaten chinesischen Ursprungs auf einem Inland-Pfad zu halten, und es lohnt sich, bei ElevenLabs’ Optionen hier präzise zu sein, denn sie haben sich verändert. Historisch ein reiner Cloud-Dienst, kündigte ElevenLabs 2026 eine On-Premise- und On-Device-Bereitstellung im Early Access an — „Built for governments, public sector, and regulated enterprises“, zu der es heißt „No customer data or audio ever leaves your infrastructure“ — neben einem VPC-Modus, der die Modelle in Ihrem eigenen AWS- oder GCP-Konto laufen lässt. Das ist ein echter Inland-Hebel, wo ElevenLabs ihn gewährt und Sie die Hardware innerhalb des Festlands betreiben — aber es ist Early Access, die VPC-Clouds bieten keine saubere Region in Festlandchina, und, entscheidend, die Audiodaten im Inland zu halten erledigt für sich allein weder die Deep-Synthesis- und generative-KI-Meldung noch die Artikel-28-Einwilligung für eine auf China ausgerichtete synthetisierte oder geklonte Stimme. Für die meisten Teams ist der verlässliche Weg daher ein lizenzierter inländischer Sprachdienst, dessen Daten im Festland bleiben, gepaart mit der gesonderten Artikel-28-Einwilligung und einer PIPIA, deaktivierter Trainingsspeicherung und erfüllten Deep-Synthesis- und Kennzeichnungspflichten für jede erzeugte Stimme. Speziell für Speech-to-Text ist ein offenes, selbst hostbares Transkriptionsmodell, das auf Servern innerhalb Chinas läuft, ein weiterer Weg, die Audiodaten gar nicht erst ausreisen zu lassen. Nichts davon ist eine verdeckte Route, die die Audiodaten trotzdem ins Ausland verschickt und das kaschiert.
Dies ist eine Risikokarte, kein Urteil. Ob Sie eine gesonderte Einwilligung, einen Transfermechanismus, eine Sicherheitsbewertung für den Datenexport, eine Inland-Speicherung, eine Deep-Synthesis- oder generative-KI-Meldung oder eine ICP-Registrierung schulden — und in welcher Kombination —, hängt von Ihrer Rechtsperson, Ihren Datenmengen, davon, wie viel Ihres China-Audios sensibel ist, und davon ab, was genau Sie zum Synthetisieren, Klonen oder Transkribieren senden. Klären Sie die Einzelheiten mit Rechtsberatung, bevor Sie eine einzige Festland-Aufnahme ins Ausland senden.
Der rechtmäßige Pfad — kartieren, lokalisieren, ausliefern
Sie müssen ElevenLabs für Ihre übrigen Märkte nicht aufgeben, um China-Sprache rechtmäßig zu handhaben. 21YunBox ist ein Compliance-Overlay, keine Migration — und, für einen Dienst, den Sie bereits nutzen, ein Partner neben Ihrem Stack statt ein Wettbewerber zur Sprach-Engine. Es gibt drei Schritte, und sie greifen ineinander.
Kartieren. Unser China-Compliance-Team inventarisiert, welche Audiodaten zu ElevenLabs fließen — welche Aufnahmen, Stimmproben und Klone, wessen Voiceprints und die gesprochenen Inhalte darin —, wo ElevenLabs sie verarbeitet und speichert, ob sie aufbewahrt oder zum Modelltraining genutzt werden, ob eine auf China ausgerichtete Funktion eine Stimme synthetisiert oder klont und wo Ihnen eine rechtmäßige Grundlage fehlt (eine gesonderte Artikel-28-Einwilligung und PIPIA; ein Transfermechanismus; eine Deep-Synthesis- oder generative-KI-Meldung), sodass die Risikolage festgehalten ist, bevor sich etwas ändert.
Lokalisieren. Weil das Risiko darin besteht, dass Audiodaten chinesischen Ursprungs das Land verlassen, bedeutet Lokalisieren hier, die Verarbeitung dieser Audiodaten im Inland zu halten — ein lizenzierter inländischer Sprachdienst, dessen Daten im Festland bleiben, oder eine mit Rechtsberatung geprüfte Inland-Bereitstellung — mit der gesonderten Artikel-28-Einwilligung, deaktivierter Trainingsspeicherung und, für jede auf China ausgerichtete synthetisierte oder geklonte Stimme, erfüllten Deep-Synthesis- und generativer-KI- sowie Kennzeichnungspflichten. Es bedeutet nie eine verdeckte Route, die den Offshore-Aufruf trotzdem ausführt. 21YunBox nutzt oder empfiehlt niemals irgendeine Form der Umgehung.
Ausliefern. Die auf China ausgerichtete Website oder App, die die Audiodaten erfasst und abspielt, ist ein öffentlicher Internetdienst mit einer ICP-Registrierungspflicht und benötigt eine compliant, inländische Zustellung — der 21YunBox Optimizer liefert sie, ICP-registriert und im Inland, vor dem Stack, den Sie bereits betreiben. Kein Rebuild, keine zweite Codebasis.
Das Ziel ist klar: Ihre Sprachfunktionen laufen für Ihre Nutzer in China legal und compliant.
Compliance-Einschätzung anfordern →
Weiterführende Lektüre:
- Grenzüberschreitende Datenübermittlungen nach PIPL
- Chinas Cybersicherheitsgesetz und Datenlokalisierung (Artikel 39)
- Chinas Maßnahmen zur Sicherheitsbewertung des Datenexports
- Chinas Maßnahmen zu generativer KI (Deep Synthesis & CAC-Registrierung)
- So erhalten Sie eine ICP-Registrierung für China
Häufige Fragen
Funktioniert ElevenLabs in China?
Seine API löst im Allgemeinen aus dem Festland auf, aber Erreichbarkeit ist nicht die Compliance-Frage. ElevenLabs hat keine Region in Festlandchina — seine Datenlokalisierungs-Dokumentation sagt, Kundendaten würden standardmäßig „hosted/stored in the U.S.“, mit der EU, Indien und Singapur als Enterprise-exklusiven Optionen — sodass die Audiodaten, die Sie zum Synthetisieren, Klonen oder Transkribieren senden, im Ausland verarbeitet werden. Eine Aufnahme einer Person ist ihr Voiceprint, den PIPL Artikel 28 als sensible biometrische personenbezogene Information behandelt, die Sie nicht anonymisieren können, und sie ins Ausland zu verschicken ist ein Grenztransfer nach Artikel 38–40 (Hinweis, eine gesonderte Einwilligung und ein Transfermechanismus). Weil ElevenLabs Stimmen synthetisiert und klont, löst eine auf China ausgerichtete Funktion auch die Deep-Synthesis- und generative-KI-Melde- und Kennzeichnungspflichten aus. Wir nutzen oder empfehlen niemals irgendeine Form der Umgehung — bestätigen Sie Ihre genauen Pflichten mit Rechtsberatung.
Ist eine Sprachaufnahme wirklich sensible biometrische Information nach PIPL?
Ja. Eine Aufnahme der Stimme einer Person ist ihr Voiceprint, ein biometrisches Identifikationsmerkmal, und PIPL Artikel 28 stuft biometrische Informationen als sensible personenbezogene Informationen ein — er verlangt einen bestimmten Zweck, strikte Erforderlichkeit, eine gesonderte ausdrückliche Einwilligung und eine vorherige Folgenabschätzung zum Schutz personenbezogener Informationen, bevor die Stimme verarbeitet oder übermittelt wird. Ein Transkript können Sie schwärzen, aber die Audiodaten können Sie nicht anonymisieren: Die Stimme selbst ist das Identifikationsmerkmal. ElevenLabs räumt ein, dass es bei der Verifizierung einer Stimme „may be handling biometric or sensitive or special category data under some laws“. Gesprochene Inhalte können weitere sensible Kategorien hinzufügen — Gesundheit, Finanzen, amtliche Ausweise — die mit jedem Aufruf mitreisen.
Was ist der compliant, inländische Pfad für Sprach-KI in China?
Halten Sie die Verarbeitung von Audiodaten chinesischen Ursprungs im Festland. Für die meisten Teams bedeutet das einen lizenzierten inländischen Sprachdienst, dessen Daten in China bleiben, oder — wo ElevenLabs seine On-Premise- oder VPC-Bereitstellung im Early Access gewährt und Sie die Hardware innerhalb des Festlands betreiben — eine mit Rechtsberatung geprüfte Inland-Bereitstellung, gepaart mit der gesonderten Artikel-28-Einwilligung und einer vorherigen Folgenabschätzung, deaktivierter Trainingsspeicherung und, für jede synthetisierte oder geklonte Stimme, erfüllten Deep-Synthesis- und generativer-KI-Melde- und Kennzeichnungspflichten. Für Speech-to-Text hält ein offenes, selbst hostbares Transkriptionsmodell, das innerhalb Chinas läuft, die Audiodaten davon ab, jemals auszureisen. Liefern Sie dann die auf China ausgerichtete App, die die Audiodaten erfasst, auf ICP-registrierter, inländischer Infrastruktur aus. 21YunBox kartiert die Risikolage, lokalisiert auf die Inland-Option und stellt die Zustellung bereit — ohne Rebuild. Es ist eine rechtmäßige Inland-Bereitstellung, kein Weg um die Bedingungen irgendeines Anbieters herum.


