Funktioniert Google Cloud Speech-to-Text in China? PIPL-Grenztransfer, Stimmabdruck-Biometrie und Datenresidenz
Das Audio, das Sie Google Cloud Speech-to-Text zum Transkribieren senden, trägt den Stimmabdruck des Sprechers — nach Art. 28 sensible biometrische personenbezogene Daten, die Sie nicht anonymisieren können — und Google betreibt keine Festland-China-Region, sodass dieses Audio offshore verarbeitet wird: ein PIPL-Grenztransfer. Ein Blick zuerst auf die Compliance: der Stimmabdruck, die Datenresidenz, die Aufbewahrung und der rechtmäßige Inland-Sprachweg.
Funktioniert Google Cloud Speech-to-Text in China?
Die Aufnahme, die Sie Google Cloud Speech-to-Text zum Transkribieren senden, ist der Stimmabdruck des Sprechers — nach Art. 28 sensible biometrische personenbezogene Daten —, und weil Google keine Festland-China-Region betreibt, verarbeitet jede Anfrage dieses Audio offshore.
Speech-to-Text verwandelt Audio in Text, aber das Audio selbst trägt einen biometrischen Identifikator plus das Gesagte — Anrufaufzeichnungen, Sprachnachrichten, diktierte Notizen —, sodass das Senden von China-stämmigem Audio an Googles Offshore-Server ein PIPL-Grenztransfer sensibler personenbezogener Information (Art. 28) ist, den das Schwärzen des Transkripts nicht zurücknehmen kann. Standardmäßig protokolliert Google Ihr Audio nicht und trainiert nicht darauf, aber ein Opt-in-Data-Logging-Programm tut es — eine Einstellung, die Sie für China-Audio deaktivieren. Der rechtmäßige Hebel ist, die Verarbeitung von China-Audio im Inland zu halten — ein selbst gehosteter/On-Prem-Sprachcontainer oder ein lizenzierter inländischer Sprachdienst — mit der gesonderten Einwilligung nach Art. 28 und einer PIPIA, nicht den Offshore-Endpunkt erreichbar zu machen.
Eine Risikokarte, kein Urteil — klären Sie die Einzelheiten mit Rechtsbeistand. Unser China-Team kann Ihre Exponierung kartieren →
Compliance-Momentaufnahme
- ✕ Google Cloud hat keine Festland-China-Region; Ihr Audio wird auf Offshore-Servern transkribiert
- ! Das Audio ist der Stimmabdruck des Sprechers — PIPL Art. 28 sensibel-biometrisch, nicht anonymisierbar
- ! Dieses Audio offshore zu verschiffen, ist ein PIPL-Grenztransfer (Art. 38–40, 数据出境)
- ! Standardmäßig trainiert Google nicht auf Ihrem Audio, aber ein Opt-in-Logging-Programm tut es
- ! CSL Art. 39 (vormals 37) fügt Inland-Speicherung für einen Betreiber kritischer Informationsinfrastruktur oder Verarbeiter großer Mengen hinzu
- ✓ Rechtmäßiger Weg: Inland-Sprache (self-hosted oder lizenziert inländisch) + Einwilligung nach Art. 28 + ICP
Was die offizielle Google Cloud Speech-to-Text-Dokumentation über China sagt
| Fakt | Primärquelle |
|---|---|
| Google Cloud Speech-to-Text hat keine Festland-China-Region — Audio wird offshore verarbeitet. Googles Dokumentation bietet nur „US and EU regional API endpoints“ (US- und EU-Regional-API-Endpunkte), wo „your data at-rest and in-use will stay within the continental boundaries of Europe or the USA“ (Ihre ruhenden und in Nutzung befindlichen Daten innerhalb der kontinentalen Grenzen Europas oder der USA bleiben), und die V2-API fügt Regionen „such as Belgium or Singapore“ (wie Belgien oder Singapur) hinzu. Google betreibt keine Cloud-Region auf dem chinesischen Festland (die nächsten sind asia-east1 in Taiwan und asia-east2 in Hong Kong, beide offshore) — und keine China-Partition wie andere Clouds sie betreiben. | Google Cloud — Speech-to-Text supported regional endpoints (cloud.google.com), abgerufen 2026-10-10 |
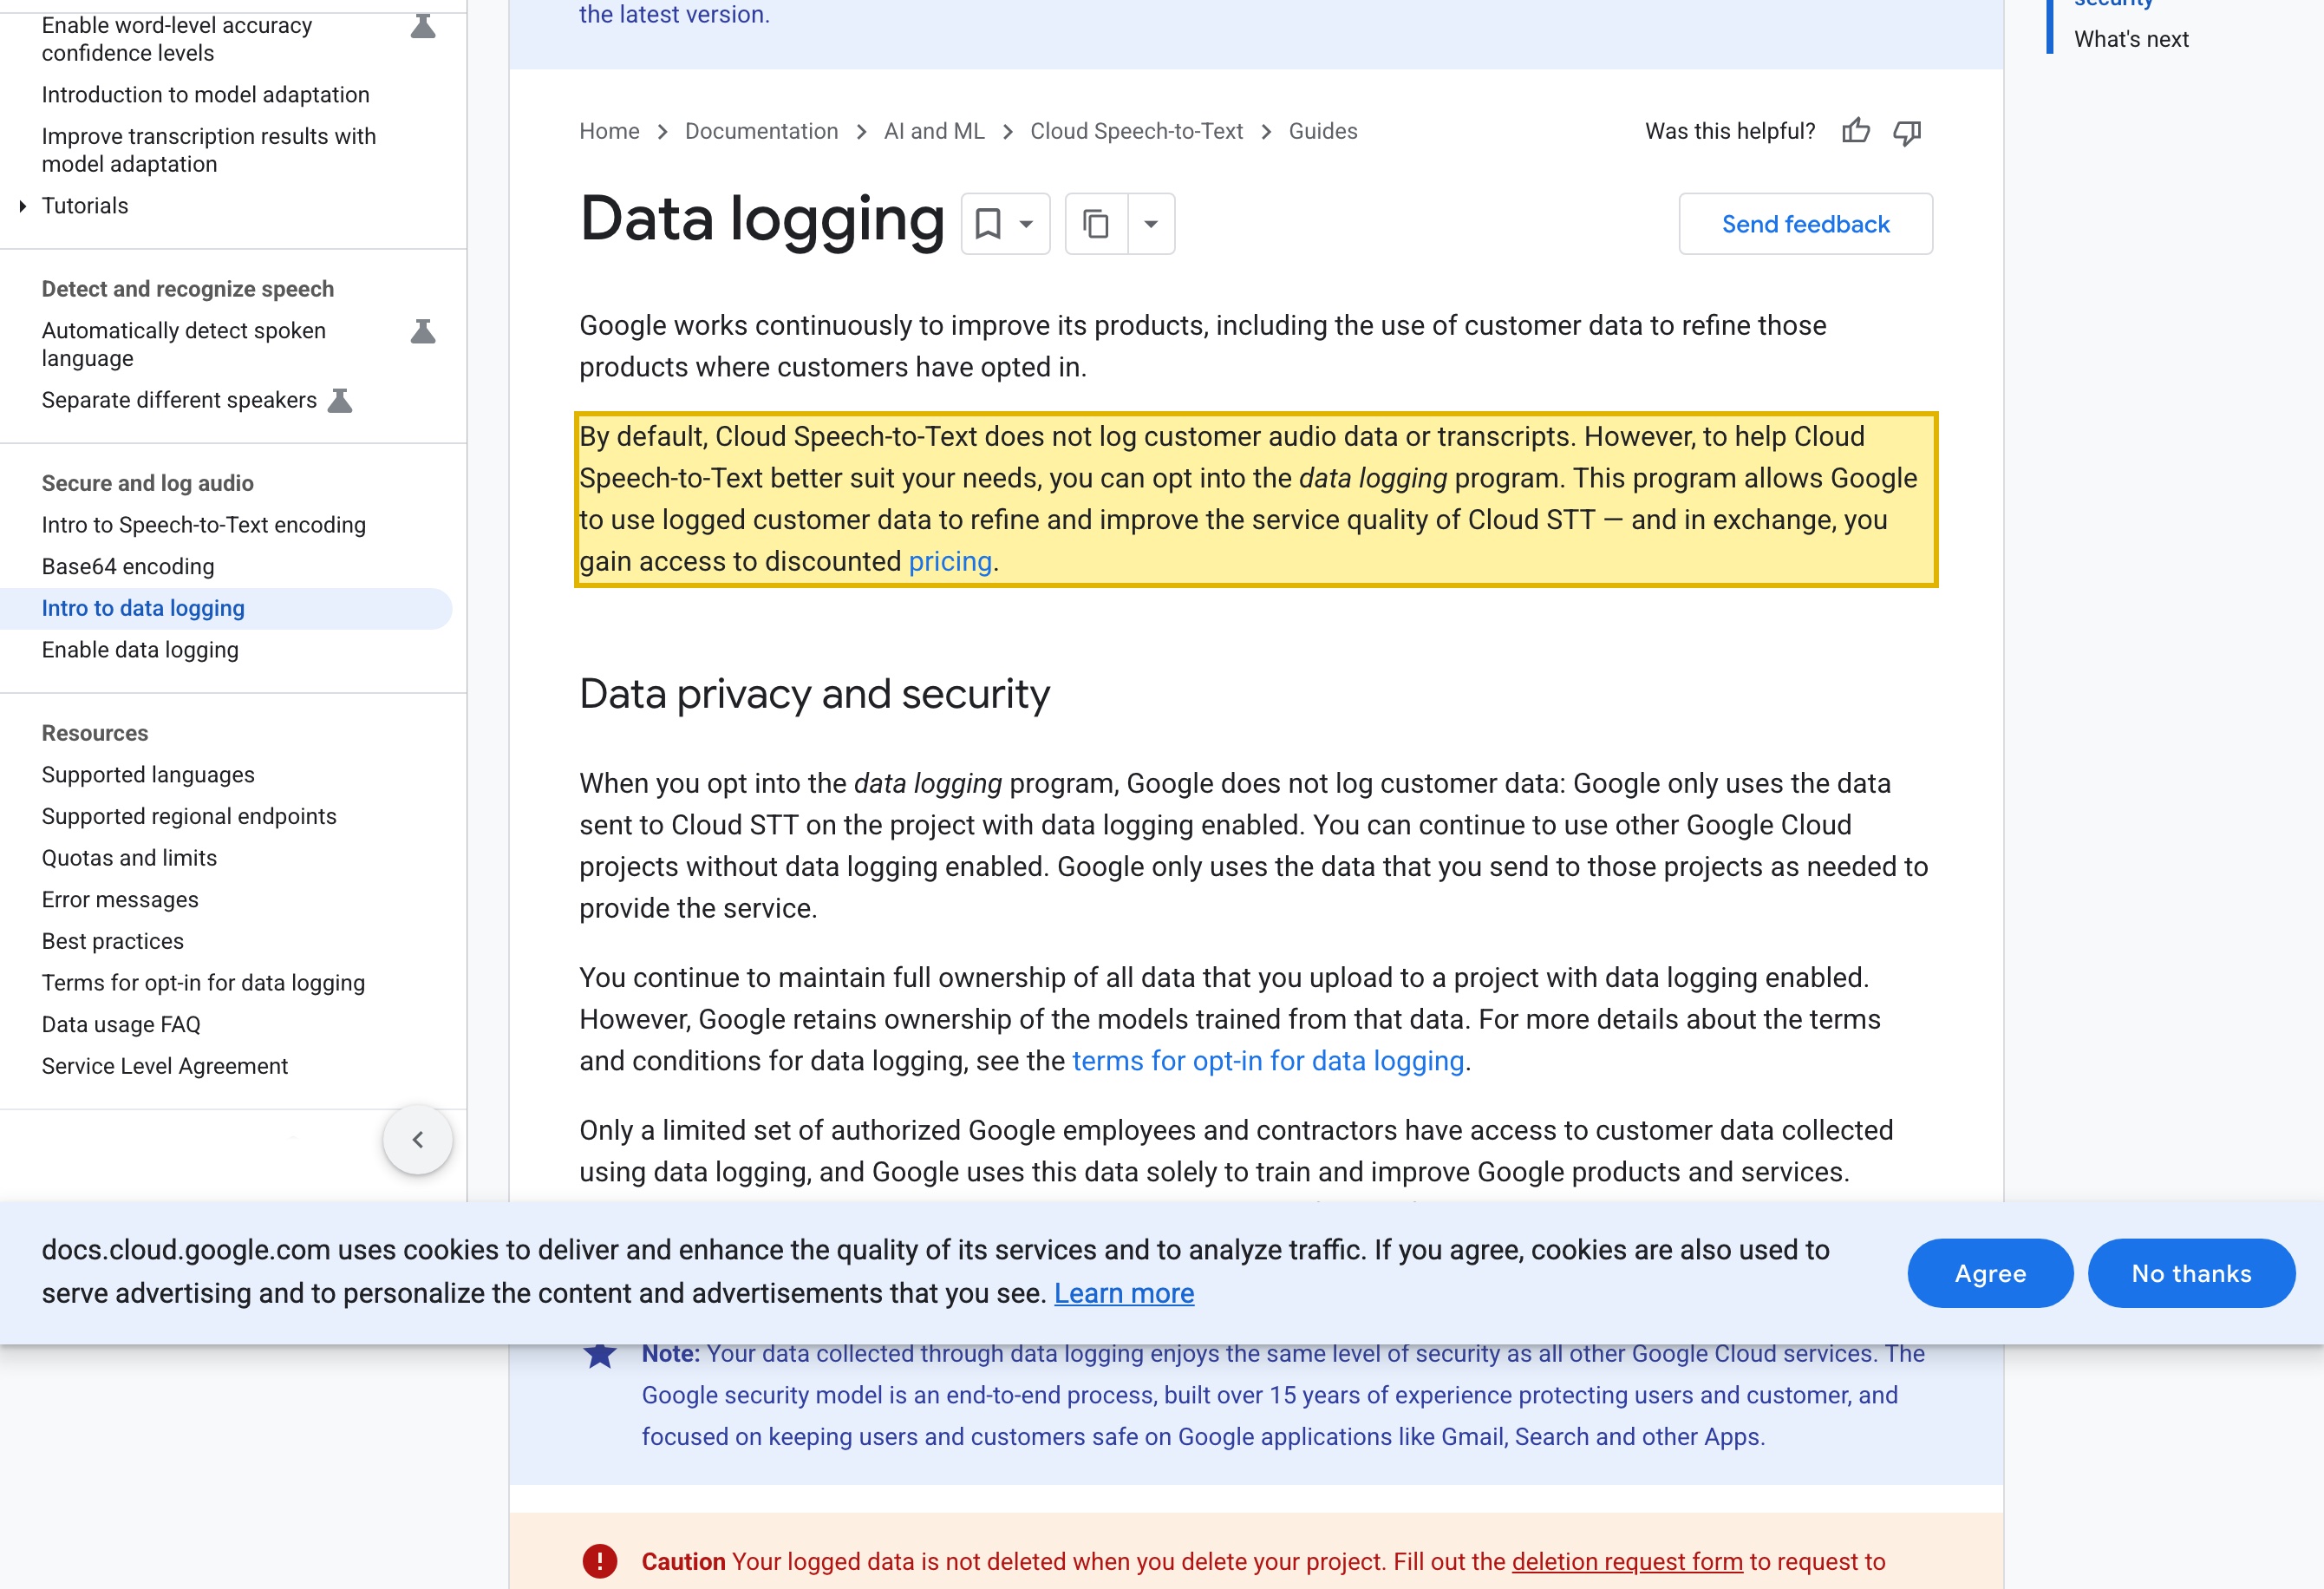
| Standardmäßig protokolliert Google Ihr Audio nicht und trainiert nicht darauf — aber ein Opt-in-Programm tut es. Google gibt an „By default, Cloud Speech-to-Text does not log customer audio data or transcripts“ (standardmäßig protokolliert Cloud Speech-to-Text keine Kunden-Audiodaten oder Transkripte); sein Opt-in-Data-Logging-Programm hingegen lässt „Google ... use this data solely to train and improve Google products and services“ (Google diese Daten ausschließlich zum Training und zur Verbesserung von Google-Produkten und -Diensten nutzen). Für China-stämmiges Audio lassen Sie das Logging deaktiviert, sodass Aufnahmen und Transkripte nicht offshore aufbewahrt oder trainiert werden. | Google Cloud — Speech-to-Text data logging (cloud.google.com), abgerufen 2026-10-10 |
| Ein On-Premises-Container-Build existiert — aber es ist eine private, vertriebsgesteuerte Funktion. Google bietet Cloud Speech-to-Text On-Prem, „a Google Cloud Marketplace application“ (eine Google-Cloud-Marketplace-Anwendung), die „can be deployed as a container to any GKE cluster“ (als Container in jedem GKE-Cluster bereitgestellt werden kann) und „on-premises with Anthos“ (On-Premises mit Anthos) laufen kann. Googles eigene Seite gibt an „you must contact Google for full access“ (Sie müssen Google für vollen Zugang kontaktieren), ein inländischer selbst gehosteter Pfad ist also möglich, aber Verfügbarkeit und Bedingungen werden mit Google bestätigt, nicht einfach eingeschaltet. | Google Cloud — Cloud Speech-to-Text On-Prem overview (cloud.google.com), abgerufen 2026-10-10 |
| Ein Stimmabdruck sind sensible biometrische personenbezogene Daten nach PIPL Art. 28. Das Audio eines China-Sprechers offshore zu transkribieren, ist ein grenzüberschreitender Transfer nach PIPL Art. 38–40 (Mitteilung, eine gesonderte Einwilligung und ein Transfermechanismus), während der Stimmabdruck in diesem Audio sensible personenbezogene Information nach Art. 28 ist — der eine gesonderte spezifische Einwilligung und eine vorherige Datenschutz-Folgenabschätzung (PIPIA) erfordert, der Sie durch Schwärzen des Textes nicht entgehen können. | Gesetz zum Schutz personenbezogener Daten der VR China, Art. 28 und 38–40 (cac.gov.cn), abgerufen 2026-10-10 |
Quellen vom 21YunBox Compliance-Team am 10. Oktober 2026 geprüft.
Für ein Publikum in Festlandchina ist die Frage, die zu Google Cloud Speech-to-Text zu klären ist, nicht, ob die API erreichbar ist — sondern, was mit dem Audio geschieht, das Sie ihr senden. Speech-to-Text ist ein Transkriptionsdienst: Audio von jemandem, der spricht, geht hinein, Text kommt zurück. Aber eine Aufnahme ist mehr als ihre Worte. Eine menschliche Stimme ist ein biometrischer Identifikator — ein Stimmabdruck —, und nach Chinas Gesetz zum Schutz personenbezogener Daten ist ein Stimmabdruck sensible personenbezogene Information (Art. 28), die das Schwärzen des Transkripts nicht weganonymisieren kann. Der gesprochene Inhalt — Support-Anrufe, Sprachnachrichten, diktierte medizinische oder juristische Notizen — ist oft für sich genommen sensibel. Google betreibt keine Festland-China-Region, sodass jede Anfrage auf seinen Offshore-Servern verarbeitet wird. Drei Pflichten greifen daher zugleich: ein PIPL-Grenztransfer (Art. 38–40), die Latte aus Einwilligung und Bewertung für sensible Biometrie (Art. 28) und Inhalts-Residenz für einen Betreiber kritischer Informationsinfrastruktur oder einen Verarbeiter großer Mengen.
Google Cloud Speech-to-Text in China auf einen Blick
| Worüber es entscheidet | In Google Cloud Speech-to-Texts eigenen Worten — und nach chinesischem Recht |
|---|---|
| Was Sie senden | Speech-to-Text nimmt Audio einer sprechenden Person und gibt Text zurück. Jeder Aufruf lädt die rohe Aufnahme hoch — den Stimmabdruck des Sprechers (ein biometrischer Identifikator) plus das Gesagte. Ein Transkript können Sie schwärzen; eine Stimme können Sie nicht anonymisieren. |
| Wohin es geht | Google betreibt keine Festland-China-Region. Seine Dokumentation bietet nur US- und EU-Regional-Endpunkte (und Regionen „such as Belgium or Singapore“ — wie Belgien oder Singapur); die nächsten Rechenzentren sind asia-east1 (Taiwan) und asia-east2 (Hong Kong), beide offshore des Festlands. China-stämmiges Audio dorthin zu senden, ist ein grenzüberschreitender Transfer personenbezogener Daten (PIPL Art. 38–40, 数据出境). |
| Ein Stimmabdruck sind sensible Daten | Nach PIPL Art. 28 sind biometrische Merkmale — einschließlich eines Stimmabdrucks — sensible personenbezogene Daten. Sie zu verarbeiten und zu exportieren, braucht eine gesonderte, spezifische Einwilligung und eine vorherige Datenschutz-Folgenabschätzung (PIPIA). Der gesprochene Inhalt kann weitere sensible Kategorien hinzufügen (Gesundheit, Finanzen, Ausweis). |
| Aufbewahrung, Training & Residenz | Standardmäßig „does not log customer audio data or transcripts“ (protokolliert Google keine Kunden-Audiodaten oder Transkripte), aber ein Opt-in-Data-Logging-Programm lässt es protokolliertes Audio nutzen, um „train and improve Google products and services“ (Google-Produkte und -Dienste zu trainieren und zu verbessern) — für China-Audio aus lassen. Ein On-Premises-Container-Build existiert (Cloud Speech-to-Text On-Prem, eine private Funktion). Für einen Betreiber kritischer Informationsinfrastruktur oder einen Verarbeiter großer Mengen fügt Cybersicherheitsgesetz Art. 39 (vormals Art. 37) Inland-Speicherung hinzu. |
| Die Achse | Erreichbarkeit ist nicht die Frage. Der rechtmäßige Hebel ist, die Verarbeitung von China-stämmigem Audio im Inland zu halten — ein selbst gehosteter/On-Prem-Sprachcontainer oder ein lizenzierter inländischer Sprachdienst — mit der Einwilligung nach Art. 28, nicht den Offshore-Endpunkt schneller zu machen. Die auf China ausgerichtete App, die das Audio erfasst, trägt zudem eine ICP-Beian-Pflicht und braucht inländische Auslieferung. |
Was Sie tatsächlich senden — die Stimmabdrücke und Worte Ihrer Sprecher
Speech-to-Text ist ein Transkriptionsdienst: Sie streamen oder laden Audio an einen Google-Endpunkt und erhalten Text. Die Ausgabe ist Text, was es leicht macht anzunehmen, die Datenschutzfrage drehe sich um das Transkript. Tut sie nicht. Das, was bei jeder Anfrage reist, ist die Aufnahme — und eine Aufnahme einer sprechenden Person ist ein biometrischer Identifikator dieser Person. Ein Transkript können Sie schwärzen; einen Stimmabdruck können Sie nicht zurücknehmen. Auf dem Stimmabdruck reitet der Inhalt selbst: ein Kundenservice-Anruf, eine Voicemail, das Diktat einer Ärztin, eine Zeugenaussage, ein internes Meeting — Kategorien, die routinemäßig sensibel sind, bevor Sie überhaupt den biometrischen Punkt erreichen.
Wohin geht dieses Audio? Google verarbeitet Speech-to-Text in Google-Cloud-Regionen, und es hat keine Region auf dem chinesischen Festland. Seine eigene Dokumentation bietet „US and EU regional API endpoints“ (US- und EU-Regional-API-Endpunkte), wo „your data at-rest and in-use will stay within the continental boundaries of Europe or the USA“ (Ihre ruhenden und in Nutzung befindlichen Daten innerhalb der kontinentalen Grenzen Europas oder der USA bleiben), und die V2-API fügt regionalisierte Verarbeitung in Regionen „such as Belgium or Singapore“ (wie Belgien oder Singapur) hinzu. Wählen Sie eine davon, um einen Nutzer in China zu bedienen, und das Audio verlässt das Land. Zur Aufbewahrung ist Googles Haltung günstig, aber bedingt: „By default, Cloud Speech-to-Text does not log customer audio data or transcripts“ (standardmäßig protokolliert Cloud Speech-to-Text keine Kunden-Audiodaten oder Transkripte), doch es betreibt auch ein Opt-in-Data-Logging-Programm, unter dem „Google uses this data solely to train and improve Google products and services“ (Google diese Daten ausschließlich zum Training und zur Verbesserung von Google-Produkten und -Diensten nutzt). Für China-stämmiges Audio ist dieses Opt-in ein Schalter, den Sie aus lassen — aber ihn aus zu lassen, ändert nichts daran, dass die Verarbeitung selbst offshore geschieht.
Es ist ein grenzüberschreitender Transfer sensibler biometrischer Daten — nach PIPL
Weil das Audio außerhalb des Festlands verarbeitet wird, ist das Senden der Aufnahme eines China-Sprechers an Speech-to-Text ein grenzüberschreitender Transfer personenbezogener Daten nach Chinas Gesetz zum Schutz personenbezogener Daten. PIPL Art. 38–40 legen die Pflicht auf Sie, den Verarbeiter — nicht auf Google — und verlangen Mitteilung, eine gesonderte Einwilligung, getrennt von der Zustimmung des Nutzers zur Nutzung der Funktion, und einen rechtmäßigen Transfermechanismus: eine CAC-Sicherheitsbewertung, den CAC-Standardvertrag oder eine Zertifizierung.
Der Stimmabdruck hebt die Latte weiter. Nach PIPL Art. 28 sind biometrische Merkmale sensible personenbezogene Daten, und sie zu verarbeiten verlangt eine gesonderte spezifische Einwilligung und eine vorherige Datenschutz-Folgenabschätzung (PIPIA), bevor die Daten verarbeitet oder übertragen werden. Eine Sprachaufnahme ist ihrer Natur nach biometrisch; Namen aus dem Transkript zu entfernen, ändert nicht, was das Audio ist. Wo der gesprochene Inhalt selbst Gesundheits-, Finanz- oder Identitätsdaten sind, stapeln sich weitere Pflichten für sensible Kategorien obendrauf.
Darunter sitzt die Residenz. Ein Betreiber kritischer Informationsinfrastruktur oder ein Verarbeiter oberhalb der Mengenschwellen muss in China erhobene personenbezogene Daten im Festland speichern — PIPL Art. 40 zusammen mit dem Cybersicherheitsgesetz (Art. 39 in der seit 1. Januar 2026 geltenden Novelle, die den Artikel zur Datenlokalisierung von Art. 37 auf Art. 39 umnummeriert hat, inhaltlich unverändert) — eine Pflicht, die eine Offshore-Region strukturell nicht erfüllen kann. Wo Mengen oder Sensibilität die Schwellen überschreiten, braucht der Export selbst eine CAC-Datenexport-Sicherheitsbewertung, bevor er fortschreiten darf. Nichts davon betrifft, wie schnell ein Transkript zurückkehrt.
Die API zu erreichen, ist nicht die Frage — das Audio im Inland zu halten, ist es
Der Hebel ist nicht, den Offshore-Endpunkt schneller oder erreichbarer zu machen; er ist, den Export von China-stämmigem Audio zu stoppen und es auf einem inländischen, einwilligungsgestützten Pfad zu verarbeiten. Für Speech-to-Text gibt es zwei ehrliche Inland-Optionen. Erstens veröffentlicht Google seinen eigenen On-Premises-Build: Cloud Speech-to-Text On-Prem, „a Google Cloud Marketplace application“ (eine Google-Cloud-Marketplace-Anwendung), die „can be deployed as a container to any GKE cluster“ (als Container in jedem GKE-Cluster bereitgestellt werden kann) und „on-premises with Anthos“ (On-Premises mit Anthos) laufen kann — sodass die Erkennung auf Infrastruktur ausgeführt werden kann, die Sie im Festland platzieren, statt Googles Offshore-Regionen aufzurufen. Es ist eine private Funktion; Googles eigene Seite gibt an „you must contact Google for full access“ (Sie müssen Google für vollen Zugang kontaktieren), behandeln Sie Verfügbarkeit und Bedingungen also als etwas, das Sie direkt mit Google bestätigen, keinen Selbstbedienungs-Schalter. Zweitens, wo dieser Pfad Ihnen nicht offensteht, leiten Sie China-stämmiges Audio über einen lizenzierten inländischen Sprachdienst — einen inländischen Sprachanbieter, bei dem die Daten im Festland bleiben.
So oder so reisen die Pflichten mit dem Audio: die gesonderte Einwilligung nach Art. 28 einholen, die PIPIA durchführen, das Opt-in-Data-Logging-Programm aus lassen, sodass keine China-Aufnahme aufbewahrt oder zum Training genutzt wird, und minimieren, was Sie erfassen. Was Sie nicht tun, ist, einen Weg zu bauen, der das Audio offshore verschifft, und es lokal zu nennen. Dies ist eine Risikokarte, kein Urteil — klären Sie die Einzelheiten, welcher Pfad, welche Einwilligung, welche Schwellen, mit Rechtsbeistand.
Der rechtmäßige Weg — kartieren, lokalisieren, ausliefern
Es gibt einen rechtmäßigen Weg, Speech-to-Text für Ihre Nutzer in China zu betreiben, und er hat eine klare Gestalt: China-stämmiges Audio wird aus dem Land heraus auf einer einwilligungsgestützten Grundlage verarbeitet, der Stimmabdruck wird als die sensiblen Daten behandelt, die er ist, und die auf China ausgerichtete App, die das Audio erfasst, ist selbst gemeldet und im Inland ausgeliefert. Der Teil, den 21YunBox verantwortet, ist diese Grundlage, und er ist mehr als Beratung. Unser China-Team tut drei Dinge. Wir kartieren, welches Audio zum Sprachdienst fließt — wessen Stimmabdrücke und welchen gesprochenen Inhalt es trägt, wo es verarbeitet und ob es aufbewahrt oder zum Training genutzt wird, und wo Ihnen eine Rechtsgrundlage fehlt (die gesonderte Einwilligung nach Art. 28 und die PIPIA, ein Transfermechanismus). Wir lokalisieren die Verarbeitung auf einen Inland-Pfad — einen selbst gehosteten oder On-Premises-Sprachcontainer oder einen lizenzierten inländischen Sprachdienst —, sodass China-Audio im Festland bleibt, statt exportiert zu werden, mit korrekt gehandhabter Einwilligung und Aufbewahrung. Und wir liefern die auf China ausgerichtete App, die das Audio erfasst und zeigt, auf ICP-gemeldeter, inländischer Infrastruktur aus — der 21YunBox Optimizer — vor dem Stack, den Sie bereits betreiben, ohne Neuaufbau und ohne Re-Platforming.
Das Ergebnis ist eine Sprachfunktion, die für Ihre Nutzer in China rechtmäßig und rechtskonform läuft. 21YunBox verwendet oder empfiehlt niemals eine Umgehung welcher Art auch immer. Dies ist ein rechtmäßiges, datenresidentes Inland-Deployment, und wo ein Dienst im Festland nicht angeboten wird, lokalisieren wir auf ein lizenziertes inländisches Äquivalent, statt offshore zu greifen.
Compliance-Einschätzung anfordern →
Weiterführend:
- Grenzüberschreitende Datentransfers nach PIPL
- Chinas Cybersicherheitsgesetz — Art. 39 (vormals Art. 37) und Datenlokalisierung
- Chinas Maßnahmen zur Datenexport-Sicherheitsbewertung
- So erhalten Sie eine ICP-Beian für China
Häufige Fragen
Hat Google Cloud Speech-to-Text ein Rechenzentrum oder eine Region in Festlandchina?
Nein. Google verarbeitet Speech-to-Text in Google-Cloud-Regionen und betreibt keine Region auf dem chinesischen Festland — seine Dokumentation bietet nur US- und EU-Regional-Endpunkte und Regionen „wie Belgien oder Singapur“, und die nächsten Rechenzentren, asia-east1 (Taiwan) und asia-east2 (Hong Kong), sind offshore des Festlands. Anders als die Clouds, die eine China-Partition betreiben, gibt es kein Festland-Google-Cloud. Audio, das von Menschen in China erfasst und an Speech-to-Text gesendet wird, verlässt also das Land — ein PIPL-Grenztransfer, für den Sie eine Rechtsgrundlage haben müssen.
Nutzt Google mein Speech-to-Text-Audio, um seine Modelle zu trainieren?
Standardmäßig nein: Google gibt an „By default, Cloud Speech-to-Text does not log customer audio data or transcripts.“ Es betreibt ein Opt-in-Data-Logging-Programm, und wenn Sie es aktivieren, „nutzt Google diese Daten ausschließlich zum Training und zur Verbesserung von Google-Produkten und -Diensten“ (und behält das Eigentum an den daraus trainierten Modellen). Für China-stämmiges Audio lassen Sie dieses Programm deaktiviert. So oder so geschieht die Verarbeitung auf Offshore-Servern, sodass das Deaktivieren des Loggings die Aufbewahrung reduziert, aber die Grenztransfer-Frage nicht entfernt.
Was ist der rechtmäßige Weg, Festland-China-Audio zu transkribieren?
Halten Sie die Verarbeitung im Inland, statt das Audio zu exportieren. Zwei ehrliche Optionen: Hosten Sie ein Sprachmodell selbst in China — Googles eigenen Cloud-Speech-to-Text-On-Prem-Container (eine private Funktion, die Sie mit Google arrangieren) oder ein offenes Modell, das Sie auf Inland-Infrastruktur betreiben — oder leiten Sie das Audio über einen lizenzierten inländischen Sprachdienst mit im Festland gehaltenen Daten. Darüber hinaus die gesonderte Einwilligung nach Art. 28 einholen, eine PIPIA durchführen und die auf China ausgerichtete App (ICP), die das Audio erfasst, melden und ausliefern. 21YunBox kartiert die Exponierung, lokalisiert auf einen Inland-Pfad und liefert ihn im Inland aus — und verwendet oder empfiehlt niemals eine Umgehung welcher Art auch immer. Bestätigen Sie die Einzelheiten mit Rechtsbeistand.


