Google Cloud Speech-to-Textは中国本土で使えるか:PIPLの越境移転・声紋バイオメトリクス・データの国内保存
Google Cloud Speech-to-Textに文字起こしのために送る音声は、話者の声紋——匿名化できない第28条のセンシティブなバイオメトリック個人情報——を運び、Googleは中国本土のリージョンを運用しないため、その音声はオフショアで処理されます:PIPL上の越境移転です。声紋・データの国内保存・保持、そして法令に沿った中国国内の音声経路を、コンプライアンス起点で読み解きます。
Google Cloud Speech-to-Textは中国本土で使えるか
Google Cloud Speech-to-Textに文字起こしのために送る録音は話者の声紋——第28条のセンシティブなバイオメトリック個人情報——であり、Googleが中国本土のリージョンを運用しないため、各リクエストはその音声をオフショアで処理します。
Speech-to-Textは音声をテキストに変えますが、音声自体がバイオメトリックな識別子に、話された内容すべて——通話録音、ボイスメッセージ、口述メモ——を加えて運びます。したがって中国由来の音声をGoogleのオフショアのサーバーへ送ることは、センシティブな個人情報(第28条)のPIPL上の越境移転であり、文字起こしを伏せても取り消せません。既定でGoogleは音声をログに記録・訓練に使いませんが、オプトインのデータログプログラムは使います——中国の音声については無効にする設定です。法令に沿った打ち手は、中国の音声の処理を中国国内に留めること——自前ホスト/オンプレミスの音声コンテナ、またはライセンスを得た国内の音声サービス——で、第28条の個別の同意とPIPIAを伴います。オフショアのエンドポイントを到達しやすくすることではありません。
これは判定ではなくリスクの見取り図です——具体は専門家と確定してください。当社の中国チームが貴社のリスクを整理します →
コンプライアンス・スナップショット
- ✕ Google Cloudに中国本土のリージョンはない。音声はオフショアのサーバーで文字起こしされる
- ! 音声は話者の声紋——PIPL第28条のセンシティブなバイオメトリクスで匿名化できない
- ! その音声をオフショアへ送ることはPIPL上の越境移転(第38〜40条)
- ! 既定でGoogleは音声を訓練に使わないが、オプトインのログプログラムは使う
- ! CSL第39条(旧第37条)はCIIOや大量取扱者に中国国内保存を加える
- ✓ 法令に沿った道:中国国内の音声(自前ホストまたはライセンス国内)+第28条の同意+ICP
Google Cloud Speech-to-Textの公式ドキュメントが中国について述べていること
| 事実 | 一次情報源 |
|---|---|
| Google Cloud Speech-to-Textに中国本土のリージョンはなく——音声はオフショアで処理されます。Googleのドキュメントは“US and EU regional API endpoints”(米国とEUのリージョナルAPIエンドポイント)のみを提供し、そこでは“your data at-rest and in-use will stay within the continental boundaries of Europe or the USA”(保存中・使用中のデータは欧州または米国の大陸の境界内に留まる)とされ、V2 APIは“such as Belgium or Singapore”(ベルギーやシンガポールなど)のリージョンを加えます。Googleは中国本土にクラウドリージョンを運用せず(最も近いのは asia-east2 の香港などで、いずれも本土の外)——他のクラウドが運用するような中国パーティションもありません。 | Google Cloud — Speech-to-Text supported regional endpoints(cloud.google.com)、2026-10-10 取得 |
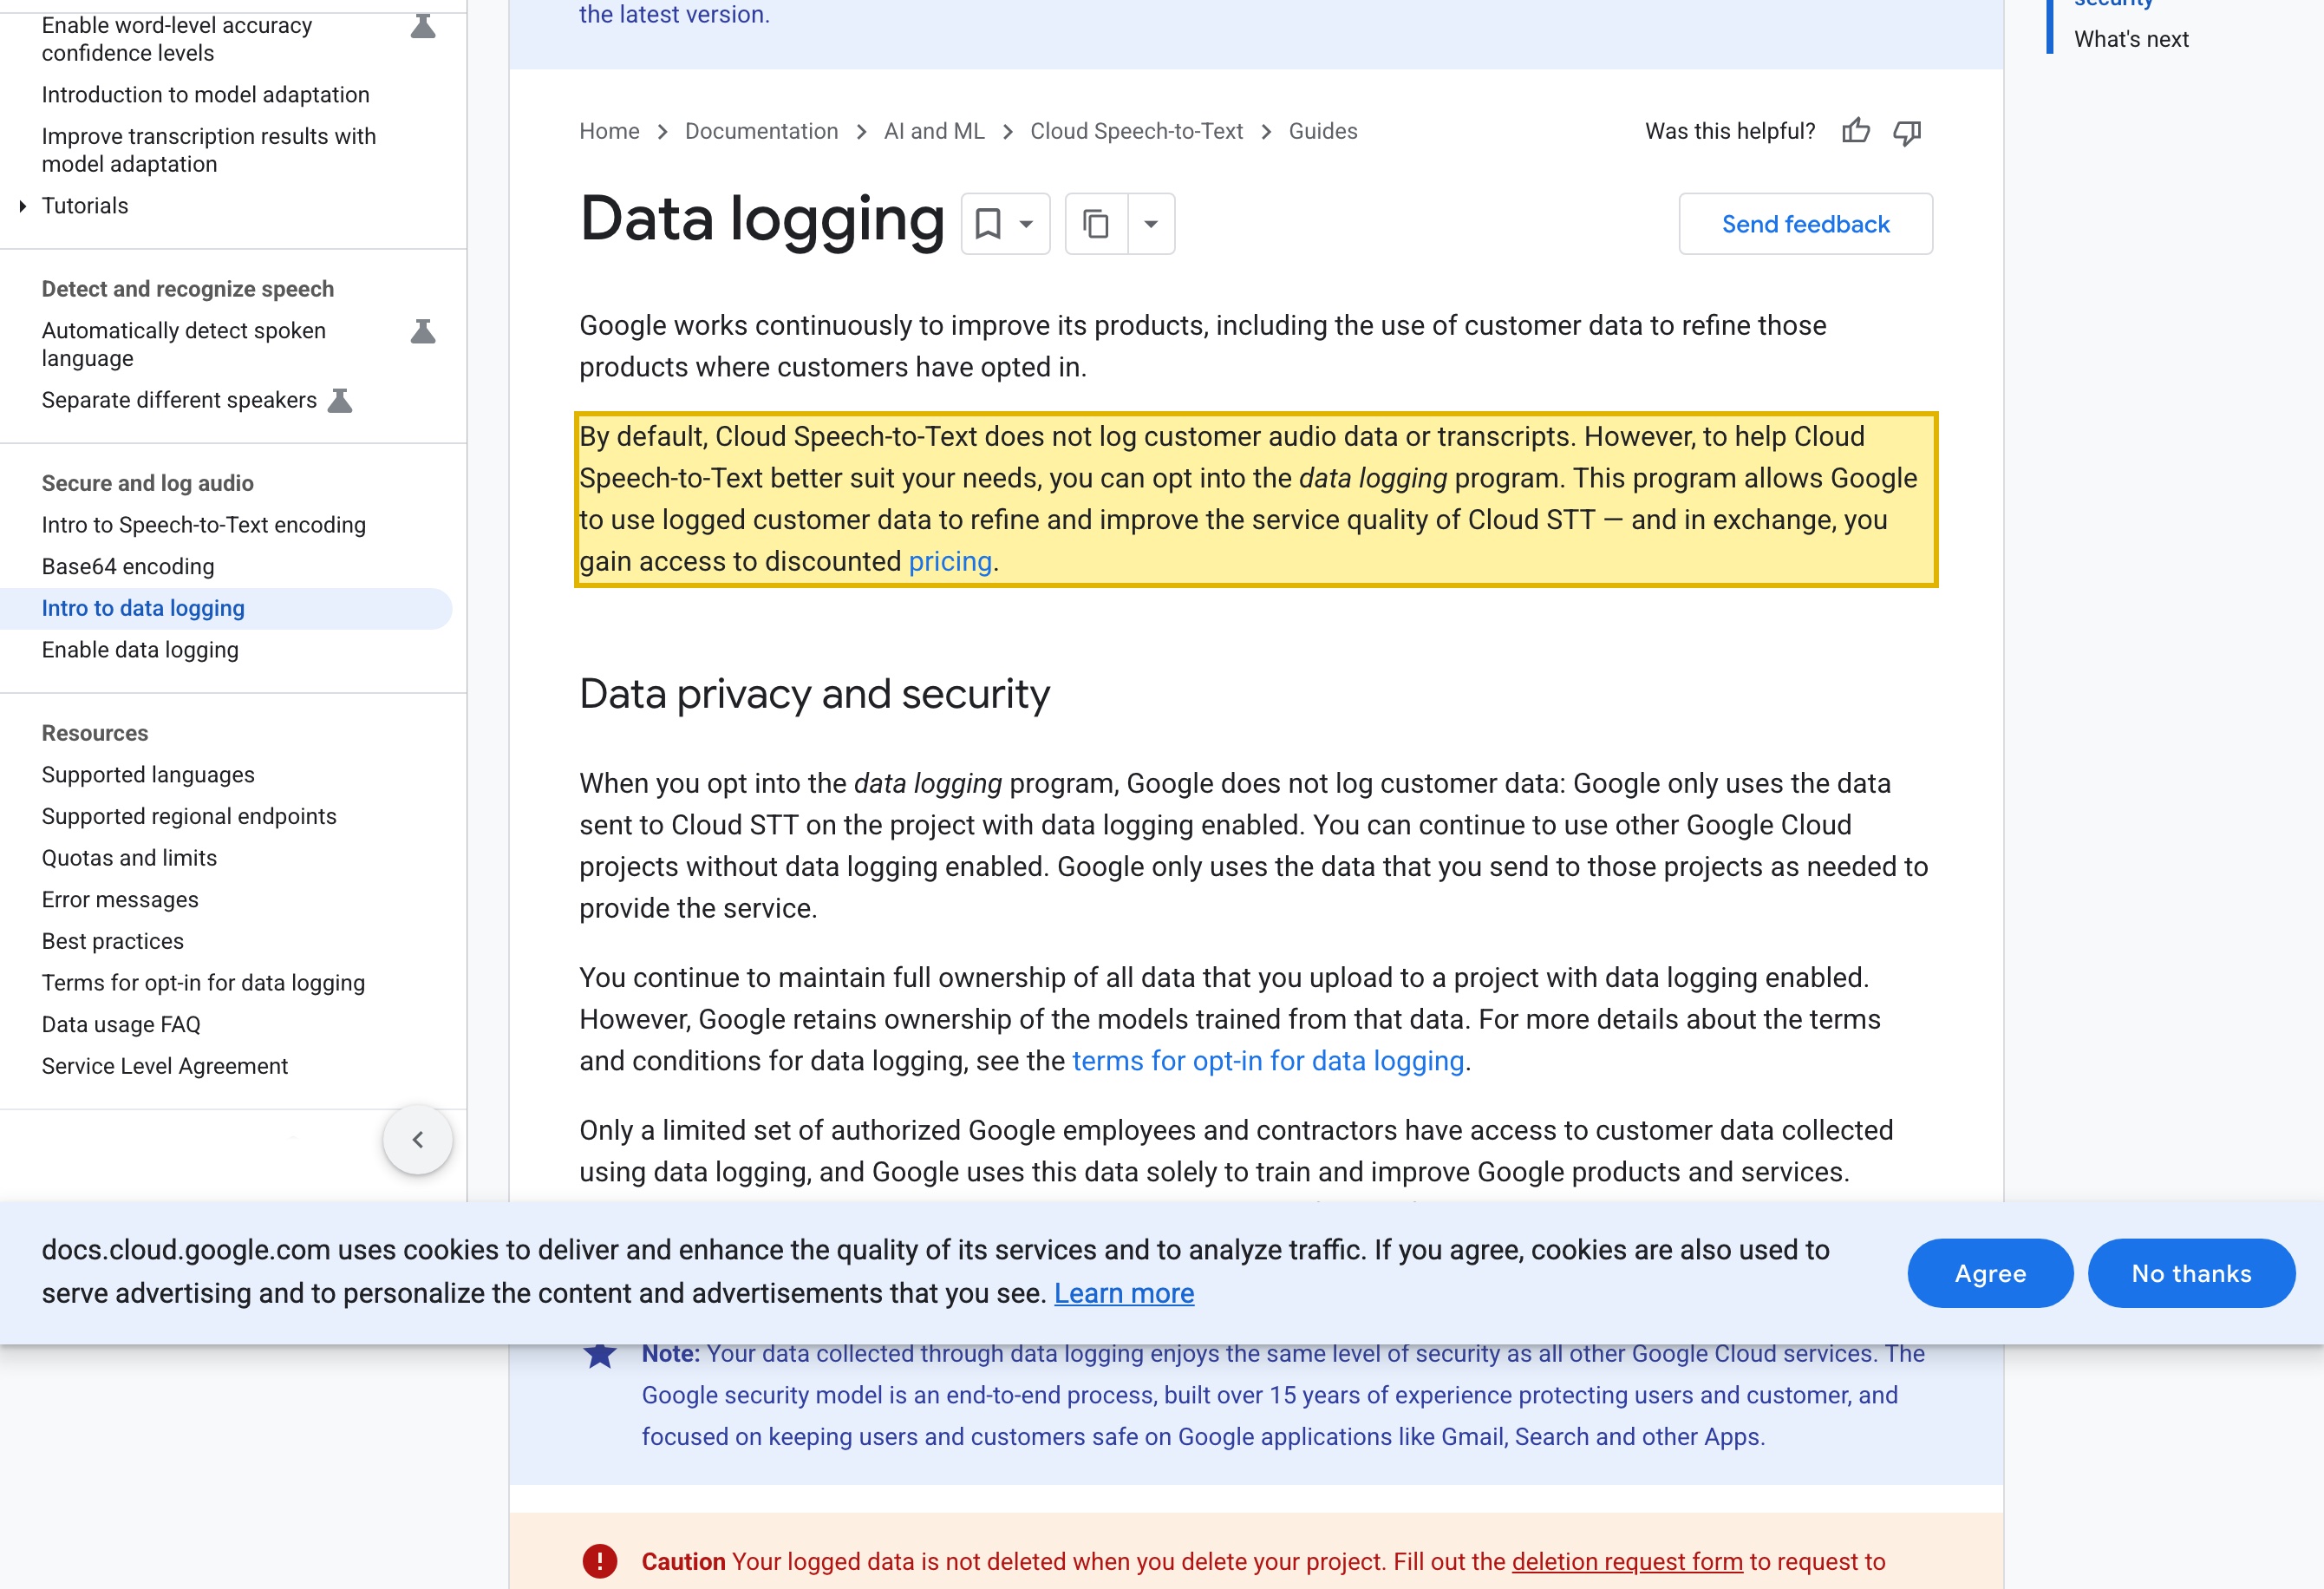
| 既定でGoogleは音声をログに記録・訓練に使いません——しかしオプトインのプログラムは使います。Googleは“By default, Cloud Speech-to-Text does not log customer audio data or transcripts”(既定では顧客の音声データや文字起こしをログに記録しない)とし、対照的にオプトインのデータログプログラムは“Google ... use this data solely to train and improve Google products and services”(Googleはこのデータをもっぱら製品・サービスの訓練と改善に使う)を許します。中国由来の音声については、録音と文字起こしがオフショアで保持・訓練に使われないよう、ログ記録を無効のままにしてください。 | Google Cloud — Speech-to-Text data logging(cloud.google.com)、2026-10-10 取得 |
| オンプレミスのコンテナ版も存在しますが——プライベートで営業窓口を要する機能です。GoogleはCloud Speech-to-Text On-Premを提供し、“a Google Cloud Marketplace application”(Google Cloud Marketplaceのアプリケーション)で“can be deployed as a container to any GKE cluster”(任意のGKEクラスターにコンテナとしてデプロイできる)、“on-premises with Anthos”(Anthosでオンプレミス)で動かせます。Google自身のページは“you must contact Google for full access”(完全なアクセスにはGoogleへの問い合わせが必要)としており、中国国内の自前ホスト経路は可能ですが、提供可否と条件はトグルで有効化するのではなくGoogleに確認します。 | Google Cloud — Cloud Speech-to-Text On-Prem overview(cloud.google.com)、2026-10-10 取得 |
| 声紋はPIPL第28条の下でのセンシティブなバイオメトリック個人情報です。中国の話者の音声をオフショアで文字起こしすることはPIPL第38〜40条の下での越境移転(通知、個別の同意、移転メカニズム)であり、その音声の中の声紋は第28条の下でのセンシティブな個人情報——文字起こしを伏せても逃れられない、個別の特定の同意と事前の保護影響評価(PIPIA)——を要します。 | Personal Information Protection Law of the PRC, Articles 28 and 38–40(cac.gov.cn)、2026-10-10 取得 |
情報源は21YunBox コンプライアンスチームが2026年10月10日に確認しました。
中国本土の利用者にとって、Google Cloud Speech-to-Textについて確定すべき問いは、APIに到達できるかではありません——そこに送る音声に何が起きるか、です。Speech-to-Textは文字起こしのサービスです。誰かが話す音声が入り、テキストが返ります。しかし録音はその言葉以上のものです。人間の声はバイオメトリックな識別子——声紋——であり、中国の個人情報保護法の下では、声紋はセンシティブな個人情報(第28条)であって、文字起こしを伏せても匿名化できません。話された内容——サポート通話、ボイスメッセージ、口述された医療・法務のメモ——はそれ自体がしばしばセンシティブです。Googleは中国本土のリージョンを運用しないため、各リクエストはそのオフショアのサーバーで処理されます。したがって三つの義務が同時に効きます。PIPL上の越境移転(第38〜40条)、センシティブなバイオメトリクスの同意と評価のハードル(第28条)、そして重要情報インフラ取扱者または大量取扱者についてのコンテンツの国内保存です。
中国でのGoogle Cloud Speech-to-Text:ひと目で
| 決め手 | Google Cloud Speech-to-Text自身の言葉で——そして中国の法では |
|---|---|
| 何を送るか | Speech-to-Textは人が話す音声を受け取りテキストを返します。各呼び出しは生の録音——話者の声紋(バイオメトリックな識別子)に、話された内容すべてを加えたもの——をアップロードします。文字起こしは伏せられますが、声は匿名化できません。 |
| どこへ行くか | Googleは中国本土のリージョンを運用しません。そのドキュメントは米国とEUのリージョナルエンドポイント(および「ベルギーやシンガポール」などのリージョン)のみを提供し、最も近いデータセンターは asia-east2(香港)などで、いずれも本土の外です。中国由来の音声をそこへ送ることは個人情報の越境移転(PIPL第38〜40条、数据出境)です。 |
| 声紋はセンシティブなデータ | PIPL第28条の下で、声紋を含むバイオメトリック特徴はセンシティブな個人情報です。その処理と移転には、個別の特定の同意と事前の個人情報保護影響評価(PIPIA)が必要です。話された内容はさらなるセンシティブなカテゴリー(健康・金融・身分証)を加えることがあります。 |
| 保持・訓練・国内保存 | 既定ではGoogleは“does not log customer audio data or transcripts”(顧客の音声データや文字起こしをログに記録しない)ですが、オプトインのデータログプログラムはログ化した音声を“train and improve Google products and services”(Google製品・サービスの訓練と改善)に使えるようにします——中国の音声についてはオフにしてください。オンプレミスのコンテナ版(Cloud Speech-to-Text On-Prem、プライベート機能)も存在します。CIIOや大量取扱者には、サイバーセキュリティ法 第39条(旧第37条)が中国国内保存を加えます。 |
| 軸 | 到達性は問いではありません。法令に沿った打ち手は、中国由来の音声の処理を中国国内に留めること——自前ホスト/オンプレミスの音声コンテナ、またはライセンスを得た国内の音声サービス——で、第28条の同意を伴います。オフショアのエンドポイントを速くすることではありません。音声を取得する中国向けのアプリもICP備案の義務を負い、中国国内からの配信を必要とします。 |
実際に何を送るのか——話者の声紋と言葉
Speech-to-Textは文字起こしのサービスです。音声をGoogleのエンドポイントにストリーム送信またはアップロードし、テキストを受け取ります。出力はテキストなので、プライバシーの問いは文字起こしについてだと思い込みがちです。そうではありません。各リクエストで移動するのは録音——そして人が話す録音は、その人のバイオメトリックな識別子です。文字起こしは伏せられますが、声紋は言い直せません。声紋の上に内容そのものが乗ります。顧客サービスの通話、ボイスメール、医師の口述、証言録取、社内会議——バイオメトリックの点に至る前から日常的にセンシティブなカテゴリーです。
その音声はどこへ行くのか。GoogleはSpeech-to-TextをGoogle Cloudのリージョンで処理し、中国本土にリージョンを持ちません。そのドキュメントは“US and EU regional API endpoints”(米国とEUのリージョナルAPIエンドポイント)を提供し、そこでは“your data at-rest and in-use will stay within the continental boundaries of Europe or the USA”(保存中・使用中のデータは欧州または米国の大陸の境界内に留まる)とされ、V2 APIは“such as Belgium or Singapore”(ベルギーやシンガポールなど)のリージョンでのリージョナル処理を加えます。中国の利用者に提供するためにそのどれを選んでも、音声は国を出ます。保持については、Googleの姿勢は有利ですが条件付きです:“By default, Cloud Speech-to-Text does not log customer audio data or transcripts”(既定では顧客の音声データや文字起こしをログに記録しない)とする一方、オプトインのデータログプログラムも運用し、その下では“Google uses this data solely to train and improve Google products and services”(Googleはこのデータをもっぱら製品・サービスの訓練と改善に使う)。中国由来の音声についてそのオプトインはオフに保つスイッチですが——オフに保っても、処理そのものがオフショアで起きるという事実は変わりません。
それはセンシティブなバイオメトリックデータの越境移転である——PIPLの下で
音声が本土の外で処理されるため、中国の話者の録音をSpeech-to-Textへ送ることは、中国の個人情報保護法の下での個人情報の越境移転です。PIPL第38〜40条は義務を取扱者である貴社に課し——Googleにではなく——通知、利用機能への同意とは別の個別の同意、そして合法な移転メカニズムのいずれか一つ(CACの安全評価、CAC標準契約、または認証)を求めます。
声紋はハードルをさらに上げます。PIPL第28条の下で、バイオメトリック特徴はセンシティブな個人情報であり、その処理には、データが処理・移転される前に、個別の特定の同意および事前の個人情報保護影響評価(PIPIA)が必要です。声の録音はその性質上バイオメトリックであり、文字起こしから名前を取り除いても音声が何であるかは変わりません。話された内容それ自体が健康・金融・身分のデータである場合、さらなるセンシティブ・カテゴリーの義務が上に重なります。
その下に国内保存が座ります。重要情報インフラ運営者、または取扱量の閾値を越える取扱者は、中国で収集した個人情報を本土内に保存しなければなりません——PIPL第40条とあわせてサイバーセキュリティ法(英語)(2026年1月1日施行の改正における第39条で、データ国内保存の条文を第37条から第39条へ振り直し、実質は変わりません)——オフショアのリージョンが構造上満たせない義務です。取扱量や機微性が閾値を越える場合、移転自体にも、進める前にCACのデータ越境安全評価(英語)が必要です。これはどれも、文字起こしがどれだけ速く返るかの話ではありません。
APIに到達できるかは問いではない——音声を中国国内に留められるかだ
打ち手は、オフショアのエンドポイントを速く・より到達しやすくすることではありません。中国由来の音声の輸出をやめ、同意済みの中国国内の経路で処理することです。音声認識には正直な中国国内の選択肢が二つあります。第一に、Googleは自社のオンプレミス版を公開しています:Cloud Speech-to-Text On-Prem、“a Google Cloud Marketplace application”(Google Cloud Marketplaceのアプリケーション)で“can be deployed as a container to any GKE cluster”(任意のGKEクラスターにコンテナとしてデプロイできる)、“on-premises with Anthos”(Anthosでオンプレミス)で動かせます——認識を、Googleのオフショアのリージョンを呼ぶ代わりに、本土の内側に置いたインフラ上で実行できます。これはプライベート機能で、Google自身のページは“you must contact Google for full access”(完全なアクセスにはGoogleへの問い合わせが必要)としているため、提供可否と条件はセルフサービスのトグルではなくGoogleに直接確認すべきものとして扱ってください。第二に、その経路が開かれていない場合、中国由来の音声をライセンスを得た中国国内の音声サービス——データを本土に留める国内の音声プロバイダー——に通します。
いずれにせよ、義務は音声とともに動きます。第28条の個別の同意を取得し、PIPIAを実施し、オプトインのデータログプログラムをオフに保って中国の録音が保持・訓練に使われないようにし、取得するものを最小化します。してはならないのは、音声をオフショアへ送り出しながら国内だと称する仕組みを作ることです。これは判定ではなくリスクの見取り図です——どの経路か、どの同意か、どの閾値かの具体は、専門家と確定させてください。
法令に沿った経路——把握し、国内化し、届ける
中国の利用者に向けて音声認識を合法的に運用する道があり、それには明確な形があります。中国由来の音声は国の内側から同意済みの基盤で処理され、声紋はそれがそうであるセンシティブなデータとして扱われ、音声を取得する中国向けのアプリ自体が備案・配信されます。21YunBoxが担うのはその基盤であり、助言以上のものです。当社の中国チームは三つを行います。音声サービスへどんな音声が流れるか——誰の声紋とどんな発話内容を運ぶか、どこで処理され、保持や訓練に使われるか、そして合法な根拠(第28条の個別の同意とPIPIA、移転メカニズム)を欠くのはどこか——を**把握(Map)します。処理を中国国内の経路——自前ホストまたはオンプレミスの音声コンテナ、あるいはライセンスを得た国内の音声サービス——へ国内化(Localize)し、中国の音声が輸出されず本土に留まるようにして、同意と保持を正しく扱います。そして音声を取得・提示する中国向けのアプリを、すでに運用中のスタックの前段で、ICP備案済みの中国国内のインフラ——21YunBox Optimizer——上で配信(Deliver)**します——作り直しも再プラットフォーム化もなしに。
その結果が、中国の利用者に向けて合法かつ法令適合で動く音声機能です。21YunBoxは、いかなる種類の不正な手段も用いず、推奨もしません。これは合法で、データが中国に所在する中国国内のデプロイであり、サービスが本土で提供されない場合は、オフショアに手を伸ばすのではなく、ライセンスを得た国内の同等物へ国内化します。
関連する読み物:
よくあるご質問
Google Cloud Speech-to-Textは中国本土にデータセンターやリージョンを持ちますか?
いいえ。GoogleはSpeech-to-TextをGoogle Cloудのリージョンで処理し、中国本土にリージョンを運用しません——そのドキュメントは米国とEUのリージョナルエンドポイントと「ベルギーやシンガポール」などのリージョンのみを提供し、最も近いデータセンター(asia-east2 の香港など)は本土の外です。中国パーティションを運用するクラウドと違い、本土のGoogle Cloudはありません。したがって中国の人々から取得してSpeech-to-Textへ送る音声は国を出ます——合法な根拠が必要なPIPL上の越境移転です。
GoogleはSpeech-to-Textの音声を自社モデルの訓練に使いますか?
既定では、いいえ:Googleは“By default, Cloud Speech-to-Text does not log customer audio data or transcripts”(既定では顧客の音声データや文字起こしをログに記録しない)とします。オプトインのデータログプログラムは運用しており、オプトインすると“Google uses this data solely to train and improve Google products and services”(Googleはこのデータをもっぱら製品・サービスの訓練と改善に使う)となります。中国由来の音声については、そのプログラムを無効のままにしてください。いずれにせよ処理はオフショアのサーバーで起きるため、ログ記録を無効にすると保持は減りますが、越境移転の問いは消えません。
中国本土の音声を文字起こしする法令に沿った方法は?
音声を輸出するのではなく、処理を中国国内に留めることです。正直な選択肢は二つ:中国の内側で音声モデルを自前ホストする——Google自身のCloud Speech-to-Text On-Premコンテナ(Googleと取り決めるプライベート機能)や、中国国内のインフラ上で動かすオープンモデル——か、データを本土に留めるライセンスを得た国内の音声サービスに音声を通すこと。その上で、第28条の個別の同意を取得し、PIPIAを実施し、音声を取得する中国向けのアプリを備案・配信(ICP)します。21YunBoxはリスクを整理し、中国国内の経路へ国内化し、中国国内で配信します——そしていかなる種類の不正な手段も用いず、推奨もしません。具体は専門家と確認してください。


