Funktioniert OpenAI Whisper in China? PIPL-Grenztransfer, Stimmabdruck-Biometrie & Datenresidenz
Das Audio, das Sie OpenAI Whisper zum Transkribieren senden, trägt den Stimmabdruck des Sprechers — sensible biometrische personenbezogene Information unter PIPL Artikel 28, die Sie nicht anonymisieren können — sodass es ein grenzüberschreitender Transfer unter PIPL ist, es an OpenAIs Offshore-Hosted-API zu leiten. Weil Whisper zudem ein Open-Source-Modell unter MIT-Lizenz ist, können Sie es innerhalb Chinas selbst hosten. Ein Compliance-orientierter Blick auf den Stimmabdruck-Grenztransfer, die Datenresidenz und den rechtmäßigen inländischen Weg.
Funktioniert OpenAI Whisper in China?
Whisper ist ein Speech-to-Text-Modell, und das Audio, das Sie transkribieren, ist der Stimmabdruck des Sprechers — sensible biometrische personenbezogene Information unter PIPL Artikel 28, die Sie nicht anonymisieren können — die eigentliche Frage ist also, wohin dieser Stimmabdruck und der gesprochene Inhalt gehen, nicht ob der Dienst erreicht werden kann.
Whisper kommt in zwei Formen. OpenAIs gehostete Transkriptions-API (api.openai.com) verarbeitet das Audio auf Offshore-US-Servern — und OpenAI listet Festlandchina nicht unter den Ländern, in denen seine API verfügbar ist — sodass es ein grenzüberschreitender Transfer unter PIPL sensibler biometrischer Daten ist (Artikel 38–40), das Audio von China-Nutzern dorthin zu leiten, der eine gesonderte Einwilligung und einen Transfermechanismus verlangt. Der rechtmäßige Hebel ist, dass Whisper zudem ein Open-Source-Modell unter MIT-Lizenz ist, das Sie auf Ihrer eigenen Infrastruktur innerhalb Chinas selbst hosten können — und so den Stimmabdruck im Festland hält — oder Sie können einen lizenzierten inländischen Sprach-Dienst nutzen, mit der Einwilligung nach Artikel 28 und einer PIPIA an Ort und Stelle. Der Punkt ist, die Verarbeitung von China-Audio im Land zu halten, nicht, eine Offshore-API erreichbar zu machen.
Dies ist eine Risikokarte, kein Urteil — klären Sie die Einzelheiten mit Rechtsbeistand. Unser China-Team kann Ihre Exponierung kartieren →
Compliance-Momentaufnahme
- ✕ OpenAIs gehostete API wird in Festlandchina nicht angeboten; Ihr Audio wird offshore verarbeitet
- ! Eine Aufnahme ist der Stimmabdruck des Sprechers — sensible biometrische Daten unter PIPL Artikel 28
- ! China-Audio an die gehostete API zu senden, ist ein grenzüberschreitender Transfer unter PIPL (Art. 38–40)
- ! Ein Stimmabdruck kann nicht anonymisiert werden; der Export braucht gesonderte Einwilligung und eine PIPIA
- ✓ Rechtmäßiger Weg: das offene MIT-Modell inländisch selbst hosten, plus Einwilligung nach Artikel 28 und ICP
Was die offizielle OpenAI Whisper-Dokumentation über China sagt
| Fakt | Primärquelle |
|---|---|
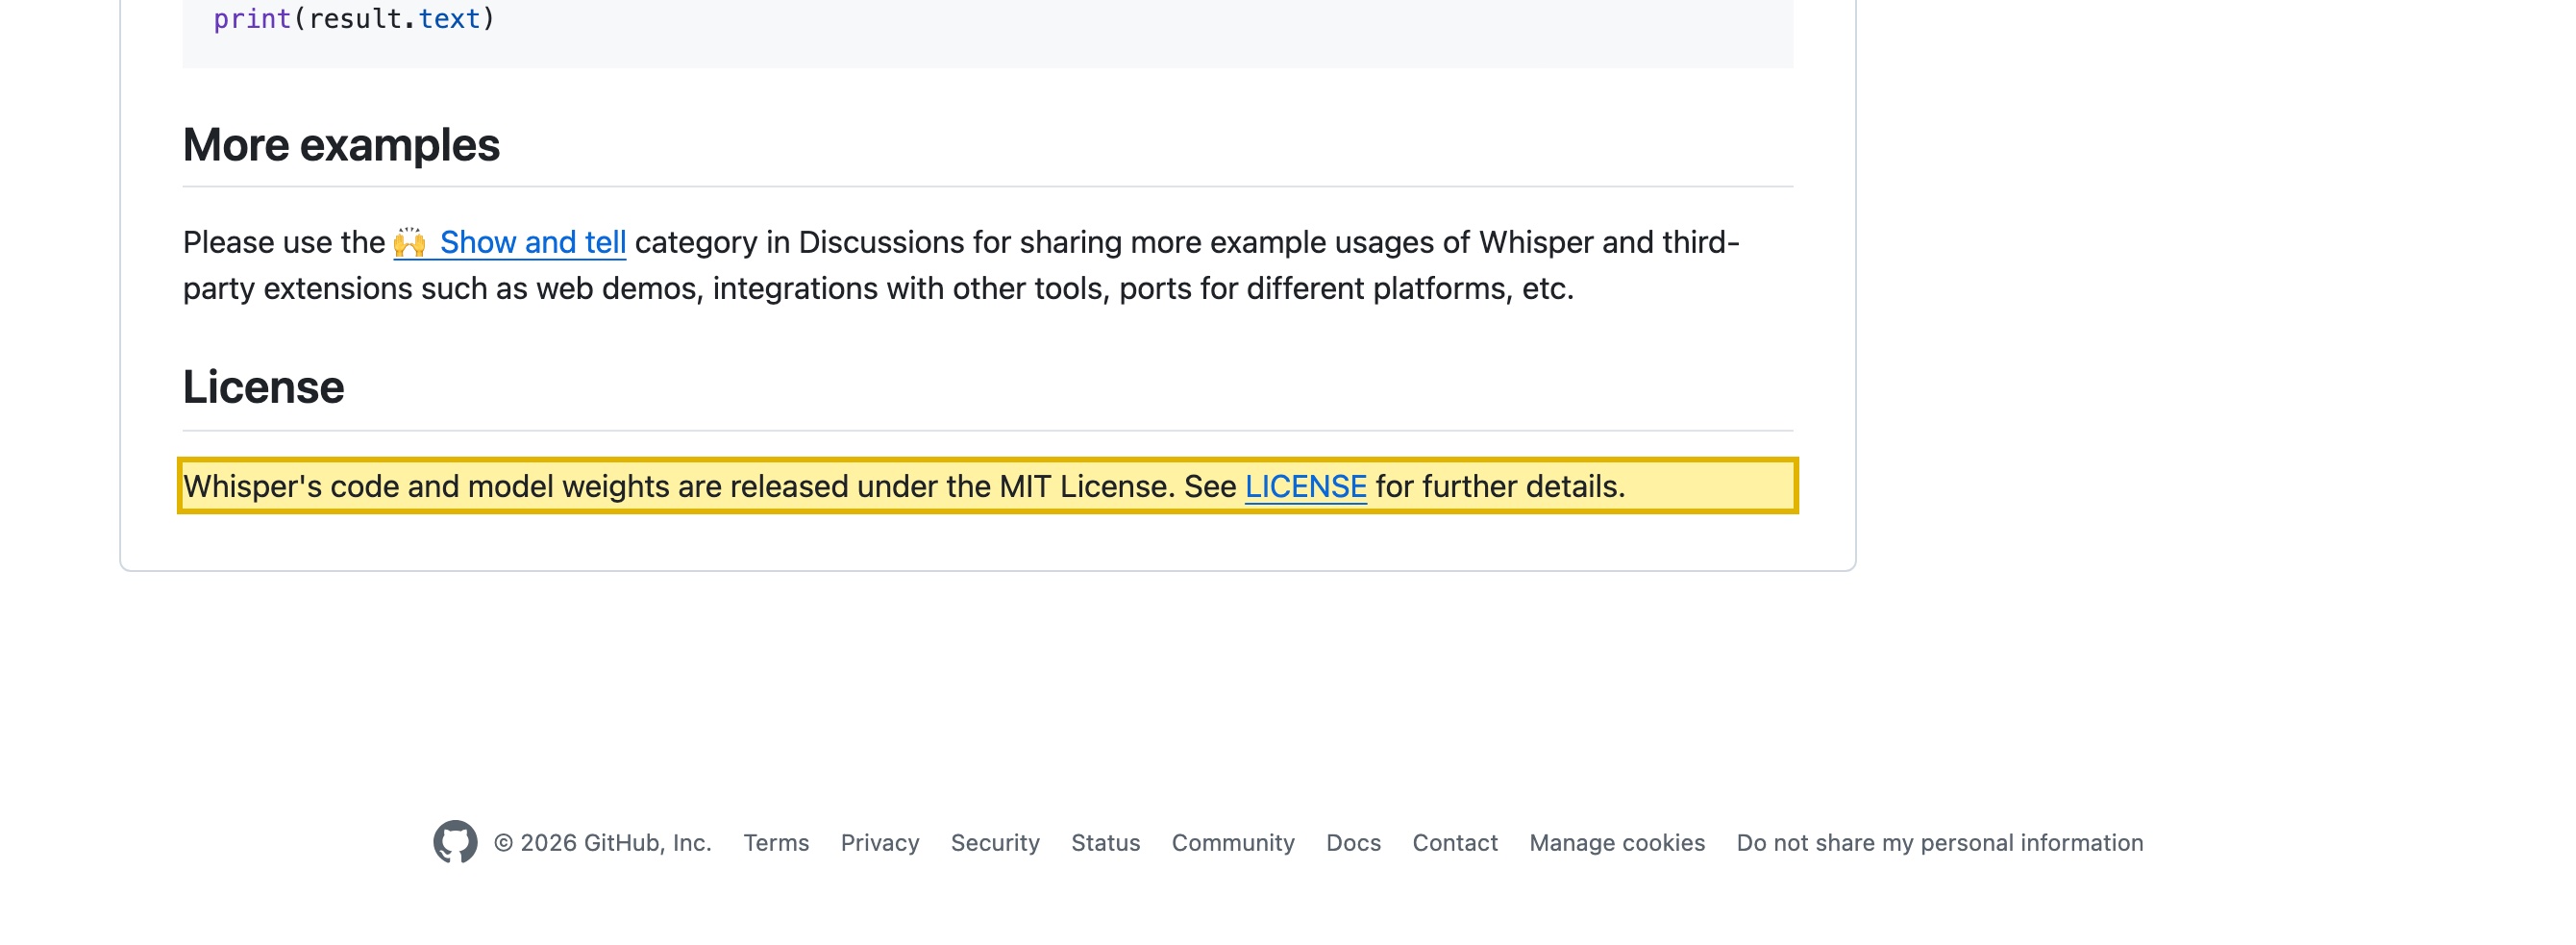
| Whisper ist ein Open-Source-Modell unter MIT-Lizenz, das Sie selbst betreiben können. OpenAIs Repository beschreibt es als „a general-purpose speech recognition model“ und gibt an: „Whisper's code and model weights are released under the MIT License.“ Weil die Gewichte veröffentlicht sind (GitHub und Hugging Face), kann das Modell auf Infrastruktur innerhalb Chinas selbst gehostet werden — eine echte inländische Option, die das Audio und den Stimmabdruck des Sprechers im Festland hält. | OpenAI — Whisper repository README (github.com/openai/whisper), retrieved 2026-10-10 |
| Die gehostete OpenAI-Transkriptions-API läuft offshore, und OpenAIs API wird in Festlandchina nicht angeboten. Die API verarbeitet Audio bei api.openai.com über den /v1/audio/transcriptions-Endpunkt (Modelle einschließlich whisper-1 und gpt-4o-transcribe), und OpenAIs Liste unterstützter Länder enthält Festlandchina nicht. OpenAI gibt an, dass seit dem 1. März 2023 API-Daten nicht zum Training seiner Modelle genutzt werden, sofern Sie sich nicht dafür entscheiden, und dass Missbrauchs-Überwachungs-Logs standardmäßig bis zu 30 Tage aufbewahrt werden. | OpenAI Help Center — API supported countries and territories; OpenAI — Your data (platform.openai.com), retrieved 2026-10-10 |
| Ein Stimmabdruck, der offshore gesendet wird, ist ein grenzüberschreitender Transfer sensibler biometrischer personenbezogener Information. Unter Chinas PIPL aktiviert der Export des Audios eines China-Nutzers die Artikel 38–40 (Mitteilung, eine gesonderte Einwilligung und ein Transfermechanismus), und ein Stimmabdruck ist sensible personenbezogene Information unter Artikel 28 — die eine gesonderte, spezifische Einwilligung und eine vorherige Folgenabschätzung zum Schutz personenbezogener Informationen (PIPIA) verlangt. Eine Aufnahme einer Stimme kann nicht anonymisiert werden. | Personal Information Protection Law of the PRC, Articles 28 and 38–40 (cac.gov.cn), retrieved 2026-10-10 |
| Für einen Betreiber kritischer Informationsinfrastruktur oder Verarbeiter großer Mengen müssen Audio und Transkripte im Land gespeichert werden. Cybersicherheitsgesetz Artikel 39 (vormals Artikel 37) verlangt, dass in China erhobene personenbezogene Informationen für Betreiber kritischer Informationsinfrastruktur im Festland gespeichert werden; die Novelle 2025, in Kraft 1. Januar 2026, nummerierte den Datenlokalisierungs-Artikel von 37 auf 39 um (Inhalt unverändert). Größere Mengen oder sensible Exporte brauchen zudem eine CAC-Datenexport-Sicherheitsbewertung. | Cybersecurity Law of the PRC, Article 39 (formerly Article 37) (cac.gov.cn), retrieved 2026-10-10 |
Quellen vom 21YunBox Compliance-Team am 10. Oktober 2026 geprüft.
Für ein Festlandchina-Publikum ist die zu klärende Frage nach OpenAI Whisper nicht, ob das Modell oder die API erreicht werden kann — es ist, was mit dem Audio geschieht, das Sie ihm senden. Whisper ist ein Speech-to-Text-System: Audio von sprechenden Menschen geht hinein, Text kommt heraus. Und eine Aufnahme der Stimme einer Person ist ihr Stimmabdruck — ein biometrischer Identifikator, den PIPL Artikel 28 als sensible personenbezogene Information behandelt, die Sie nicht anonymisieren können — getragen neben allem, was tatsächlich gesagt wurde: ein Anruf, ein Support-Gespräch, eine diktierte medizinische oder rechtliche Notiz. Whisper kommt in zwei sehr verschiedenen Formen, und die Compliance-Antwort dreht sich darum, welche Sie betreiben. OpenAIs gehostete Transkriptions-API verarbeitet dieses Audio auf Offshore-(US-)Servern; das Open-Source-Whisper-Modell hingegen ist MIT-lizenziert und kann auf Hardware laufen, die Sie kontrollieren, auch innerhalb Chinas. Drei Zinken entscheiden es: ein grenzüberschreitender Transfer personenbezogener Informationen, ein sensibler biometrischer Stimmabdruck unter Artikel 28 und inländische Speicherung, wo ein Betreiber kritischer Informationsinfrastruktur oder Verarbeiter großer Mengen beteiligt ist.
OpenAI Whisper in China auf einen Blick
| Was es entscheidet | In OpenAI Whispers eigenen Worten — und Chinas Recht |
|---|---|
| Was Sie ihm senden | Whisper ist ein Speech-to-Text-Modell: Audio von sprechenden Menschen hinein, ein Transkript heraus. Dieses Audio ist der Stimmabdruck des Sprechers — ein biometrischer Identifikator — zusammen mit allem, was gesagt wurde (Anrufe, Sprachnachrichten, diktierte medizinische oder rechtliche Notizen), häufig für sich allein sensibel. Sie können ein Transkript schwärzen; die Stimme selbst können Sie nicht anonymisieren. |
| Die gehostete API sendet es offshore | OpenAIs gehostete Transkriptions-API (api.openai.com, der /v1/audio/transcriptions-Endpunkt, der Modelle wie whisper-1 und gpt-4o-transcribe bedient) verarbeitet das Audio auf Offshore-(US-)Servern — und OpenAI listet Festlandchina nicht unter den Ländern, in denen seine API verfügbar ist. Das Audio eines China-Nutzers dorthin zu leiten, ist ein grenzüberschreitender Transfer personenbezogener Informationen (数据出境) unter PIPL Artikel 38–40: Mitteilung, eine gesonderte Einwilligung und ein Transfermechanismus (eine CAC-Sicherheitsbewertung, der Standardvertrag oder Zertifizierung). |
| Ein Stimmabdruck ist sensible biometrische Daten | Unter PIPL Artikel 28 ist biometrische Information sensible personenbezogene Information: einen Stimmabdruck zu verarbeiten oder zu exportieren, braucht eine gesonderte, spezifische Einwilligung und eine vorherige Folgenabschätzung zum Schutz personenbezogener Informationen (PIPIA). Gesprochener Inhalt kann weitere sensible Kategorien hinzufügen (Gesundheit, Finanzen, Behörden-ID). Nichts davon kann aus dem Audio weganonymisiert werden. |
| Aufbewahrung, Training und Residenz | Für die gehostete API gibt OpenAI an, dass seit dem 1. März 2023 an die API gesendete Daten nicht zum Training seiner Modelle genutzt werden, sofern Sie sich nicht dafür entscheiden, und dass Missbrauchs-Überwachungs-Logs standardmäßig bis zu 30 Tage aufbewahrt werden (Zero Data Retention ist nur mit vorheriger Genehmigung verfügbar). Getrennt davon kann das Open-Source-Whisper-Modell (MIT-lizenziert, Gewichte auf GitHub und Hugging Face) selbst gehostet werden — es existiert also eine echte inländische Option. Für einen Betreiber kritischer Informationsinfrastruktur oder Verarbeiter großer Mengen ist inländische Speicherung erforderlich unter Cybersicherheitsgesetz Artikel 39 (vormals Artikel 37) — die Cybersicherheitsgesetz-Novelle 2025, in Kraft 1. Januar 2026, nummerierte den Datenlokalisierungs-Artikel von 37 auf 39 um, Inhalt unverändert. |
| Es zu erreichen, ist nicht die Frage — das Audio im Land zu halten, ist es | Die Entscheidung ist nicht, ob das Modell oder die API von China aus erreicht werden kann; sie ist, ob der Stimmabdruck und der gesprochene Inhalt von Menschen in China im Land bleiben, auf einem eingewilligten, rechtmäßigen Weg. Der inländische Hebel ist, das offene Whisper-Modell auf Infrastruktur selbst zu hosten, die Sie innerhalb Chinas betreiben (oder China-Audio über einen lizenzierten inländischen Sprach-Dienst zu leiten), die gesonderte Einwilligung nach Artikel 28 einzuholen und die PIPIA durchzuführen. Die China-zugewandte App, die das Audio erfasst, ist selbst ein Festland-Dienst — sie trägt eine ICP-Beian (备案)-Pflicht und braucht rechtskonforme inländische Auslieferung. |
Was Sie tatsächlich senden — die Stimmabdrücke und Worte Ihrer Sprecher
Whisper ist ein Speech-to-Text-System: Sie reichen ihm eine Aufnahme, und es gibt Text zurück. Die nützliche Art, die Compliance-Exponierung zu sehen, ist, darauf zu schauen, was die Aufnahme ist. Sie ist erstens der Stimmabdruck des Sprechers — das akustische Muster einer bestimmten menschlichen Stimme, ein biometrischer Identifikator dieser Person — und zweitens der gesprochene Inhalt: die Worte eines Verkaufsgesprächs, eines Support-Gesprächs, einer Sprachnachricht, einer diktierten klinischen oder rechtlichen Notiz. Beide reisen bei jeder Anfrage zusammen, und beide beschreiben identifizierbare Menschen.
Zwei sehr verschiedene Dinge tragen den Namen Whisper, und die Compliance-Antwort hängt davon ab, welches Sie betreiben:
- Das Open-Source-Modell — Whispers Code und Gewichte sind unter der MIT-Lizenz auf GitHub und Hugging Face veröffentlicht. Sie installieren es und betreiben es auf Hardware Ihrer Wahl, in jedem Land, einschließlich Ihrer eigenen Server innerhalb Chinas. Das Audio muss Ihre Umgebung nie verlassen.
- Die gehostete OpenAI-Transkriptions-API — Ihre Anwendung lädt Audio zu
api.openai.comhoch (der/v1/audio/transcriptions-Endpunkt, der Modelle wiewhisper-1undgpt-4o-transcribebedient) und erhält ein Transkript zurück. OpenAI verarbeitet dieses Audio auf seiner Offshore-(US-)Infrastruktur, und OpenAI listet Festlandchina nicht unter den Ländern und Territorien, in denen seine API verfügbar ist. Für den gehosteten Weg gibt OpenAI an, dass seit dem 1. März 2023 an die API gesendete Daten nicht zum Training seiner Modelle genutzt werden, sofern Sie sich nicht dafür entscheiden, und dass Missbrauchs-Überwachungs-Logs standardmäßig bis zu 30 Tage aufbewahrt werden (Zero Data Retention ist nur mit vorheriger Genehmigung verfügbar).
Eine ehrliche Klarstellung zur Achse: Whisper transkribiert; es synthetisiert oder klont keine Stimmen. Die Deep-Synthesis- und Generative-KI-Melde-Pflichten, die an Stimm-Generierungs-Diensten anhängen, entstehen für Whisper selbst also nicht. Die Exponierung hier ist klar der Live-Grenztransfer eines biometrischen Identifikators und sensiblen Inhalts auf dem gehosteten Weg — nicht generierte Ausgabe.
Es ist ein grenzüberschreitender Transfer sensibler biometrischer Daten — unter PIPL
Wählen Sie die gehostete API für Nutzer in China, und Sie haben eine Leitung gebaut, die ihre Stimmen aus dem Land verschifft. Das ist ein grenzüberschreitender Transfer personenbezogener Informationen (数据出境) unter Chinas Gesetz zum Schutz personenbezogener Informationen, und die Pflicht sitzt bei Ihnen als Verarbeiter, nicht beim Anbieter. PIPL Artikel 38–40 verlangen Mitteilung, eine gesonderte Einwilligung, getrennt von der Zustimmung des Nutzers zur Nutzung der Funktion, und einen rechtmäßigen Transfermechanismus — eine CAC-Sicherheitsbewertung, den CAC-Standardvertrag oder Zertifizierung.
Das Audio hebt auch die Sensibilitäts-Latte, und das ist der Teil, der einen Sprach-Dienst von einem gewöhnlichen Inhalts-Export unterscheidet. Ein Stimmabdruck ist biometrische Information, die PIPL Artikel 28 als sensible personenbezogene Information klassifiziert — eine Kategorie, die eine gesonderte, spezifische Einwilligung und eine vorherige Folgenabschätzung zum Schutz personenbezogener Informationen (PIPIA) verlangt, bevor die Daten verarbeitet oder transferiert werden. Der gesprochene Inhalt kann weitere eigene sensible Kategorien hereinziehen (Gesundheit, Finanzen, Behörden-ID). Und anders als ein Transkript, das Sie schwärzen können, kann eine Aufnahme einer Stimme nicht anonymisiert werden: Der Identifikator ist das Audio, es zu entfernen vereitelt also den Zweck, es zu senden.
Unter der Einwilligung sitzt Residenz. Ein Betreiber kritischer Informationsinfrastruktur oder Verarbeiter großer Mengen muss in China erhobene personenbezogene Informationen im Festland speichern — PIPL Artikel 40 zusammen mit Cybersicherheitsgesetz Artikel 39 (vormals Artikel 37) — eine Pflicht, die eine Offshore-API strukturell nicht erfüllen kann, und wo Volumina oder Sensibilität die Schwellen überschreiten, braucht der Export selbst eine CAC-Datenexport-Sicherheitsbewertung, bevor er fortfahren darf.
Die API zu erreichen, ist nicht die Frage — das Audio im Land zu halten, ist es
Ob ein Endpunkt aus Shanghai antwortet, ist nicht die Entscheidung. Die Entscheidung ist, ob die Stimmabdrücke und Worte von Menschen in China im Land bleiben, auf einem eingewilligten, rechtmäßigen Fundament. Für Whisper hat die ehrliche Antwort eine bessere Form, als die meisten ausländischen Sprach-Dienste bieten können, denn das Modell ist offen.
Der stärkste inländische Hebel ist, das Open-Source-Whisper-Modell auf Infrastruktur selbst zu hosten, die Sie innerhalb Chinas betreiben. Weil die Gewichte MIT-lizenziert und veröffentlicht sind, können Sie vollständig innerhalb des Festlands transkribieren — das Audio und der Stimmabdruck überqueren nie die Grenze, der Grenz-Zinken fällt also weg, und Residenz ist konzeptbedingt erfüllt. Wo Sie das Modell lieber nicht selbst betreiben, ist die Alternative ein lizenzierter inländischer Sprach-Dienst, der die Daten im Land hält. So oder so holen Sie weiterhin die gesonderte Einwilligung nach Artikel 28 ein, führen die PIPIA durch und minimieren, was Sie erheben und behalten. Was dies nicht ist, ist eine Regelung, die das Audio eines China-Nutzers dennoch an die Offshore-API leitet, während sie es als lokal darstellt — die Verarbeitung wirklich im Land zu halten, ist der ganze Punkt.
Diese Seite ist eine Risikokarte, kein Urteil: Was Ihr Produkt tatsächlich mit dem Audio tut, entscheidet, welche Pflichten beißen und wie weit sie reichen, klären Sie die Einzelheiten also mit Rechtsbeistand, bevor Sie bauen.
Der rechtmäßige Weg — kartieren, lokalisieren, ausliefern
Es gibt einen rechtmäßigen Weg, Transkription für Ihre Nutzer in China zu betreiben, und er hat eine klare Form: Die Verarbeitung des Audios bleibt innerhalb des Landes, auf einem eingewilligten Weg, und die China-zugewandte App, die es erfasst, ist selbst gemeldet und inländisch ausgeliefert. Der Teil, den 21YunBox besitzt, ist dieses Fundament, und es ist mehr als Beratung. Unser China-Team tut drei Dinge. Wir kartieren, welches Audio zum Sprach-Dienst fließt — wessen Stimmabdrücke und welchen gesprochenen Inhalt es trägt, wo es verarbeitet und aufbewahrt würde und wo Ihnen eine rechtmäßige Grundlage fehlt (die gesonderte Einwilligung nach Artikel 28 und die PIPIA; ein Transfermechanismus). Wir lokalisieren die Verarbeitung im Land: stellen das Open-Source-Whisper-Modell auf Infrastruktur innerhalb Chinas auf, sodass der Stimmabdruck nie das Festland verlässt, oder integrieren einen lizenzierten inländischen Sprach-Dienst, wo Sie das Modell lieber nicht selbst betreiben — anstelle eines Aufrufs, der sonst das Audio an eine Offshore-API verschiffen würde — mit der Einwilligung nach Artikel 28 eingeholt und der Offshore-Aufbewahrung deaktiviert. Und wir liefern die China-zugewandte App oder Funktion, die das Audio erfasst, inländisch auf ICP-gemeldeter Infrastruktur aus — den 21YunBox Optimizer — vor dem, was Sie bereits betreiben, ohne Neuaufbau und ohne Re-Plattformierung.
Das Ergebnis ist eine Transkriptions-Funktion, die für Ihre Nutzer in China rechtlich und rechtskonform läuft. 21YunBox nutzt oder empfiehlt niemals irgendeine Form der Umgehung: Dies ist eine rechtmäßige, inländische Bereitstellung, gebaut auf einem offenen Modell, das Sie betreiben dürfen, und auf lizenzierter inländischer Infrastruktur, kein Weg um irgendjemandes Bedingungen herum.
Compliance-Einschätzung anfordern →
Weiterführende Lektüre:
- Grenzüberschreitende Datentransfers unter PIPL
- Chinas Cybersicherheitsgesetz — Artikel 39 (vormals Artikel 37) und Datenlokalisierung
- Chinas Maßnahmen zur Datenexport-Sicherheitsbewertung
- Wie Sie eine ICP-Beian für China erhalten
Häufige Fragen
Ist OpenAI Whisper in Festlandchina verfügbar?
Unterscheiden Sie die zwei Whisper. Das Open-Source-Whisper-Modell (MIT-lizenziert) kann überall heruntergeladen und betrieben werden, auch auf Ihren eigenen Servern innerhalb Chinas. OpenAIs gehostete Transkriptions-API ist anders: OpenAI listet Festlandchina nicht unter den Ländern und Territorien, in denen seine API verfügbar ist, und es verarbeitet Audio auf Offshore-US-Servern. Der ehrliche, rechtmäßige inländische Weg ist also, das offene Modell selbst zu hosten (oder einen lizenzierten inländischen Sprach-Dienst zu nutzen), nicht, die Offshore-API zu erreichen. 21YunBox nutzt oder empfiehlt niemals irgendeine Form der Umgehung.
Warum ist das Senden von Audio an Whispers gehostete API ein PIPL-Problem?
Weil das Audio personenbezogene Information ist — und insbesondere sensibel. Eine Aufnahme trägt den Stimmabdruck des Sprechers, der biometrische Daten und daher sensible personenbezogene Information unter PIPL Artikel 28 ist, plus alles, was gesagt wurde (oft für sich allein sensibel). Das Audio eines China-Nutzers an die Offshore-API zu senden, ist ein grenzüberschreitender Transfer unter PIPL Artikel 38–40 (Mitteilung, eine gesonderte Einwilligung und ein Transfermechanismus), und die Latte des Artikels 28 fügt eine gesonderte spezifische Einwilligung und eine PIPIA hinzu. Eine Aufnahme einer Stimme kann nicht anonymisiert werden, Sie können den Identifikator also nicht entfernen und die Funktion behalten. Bestätigen Sie Ihre genauen Pflichten mit Rechtsbeistand.
Was ist der rechtskonforme, inländische Weg für Transkription in China?
Halten Sie die Verarbeitung des Audios innerhalb des Festlands. Weil Whisper Open-Source und MIT-lizenziert ist, können Sie das Modell auf inländischer Infrastruktur selbst hosten, sodass der Stimmabdruck und der gesprochene Inhalt China nie verlassen; wo Sie das Modell lieber nicht selbst betreiben, leiten Sie China-Audio über einen lizenzierten inländischen Sprach-Dienst. Paaren Sie das mit der gesonderten Einwilligung nach Artikel 28 und einer PIPIA, deaktivieren Sie jede Offshore-Aufbewahrung und melden und liefern Sie die China-zugewandte App aus, die das Audio erfasst (ICP-Beian plus inländische Auslieferung). 21YunBox kartiert die Exponierung, lokalisiert auf den inländischen Weg und liefert ihn aus — kein Neuaufbau. Es ist eine rechtmäßige inländische Bereitstellung, kein Weg um irgendjemandes Bedingungen herum.


